Selecione a API que você usa para entender como ela mede o uso e conhecer formas de gerenciar os custos do seu aplicativo de voz.
Uso e custos do GPT-Live
O GPT-Live separa a conversa por voz do backend responsável pelo raciocínio e pela execução das ferramentas. Estime os dois custos separadamente. O custo da sessão de voz depende da duração, enquanto o custo do backend depende dos modelos e das ferramentas que você usa.
Custos da sessão de voz
As sessões de voz do GPT-Live são cobradas por segundo, de acordo com a tarifa vigente do modelo. A duração da sessão não é arredondada para o minuto inteiro seguinte.
O tempo de sessão ativa inclui os períodos em que o usuário fala, o assistente fala, ambos ficam em silêncio ou o backend está processando uma tarefa.
Para fazer estimativas, conte o tempo de sessão ativa do início ao encerramento. Use a duração informada pela API em vez de cronometrar apenas o áudio reproduzido pelo aplicativo. Silenciar o microfone não encerra a sessão. Quando a conversa terminar, encerre a sessão e registre os dados finais de uso.
Consulte os preços da API para saber quanto custam os modelos e as ferramentas do backend.
Cobrança pela inicialização de sessões WebRTC
Ao criar uma sessão WebRTC com uma solicitação POST /v1/live/sessions, você paga por 15 segundos de voz durante a inicialização. Quando a sessão começa a funcionar, o valor já cobrado é descontado da cobrança pela duração. Ao estimar o custo, não acrescente mais 15 segundos à duração da sessão em execução.
Por exemplo, a sessão de 90 segundos abaixo já inclui os 15 segundos cobrados na inicialização. A cobrança corresponde a 90 segundos, e não a 105. Leve em conta a cobrança pela criação de sessões ao avaliar reconexões ou aplicativos que criam sessões antes que o usuário esteja pronto para falar.
Custos do backend
As chamadas feitas pelo backend são cobradas separadamente da sessão de voz, assim como nos aplicativos sem voz. Inclua os tokens de entrada e de saída do modelo, os tokens de entrada em cache quando houver suporte e as cobranças aplicáveis pelo uso de imagens ou ferramentas. Se o aplicativo chamar outros serviços, inclua esses custos na estimativa.
Você pode otimizar o processamento no backend independentemente da interface de voz. Consulte o guia de otimização de custos para reduzir o número de solicitações e o consumo de tokens. Nos modelos de backend compatíveis, aproveite o cache de prompts mantendo as instruções reutilizáveis, as definições de ferramentas e outros conteúdos que não mudam no início do prompt.
As escolhas que você faz no backend também podem alterar a duração da conversa. Compare o custo total quando uma otimização aumentar o tempo de espera do usuário ou afetar a confiabilidade do assistente na execução da tarefa.
Como estimar o custo de uma conversa
Para uma conversa com uma única sessão de voz, use a fórmula abaixo.
Custo total = (segundos de voz faturáveis ÷ 60 × tarifa de voz por minuto) + custos do backend
Por exemplo, com uma tarifa hipotética de US$ 0,05 por minuto, uma sessão de voz de 90 segundos custa US$ 0,075. Se o custo do modelo e das ferramentas no backend somar US$ 0,02, a conversa custará US$ 0,095.
| Componente | Cálculo | Custo |
|---|---|---|
| Sessão de voz | 90 segundos ÷ 60 × US$ 0,05 | US$ 0,075 |
| Processamento no backend | Custo total do modelo e das ferramentas | US$ 0,02 |
| Total da conversa | US$ 0,075 + US$ 0,02 | US$ 0,095 |
A tarifa e o custo do backend acima são exemplos. Use a tarifa de voz vigente, o uso medido no backend e as tarifas aplicáveis aos modelos e às ferramentas. Se a tarefa envolver várias sessões de voz, some as durações e inclua o processamento realizado no backend entre as sessões.
Estratégias de otimização
Ajude o usuário a concluir a tarefa com menos tempo de espera e sem prolongar a conversa desnecessariamente. Mantenha as confirmações e verificações que a tarefa exige.
Forneça contexto relevante antes da sessão
Antes de iniciar a sessão de voz, reúna as informações que o aplicativo já tem permissão para usar. Por exemplo, um assistente que ajuda o usuário com um pedido pode começar a conversa já sabendo o número e a situação atual do pedido. Assim, o usuário não precisa repetir essas informações nem esperar por outra consulta.
Mantenha o contexto atualizado e restrito ao que importa para a tarefa. Forneça ao modelo de voz as informações necessárias para a conversa e mantenha os registros detalhados e os fluxos de trabalho no backend. Consulte Configuração da sessão e Delegação e ferramentas.
Reduza o tempo de espera pelas ferramentas
Reduzir a espera pode melhorar a experiência do usuário e diminuir o custo da sessão de voz. Por exemplo, suponha que o backend use gpt-5.6-luna no modo Fast e execute em paralelo as chamadas independentes a ferramentas. Se essas otimizações permitirem que o usuário conclua a tarefa e encerre a sessão de voz um minuto antes, você economizará US$ 0,05 em tarifas de voz. O custo total cairá se o custo adicional do backend for menor que essa economia.
Você também pode iniciar uma consulta especulativa a partir de trechos da transcrição antes de receber um evento de delegação. Ao medir o custo do backend, inclua também as consultas especulativas cujos resultados não foram usados.
Consulte Como reduzir a latência do backend para otimizar modelos, conexões, streaming e ferramentas. Use avaliações de agentes de voz para verificar quanto tempo o usuário espera por uma resposta de voz útil e se a tarefa é concluída com sucesso.
Encerre a sessão durante tarefas demoradas
A interface de voz e o backend gerenciado pelo aplicativo podem funcionar de forma independente. Com a delegação ao cliente, o processo de trabalho do backend pode continuar em execução tanto com a sessão de voz aberta quanto após seu encerramento. Salve o estado da tarefa e o contexto da conversa antes de encerrar a sessão de voz.
Para configurar o tempo limite de inatividade, definir o que aciona o reinício e restaurar o contexto, consulte Como encerrar sessões ociosas e retomar a conversa.
No caso de um agente que fica disponível em segundo plano, encerre a sessão de voz enquanto o backend executa uma tarefa demorada, como programar no modo Meta. Ofereça um botão Retomar conversa para iniciar uma nova sessão de voz quando o usuário voltar. Outra opção é usar um evento de conclusão do backend para iniciar uma nova sessão e avisar o usuário de que o resultado está pronto.
Para restaurar a conversa, inicie uma nova sessão e inclua o contexto salvo e o resultado verificado da tarefa em input. Por exemplo, envie o evento de inicialização abaixo por uma nova conexão WebSocket.
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Aguarde o evento session.started antes de começar a transmitir áudio. Consulte Como iniciar uma sessão com o histórico de uma conversa para conhecer o formato de histórico aceito.
Se a sessão anterior tiver sido armazenada com store: true, você também poderá criar um fork dessa sessão. Em ambos os casos, mantenha no aplicativo o estado verificado da tarefa executada no backend.
Encerrar a sessão economiza US$ 0,05 por minuto de inatividade da sessão de voz. Compare essa economia com o custo da reconexão e considere o impacto da interrupção na experiência do usuário.
Escolha o modelo adequado para o backend
Comece pelos modelos que atendem aos requisitos de precisão e confiabilidade da tarefa. Em seguida, compare o custo total da conversa, incluindo a duração da sessão de voz, o uso do modelo, as chamadas a ferramentas e as novas tentativas. O guia de seleção de modelos explica como ponderar esses fatores.
Um modelo maior no backend pode ter um custo total menor se concluir a tarefa mais rápido e a economia na sessão de voz superar o custo adicional dos tokens. Um modelo mais barato pode sair mais caro no total se demorar mais, repetir chamadas a ferramentas ou não conseguir concluir a tarefa.
Compare o custo por tarefa concluída com sucesso, a taxa de conclusão e o tempo necessário para concluir a tarefa. Inclua as tentativas que falharam e as novas tentativas no total para que uma configuração mais barata não pareça melhor só porque conclui menos tarefas. Ao planejar a comparação, consulte o exemplo de avaliação de agentes de voz do Cookbook.
Monitore o uso real
Registre separadamente a duração da sessão de voz e o uso do backend em cada sessão. O GPT-Live informa a duração acumulada da sessão de voz em segundos.
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Cada atualização substitui a medição anterior da duração. Não some as medições. Depois de enviar session.close, continue recebendo eventos até receber session.closed e registre uma única vez o valor final de usage.seconds desse evento. Siga o procedimento de encerramento para que o aplicativo possa coletar os dados finais de uso antes de se desconectar.
Na delegação à API Responses, leia o campo usage da resposta do backend nos eventos response.completed aninhados que chegam por meio de response.event. Use o ID da resposta para contabilizar cada resposta do backend uma única vez. Guarde os dados dos tokens de entrada, de saída e em cache necessários para aplicar as tarifas do modelo. Se o aplicativo executar tarefas no backend de forma independente, colete também os dados de uso dessas solicitações.
Compare os totais estimados com os reais em conversas representativas. Contabilize as chamadas ao modelo feitas exclusivamente para avaliação separadamente do uso do aplicativo e analise o custo junto com o sucesso na execução das tarefas.
Custos da Realtime API
Este documento explica como funciona a cobrança da Realtime API e apresenta estratégias para otimizar os custos. As sessões de agentes de voz acumulam tokens de entrada e de saída nas modalidades de texto, áudio e imagem. As sessões de tradução e de transcrição por streaming são cobradas pela duração do áudio. Os preços variam de acordo com o modelo e estão disponíveis nas respectivas páginas, como as de gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper e gpt-realtime.
As sessões de conversa da Realtime API consistem em uma sequência de turnos. Em cada turno, o usuário envia uma entrada que aciona uma resposta para gerar a saída do modelo. O servidor mantém uma conversa, ou seja, uma lista de itens que compõem a entrada do próximo turno. Quando a resposta é retornada, a saída é adicionada automaticamente à conversa.
As sessões de tradução e transcrição usam uma arquitetura de streaming diferente. O cliente transmite áudio continuamente e, à medida que o áudio de origem chega, recebe áudio traduzido, atualizações incrementais da transcrição ou eventos de transcrição. Essas sessões não seguem o ciclo de vida normal de uma resposta. Para estimar e monitorar os custos, use as tarifas por duração em vez do consumo de tokens por resposta.
Custos por resposta
Na Realtime API, cada resposta criada gera uma cobrança com base no número de tokens de entrada e de saída. A exceção é o custo da transcrição da entrada, explicado abaixo. Atualmente, não há cobrança pela largura de banda de rede nem pelas conexões. Você pode criar uma resposta manualmente ou, se a detecção de atividade de voz (VAD) estiver ativada, deixar que ela seja criada automaticamente. A VAD filtra os trechos de áudio de entrada sem fala. Esses trechos só contam como tokens de entrada se o cliente os adicionar manualmente à conversa.
A cada resposta, a conversa inteira é enviada ao modelo. A saída de cada turno é adicionada como itens à conversa no servidor e passa a fazer parte da entrada dos turnos seguintes. Por isso, os turnos posteriores da sessão custam mais.
Você pode estimar o custo dos tokens de texto com nossas ferramentas de tokenização. Nas mensagens do usuário, cada 100 ms de áudio correspondem a 1 token de áudio. Nas mensagens do assistente, cada 50 ms correspondem a 1 token de áudio. Além do conteúdo da mensagem, a contagem inclui tokens especiais, o que gera pequenas variações. Por exemplo, uma mensagem do usuário com 10 tokens de texto no conteúdo pode contabilizar 12 tokens.
Exemplo
Veja como calcular o custo dos tokens em uma sessão da Realtime API com vários turnos.
No primeiro turno da conversa, adicionamos 100 tokens de instruções e uma mensagem do usuário com 20 tokens de áudio, totalizando 120 tokens de entrada. A mensagem pode, por exemplo, ter sido adicionada pela VAD ao detectar a fala do usuário. Ao criar a resposta, o modelo gera uma mensagem do assistente com 20 tokens de áudio e 10 de texto.
Em seguida, iniciamos um segundo turno com outra mensagem de áudio do usuário. Quantos tokens serão contabilizados no turno 2? Nesse momento, a conversa contém as instruções iniciais, a primeira mensagem do usuário, a mensagem gerada pelo assistente no primeiro turno e a segunda mensagem do usuário (25 tokens de áudio). Esse turno terá 110 tokens de texto e 64 de áudio na entrada, além dos tokens de saída da nova mensagem do assistente.
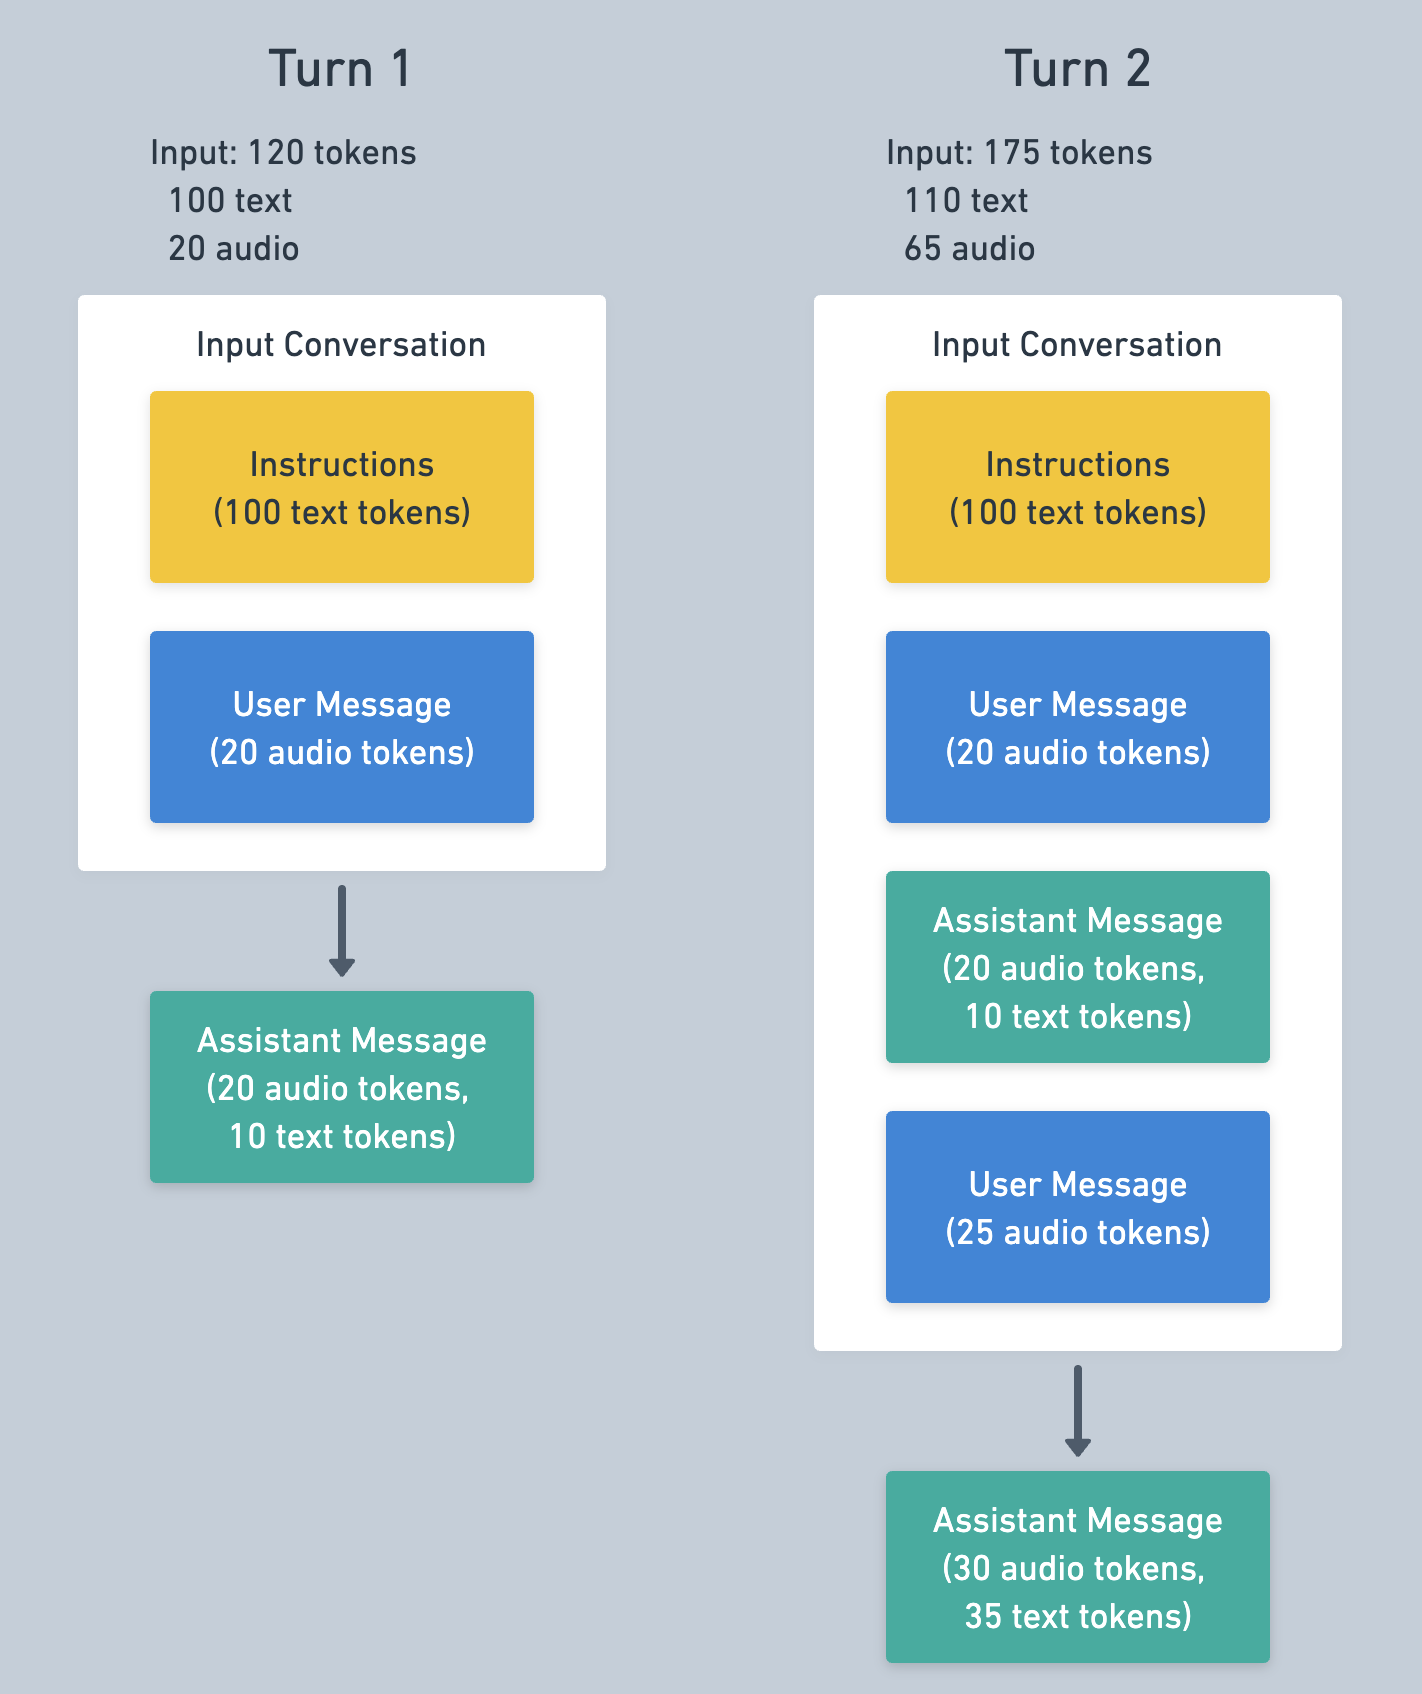
É provável que as mensagens do primeiro turno já estejam em cache no turno 2, o que reduz o custo da entrada. Veja mais detalhes sobre o cache abaixo.
O evento response.done informa quantos tokens foram usados em uma resposta, como no exemplo a seguir.
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Custos da transcrição de entrada
Quando a transcrição de entrada está ativada, a Realtime API a cobra separadamente. A transcrição usa um modelo e uma tabela de preços diferentes dos usados pelo modelo de fala para fala. Use gpt-transcribe para a transcrição de um turno confirmado. A transcrição começa depois que o áudio é gravado no buffer de áudio de entrada e o conteúdo do buffer é confirmado.
Consulte os dados de uso da transcrição de entrada no evento conversation.item.input_audio_transcription.completed. Os campos de uso dependem do modelo de transcrição. O gpt-transcribe é cobrado pela duração do áudio, enquanto os modelos cobrados por token retornam a contagem de tokens. No caso da cobrança por duração, os dados de uso têm o formato abaixo.
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}Cache
A Realtime API aplica o cache de prompts automaticamente, o que pode reduzir bastante o custo dos tokens de entrada em sessões com vários turnos. O cache pode ser aproveitado quando os tokens de entrada de uma resposta coincidem com os de uma resposta anterior, mas o reaproveitamento não é garantido.
A melhor maneira de aproveitar ao máximo o cache é manter o histórico da sessão sem alterações. Ao remover ou modificar conteúdo da conversa, você reduz o trecho da entrada que ainda coincide com o histórico em cache. Só é possível reaproveitar o trecho anterior à alteração. Como as instruções e as definições de ferramentas ficam no início da conversa, alterá-las durante a sessão reduz o aproveitamento do cache nos turnos seguintes.
Truncamento
Quando a conversa ultrapassa o limite de tokens de entrada do modelo, ela é truncada. Isso significa que mensagens são removidas da entrada da resposta, começando pelas mais antigas. Um modelo com janela de contexto de 32 mil tokens e saída máxima de 4.096 tokens pode incluir até 28.224 tokens no contexto antes do truncamento.
O cliente pode definir uma janela de tokens menor que o máximo do modelo para controlar o consumo e o custo dos tokens. Use a configuração token_limits.post_instructions para definir esse limite se você configurar o truncamento com o tipo retention_ratio, como no exemplo abaixo. Como o nome indica, esse limite determina o número máximo de tokens de entrada por resposta, sem contar os tokens das instruções. Se você definir post_instructions como 1.000, os itens que excederem o limite de 1.000 tokens de entrada não serão enviados ao modelo para gerar a resposta.
O truncamento invalida o cache perto do início da conversa. Se ocorrer a cada turno, o aproveitamento do cache será muito baixo. Para evitar isso, o cliente pode configurar o truncamento para remover mais mensagens do que o estritamente necessário. Assim, haverá mais espaço para novas mensagens antes do próximo truncamento. Use session.truncation.retention_ratio para controlar quanto conteúdo será mantido. O valor padrão no servidor é 1.0, que remove apenas os itens necessários. Com o valor 0.8, o truncamento mantém 80% do limite máximo e descarta 20% adicionais.
Para reduzir o custo por sessão da Realtime API com um determinado modelo, recomendamos diminuir o limite de tokens e definir retention_ratio como um valor menor que 1, como no exemplo abaixo. Considere que o custo menor pode deixar o modelo com menos histórico disponível em um determinado turno.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}Você também pode desativar completamente o truncamento, como no exemplo abaixo. Nesse caso, se a conversa for longa demais para gerar uma resposta, o servidor retornará um erro. Essa opção pode ser útil se você quiser gerenciar o tamanho da conversa manualmente.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Outras estratégias de otimização
Use um modelo mini
Os modelos Realtime de fala para fala têm uma versão padrão e uma versão mini, que custa bem menos. A principal diferença costuma estar na capacidade do modelo de seguir instruções e fazer chamadas de função. O modelo mini tende a ser menos eficaz nessas tarefas. Recomendamos testar o aplicativo primeiro com o modelo maior, refinar o aplicativo e o prompt e só então tentar otimizar os custos com o modelo mini.
Edite a conversa
Embora o servidor faça o truncamento automaticamente, você também pode gerenciar os custos editando a conversa manualmente. A API foi projetada para dar ao cliente controle total sobre a conversa mantida no servidor, permitindo adicionar ou remover itens conforme necessário.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Remover mensagens antigas reduz o número de tokens de entrada e o custo. Como isso pode eliminar conteúdo importante, uma estratégia comum é substituir essas mensagens por um resumo. Para excluir itens da conversa, envie uma mensagem conversation.item.delete, como no exemplo acima. Para adicionar itens, envie uma mensagem conversation.item.create.
Como estimar os custos
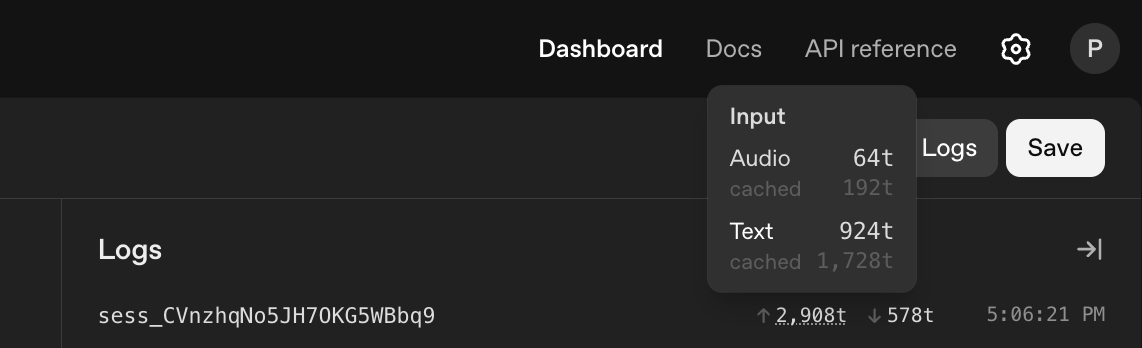
Como o consumo de tokens da Realtime API depende de vários fatores, pode ser difícil estimar os custos com antecedência. Uma boa abordagem é testar no Realtime Playground os prompts e as funções que você pretende usar e medir o consumo de tokens em uma sessão de exemplo. Na aba Logs do Realtime Playground, você encontra o consumo de tokens ao lado do ID da sessão.