
Em setembro de 2025, a OpenAI apresentou o GPT-5-Codex, a primeira versão do GPT-5 otimizada para programação agêntica. Em dezembro de 2025, lançamos a versão 5.2. Foi aí que as pessoas começaram a acreditar que podiam confiar em agentes autônomos de programação. Em particular, vimos um salto no tempo durante o qual o modelo conseguia seguir instruções de forma confiável.
Eu queria testar esse limite. Dei ao Codex um repositório vazio, acesso completo e uma única tarefa: criar uma ferramenta de design do zero. Deixei o Codex trabalhar com o GPT-5.3-Codex no nível de raciocínio “Extra alto”. O Codex trabalhou por cerca de 25 horas sem interrupção, consumiu aproximadamente 13 milhões de tokens e gerou cerca de 30 mil linhas de código.
Foi um experimento, sem implantação em produção. Ainda assim, o Codex se saiu bem no que importa em tarefas de longa duração: seguiu a especificação, manteve o foco, executou verificações e corrigiu as falhas à medida que surgiam.

Como é uma sessão de longa duração com o Codex
Pedi ao Codex que gerasse uma página com um resumo dos dados da sessão:

Veja também as estatísticas da sessão na CLI e o consumo de tokens:

Essas capturas de tela ajudam a visualizar a principal mudança: na programação agêntica, além do desempenho em tarefas one-shot, importa cada vez mais o horizonte temporal.
A grande mudança está no horizonte temporal
Dizer que “os modelos ficaram mais inteligentes” só explica parte da mudança. Na prática, os agentes conseguem manter a coerência por mais tempo, executar etapas maiores do início ao fim e se recuperar de erros sem perder o fio da tarefa.
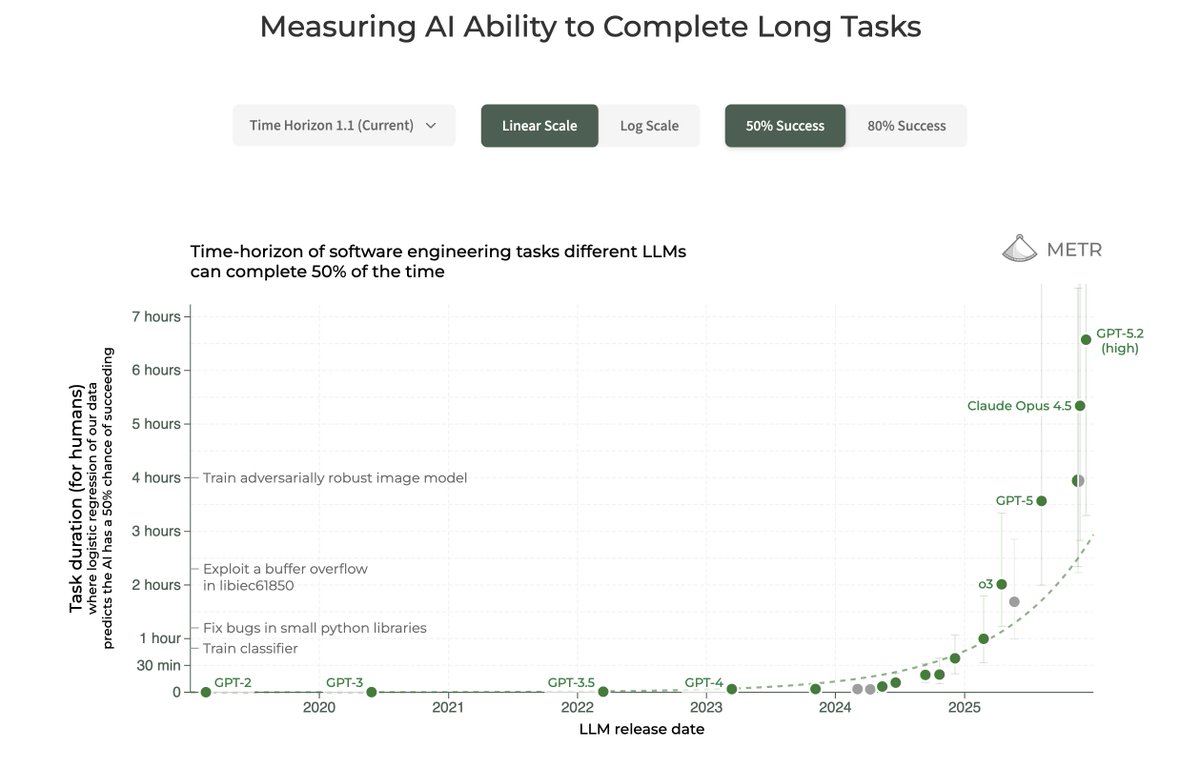
Os estudos da METR sobre benchmarks de horizonte temporal ajudam a entender essa tendência. A duração das tarefas de software que os agentes de fronteira conseguem concluir com taxas de sucesso de cerca de 50% e de 80% vem aumentando rapidamente e dobra aproximadamente a cada sete meses. Veja Como medir a capacidade da IA de concluir tarefas longas (METR).
No recente anúncio de lançamento do GPT-5.3-Codex, destacamos dois avanços práticos para o trabalho com agentes:
- O modelo executa melhor as tarefas com várias etapas (planejar → implementar → validar → corrigir).
- Ficou mais fácil orientar o modelo durante a execução sem reiniciar a tarefa inteira (os ajustes de rumo preservam o progresso).
Também me inspirei no que a equipe do Cursor escreveu sobre sistemas autônomos de programação que trabalham por longos períodos, inclusive no experimento em que criou um navegador: Como o Cursor criou um navegador (agentes em escala).
A equipe do Cursor escreveu que os modelos da OpenAI são “muito melhores em trabalhos autônomos de longa duração: seguem as instruções, mantêm o foco, evitam desvios e implementam o que foi pedido com precisão e por completo”.
Por que o Codex consegue manter a coerência em tarefas longas
O trabalho de longa duração depende menos de um único prompt enorme e mais do ciclo em que o modelo opera como agente.
No Codex, esse ciclo funciona mais ou menos assim:
- Planejar
- Editar o código
- Executar ferramentas (testes, build e lint)
- Observar os resultados
- Corrigir falhas
- Atualizar a documentação e o status
- Repetir o ciclo
Esse ciclo é importante porque oferece ao agente:
- Feedback concreto (erros, diffs e logs)
- Estado registrado fora do modelo (repositório, arquivos, documentação, árvores de trabalho e saídas)
- Orientação ao longo do tempo (você pode ajustar o rumo com base nos resultados)
Isso também explica por que a experiência com os modelos do Codex é melhor nas interfaces do Codex do que em uma janela de chat genérica. O harness fornece contexto estruturado (metadados do repositório, árvore de arquivos, diffs e saídas de comandos) e exige que o agente verifique os critérios de conclusão antes de dar o trabalho por encerrado.
Publicamos recentemente um artigo que explica o ciclo do agente do Codex em mais detalhes.
Também lançamos o Codex App, que permite usar esse ciclo no dia a dia:
- Conversas em paralelo em diferentes projetos (as tarefas longas não interrompem seu trabalho do dia a dia)
- Habilidades (padronize as etapas de planejamento, implementação, testes e relato dos resultados)
- Automações (execute tarefas de rotina em segundo plano)
- Árvores de trabalho do Git (isole as execuções, facilite a revisão dos diffs e reduza o retrabalho)

Como preparei o teste
Escolhi uma ferramenta de design para esse “experimento” porque é um teste que expõe falhas rapidamente. Ele envolve uma interface, um modelo de dados, operações de edição e muitos casos extremos. Não dá para improvisar e passar no teste. Se a arquitetura estiver errada, a ferramenta logo deixa de funcionar.
Dei ao GPT-5.3-Codex uma especificação detalhada e selecionei o nível de raciocínio “Extra alto”. O modelo trabalhou por cerca de 25 horas sem interrupção, manteve a coerência e entregou código de qualidade. Também executou verificações (testes, lint e checagem de tipos) a cada marco que concluiu.
A ideia central: memória persistente do projeto
A técnica mais importante foi manter uma memória persistente do projeto. Registrei a especificação, o plano, as restrições e o andamento em arquivos Markdown que o Codex podia consultar quantas vezes precisasse. Isso evitou desvios e manteve estáveis os critérios para considerar o trabalho “concluído”.
Os links abaixo levam aos arquivos do repositório. Organizei o trabalho da seguinte forma:
Prompt.md (especificação e entregas)
Objetivo: definir de antemão o que deve ser entregue para evitar que o agente “crie algo impressionante que não atende ao pedido”.
Principais seções do arquivo:
- Objetivos e o que fica fora do escopo
- Restrições obrigatórias (desempenho, determinismo, experiência do usuário e plataforma)
- Entregas (o que deve existir ao final do trabalho)
- “Quando considerar o trabalho concluído” (verificações e roteiro da demonstração)
O prompt inicial orientava o Codex a usar o arquivo do prompt como especificação completa do projeto e a gerar um plano organizado em marcos:

Plan.md (marcos e validações)
Objetivo: dividir um trabalho em aberto em uma sequência de etapas que o agente consiga concluir e verificar.
Principais seções do arquivo:
- Marcos pequenos o bastante para serem concluídos em um ciclo
- Critérios de aceitação e comandos de validação para cada marco
- Regra para lidar com falhas: se a validação falhar, pare e corrija o problema antes de avançar
- Registro das decisões para evitar idas e vindas
- Arquitetura prevista para a base de código

Recentemente, adicionamos o Modo planejamento nativo ao Codex App, à CLI e à extensão para IDE. Com ele, você pode dividir uma tarefa maior em uma sequência clara de etapas, revisar o plano e combinar a abordagem com o Codex antes de fazer alterações. Se precisar de mais detalhes, o Codex fará perguntas. Para ativar o modo, use o comando de barra /plan.
Implement.md (instruções de execução baseadas no plano)
Objetivo: servir de guia de execução. O arquivo diz ao Codex exatamente como trabalhar: seguir o plano, limitar os diffs ao escopo definido, executar as validações e atualizar a documentação.
Principais seções do arquivo:
- Use o arquivo Markdown do plano como referência definitiva para cada marco
- Execute a validação após cada marco (corrija as falhas imediatamente)
- Limite os diffs ao escopo definido (não amplie o escopo)
- Mantenha o arquivo Markdown de documentação atualizado ao longo da execução

Documentation.md (andamento e decisões ao longo das entregas)
Objetivo: manter uma memória compartilhada e um registro de auditoria. É esse arquivo que me permite sair por algumas horas e entender o que aconteceu quando volto.
Principais seções do arquivo:
- Situação do marco atual (o que já foi concluído e o que vem a seguir)
- Decisões tomadas e seus motivos
- Como executar o projeto e fazer uma demonstração (comandos e testes rápidos de funcionamento)
- Problemas conhecidos e ações pendentes

Veja como o Codex verificou os marcos na prática durante a execução:

Verificação a cada marco
O Codex foi além de escrever o código e torcer para que funcionasse. Ao final de cada marco, executou os comandos de verificação e corrigiu as falhas antes de continuar.
Veja alguns dos comandos que o Codex foi orientado a usar nas verificações de qualidade:

Veja também um exemplo de como o Codex corrigiu problemas após uma falha no lint:

O que o agente criou
O resultado ainda tinha falhas e não estava pronto para produção, mas já era uma ferramenta concreta que dava para testar. Verificar se “o código compila” era só parte do critério de sucesso. A pergunta era: “O resultado segue as instruções e funciona de verdade?”
Principais recursos implementados:
- Edição na área de desenho (quadros, grupos, formas, texto, imagens, ícones, botões e gráficos)
- Colaboração em tempo real (sincronização de presença, cursores, seleções e edições entre abas)
- Controles do inspetor (geometria, estilo e texto)
- Gerenciamento de camadas (buscar, renomear, bloquear, ocultar e reordenar)
- Guias, alinhamento e encaixe automático
- Captura e restauração de versões do histórico
- Linha do tempo para reproduzir alterações e criar uma ramificação a partir de um ponto anterior
- Modo de protótipo (áreas interativas e navegação pelo fluxo)
- Comentários (conversas fixadas que podem ser marcadas como resolvidas e reabertas)
- Exportação (salvar, importar e exportar, com opção de exportar pela CLI para JSON e para React com Tailwind)
Lições para tarefas de longa duração com o Codex
O que fez essa execução funcionar foi a combinação de vários elementos, muito além de um único prompt bem elaborado:
- Um objetivo claro e restrições bem definidas (arquivo de especificação)
- Marcos com pontos de verificação e critérios de aceitação (
plans.md) - Um guia de execução para orientar o agente (
implement.md) - Verificação contínua (testes, lint, checagem de tipos e build)
- Um registro de andamento e auditoria atualizado (
documentation.md), que permitia inspecionar a execução a qualquer momento
É nessa direção que a programação de longa duração está avançando: menos supervisão constante e mais delegação com limites e verificações bem definidos.
Experimente o Codex em uma tarefa sua de longa duração
Essa sessão de 25 horas com o Codex dá uma ideia do futuro do desenvolvimento de software. Estamos indo além dos prompts isolados e dos ciclos curtos de programação em dupla. Agora podemos contar com agentes que trabalham por longos períodos e assumem uma parte concreta do projeto do início ao fim. Você orienta o trabalho a cada marco, sem precisar acompanhar cada linha de código.
Nosso objetivo com o Codex é simples: fazer com que ele colabore melhor como integrante da equipe, trabalhe de forma mais integrada ao contexto real do projeto e siga limites que tornem o trabalho confiável, fácil de revisar e de entregar. Já vemos desenvolvedores avançarem mais rápido quando o agente assume as tarefas rotineiras de implementação e verificação. Isso libera tempo para o que mais importa: design, arquitetura, decisões de produto e problemas novos que não têm solução pronta.
E isso vai além de quem desenvolve software. À medida que o Codex melhora sua capacidade de entender a intenção das pessoas e oferecer uma estrutura segura para o trabalho (planos, validações, prévias e reversões), mais pessoas que não são desenvolvedoras poderão criar e aperfeiçoar soluções sem passar o dia em uma IDE. Ainda há novidades a caminho nas interfaces e nos modelos do Codex, mas o objetivo continua o mesmo: fazer com que o agente deixe de parecer uma ferramenta que exige supervisão constante e passe a ser um colega de equipe em quem você pode confiar para tarefas de longa duração.
Se quiser experimentar, comece por aqui: