Aprende a gestionar el estado de una conversación al interactuar con un modelo.
Responses
OpenAI ofrece varias formas de gestionar el estado de una conversación para conservar la información entre mensajes o turnos.
Si GPT-5.5 interpreta una actualización intermedia como la respuesta final,
verifica que tu integración conserve correctamente el campo phase del mensaje
del asistente. Para más detalles, consulta Parámetro de fase.
Gestionar manualmente el estado de la conversación
Cada solicitud de generación de texto es independiente y no conserva el estado. Aun así, puedes implementar conversaciones de varios turnos si incluyes mensajes adicionales como parámetros de la solicitud. Piensa, por ejemplo, en un chiste de “toc, toc”:
Al alternar mensajes de tipo user y assistant, puedes incluir el estado anterior de la conversación en una sola solicitud al modelo.
Para compartir el contexto manualmente entre las respuestas generadas, agrega la salida de la respuesta anterior del modelo a la entrada de la siguiente solicitud.
En las solicitudes sin estado a modelos de razonamiento, conserva todos los elementos del arreglo output de la respuesta. De forma predeterminada, la API de Responses devuelve los elementos de razonamiento cifrados. Al reenviar la salida completa, conservas intactos tanto los elementos de razonamiento como los valores de phase del asistente. En los modelos que admiten razonamiento persistente, puedes usar reasoning.context: "all_turns" para incorporar el razonamiento disponible de turnos anteriores a la siguiente generación. Consulta Conservar el razonamiento entre llamadas.
Al reenviar elementos de razonamiento, conserva el historial de la conversación que dio origen a esos elementos. Consulta Mantener el prefijo sin cambios para saber cómo afectan al razonamiento los cambios en el historial de la conversación.
En el siguiente ejemplo, le pedimos al modelo que cuente un chiste y luego le pedimos otro. Agregar las respuestas anteriores a las nuevas solicitudes ayuda a que la conversación fluya con naturalidad y conserve el contexto de las interacciones previas.
Gestionar manualmente el estado de la conversación con la API para completar chats.
API de OpenAI para gestionar el estado de la conversación
Nuestras API facilitan la gestión automática del estado de la conversación, por lo que no tienes que enviar las entradas manualmente en cada turno.
Te recomendamos usar la API de Responses. Como conserva el estado, basta con un parámetro para gestionar el contexto entre conversaciones.
Si usas el punto de acceso de Chat Completions, tendrás que gestionar el estado manualmente, como se explica más arriba.
Usar la API de Conversations
La API de Conversations funciona junto con la API de Responses para guardar el estado de la conversación en un objeto de larga duración con un identificador persistente propio. Una vez que creas el objeto de conversación, puedes seguir usándolo en distintas sesiones, dispositivos o trabajos.
Las conversaciones almacenan elementos que pueden ser mensajes, llamadas a herramientas, resultados de herramientas u otros datos.
En una interacción de varios turnos, puedes pasar conversation al generar las siguientes respuestas para conservar el estado y compartir el contexto entre ellas sin tener que encadenar varios elementos de respuesta.
Gestionar el estado de la conversación con las API de Conversations y Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Pasar el contexto de la respuesta anterior
Otra forma de gestionar el estado de la conversación es compartir el contexto entre las respuestas generadas mediante el parámetro previous_response_id. Este parámetro te permite encadenar respuestas y crear un hilo de conversación.
Encadenar respuestas entre turnos con el ID de la respuesta anterior
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id en modo WebSocket
Si usas el modo WebSocket de la API de Responses, previous_response_id funciona igual que en modo HTTP al continuar la conversación, pero los sucesivos eventos response.create se envían por un socket persistente.
La caché local de la conexión guarda las respuestas recientes en memoria para que la conversación pueda continuar con baja latencia. Si usas stream_id, cada canal puede conservar su respuesta más reciente. El parámetro previous_response_id sigue determinando de qué respuesta deriva la siguiente, de modo que un canal nuevo puede partir de una respuesta de otro canal mientras esa respuesta siga disponible. Si no se puede resolver un ID que no está en la caché, envía un nuevo turno con previous_response_id establecido en null e incluye todo el contexto de entrada.
De forma predeterminada, los objetos de respuesta se guardan durante 30 días. Puedes verlos en la página de
registros del panel o
recuperarlos mediante la API.
Para desactivar este comportamiento, establece store en false
al crear una respuesta.
Los objetos de conversación y los elementos que contienen no están sujetos al tiempo de vida (TTL) de 30 días. Los elementos de cualquier respuesta asociada a una conversación se conservan sin ese límite de 30 días.
OpenAI no usa los datos enviados a través de la API para entrenar sus modelos sin tu consentimiento explícito. Más información.
Incluso si usas previous_response_id, la API factura como tokens de entrada todos los tokens de entrada de las respuestas anteriores de la cadena.
Gestionar la ventana de contexto
Entender cómo funcionan las ventanas de contexto te ayudará a crear hilos de conversación y a gestionar el estado entre interacciones con el modelo.
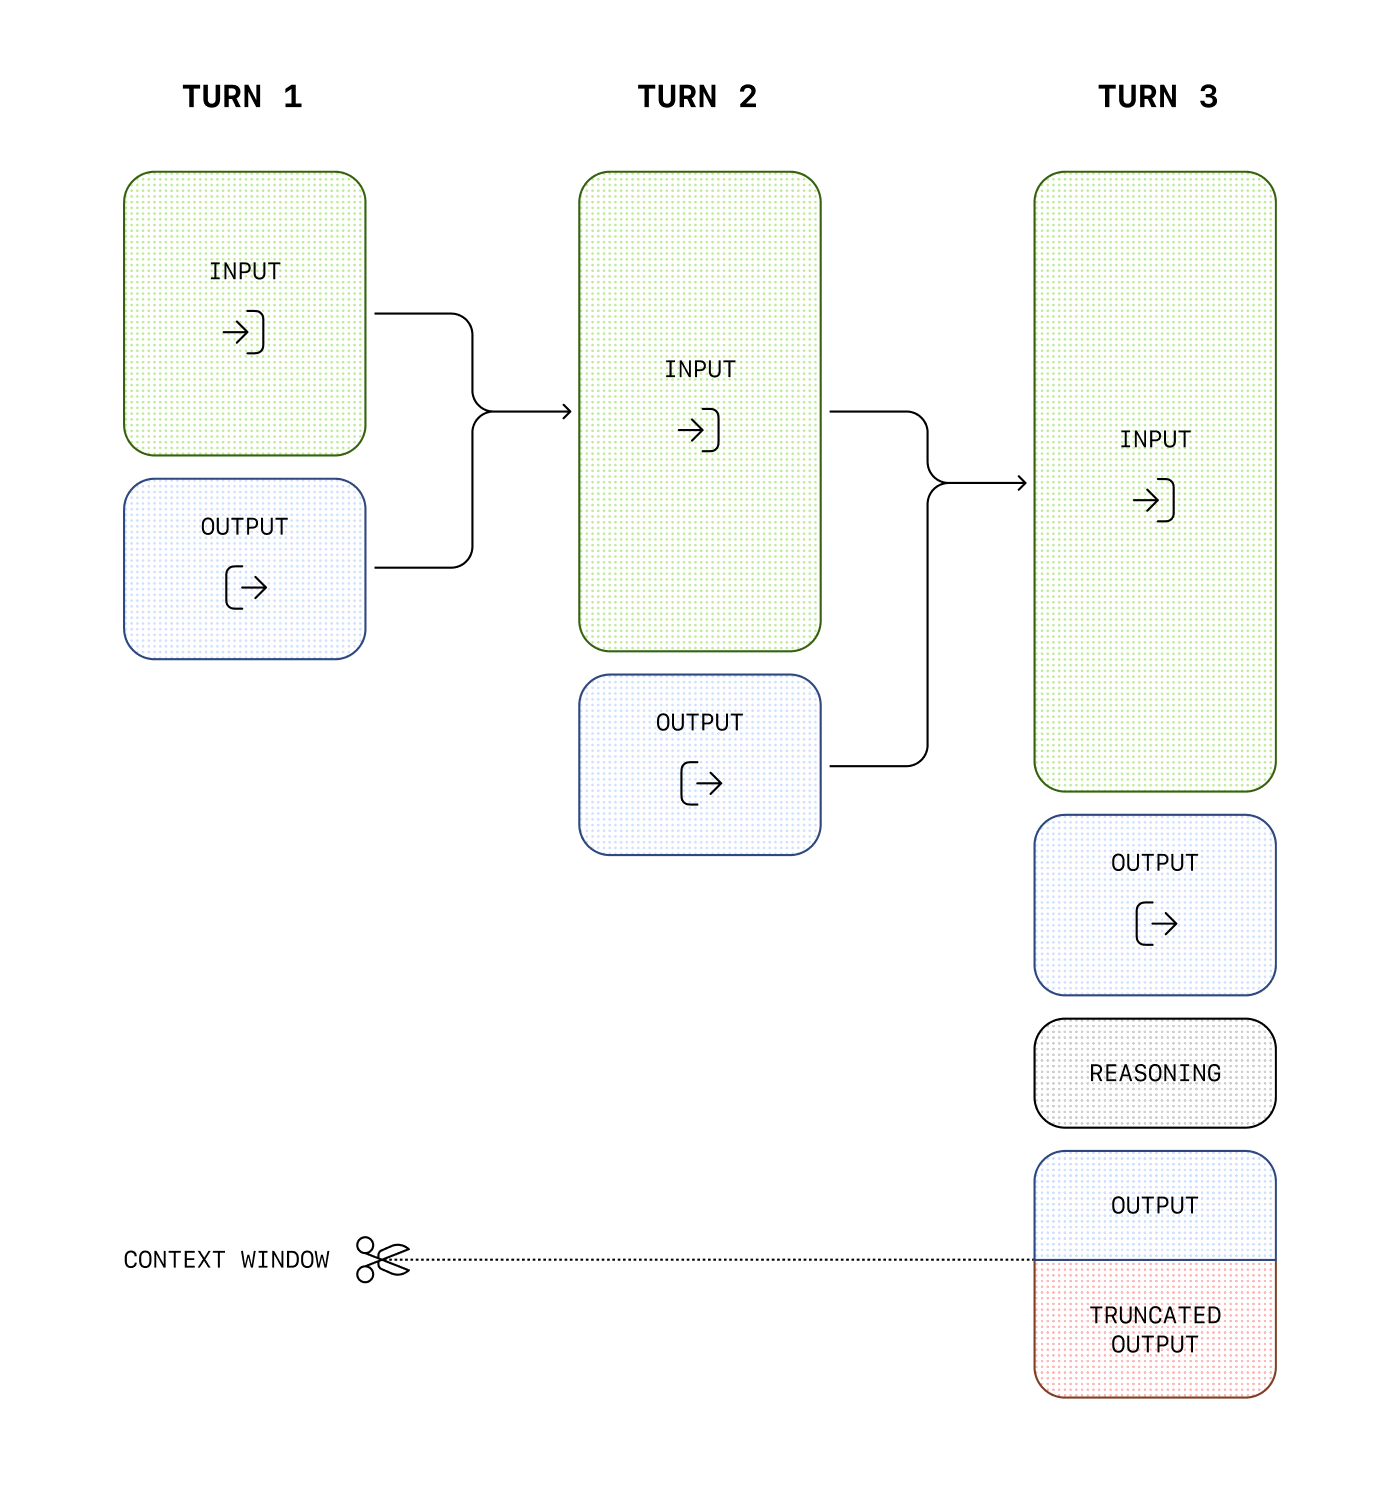
La ventana de contexto es la cantidad máxima de tokens que se pueden usar en una sola solicitud. Este máximo incluye los tokens de entrada, de salida y de razonamiento. Para conocer la ventana de contexto de tu modelo, consulta los detalles de los modelos.
Gestionar el contexto para la generación de texto
A medida que las entradas se vuelven más complejas o agregas más turnos a una conversación, debes tener en cuenta tanto el límite de tokens de salida como el de la ventana de contexto. Las entradas y salidas del modelo se miden en tokens. El modelo descompone las entradas en tokens para analizar su contenido e intención y combina tokens para generar salidas coherentes. Cada modelo tiene límites de uso de tokens que se aplican a lo largo de una solicitud de generación de texto.
Los tokens de salida son los que genera el modelo en respuesta a un prompt. Cada modelo tiene sus propios límites de tokens de salida. Por ejemplo, gpt-4o-2024-08-06 puede generar hasta 16 384 tokens de salida.
La ventana de contexto indica cuántos tokens se pueden usar en total entre la entrada y la salida (en algunos modelos, también incluye los tokens de razonamiento). Compara los límites de las ventanas de contexto de nuestros modelos. Por ejemplo, gpt-4o-2024-08-06 tiene una ventana de contexto de 128 000 tokens en total.
Si creas un prompt extenso, por ejemplo, al incluir contexto, datos o ejemplos adicionales para el modelo, corres el riesgo de superar su ventana de contexto. En ese caso, las salidas podrían quedar truncadas.
Por ejemplo, si envías una solicitud de API a Chat Completions con el modelo o1, los siguientes tokens cuentan para el total de la ventana de contexto:
Tokens de entrada (las entradas que incluyes en el arreglo messages de Chat Completions)
Tokens de salida (los que se generan en respuesta a tu prompt)
Tokens de razonamiento (los que usa el modelo para planificar una respuesta)
Por ejemplo, si envías una solicitud a la API de Responses con un modelo que tiene habilitado el razonamiento, como el modelo o1, los siguientes tokens cuentan para el total de la ventana de contexto:
Tokens de entrada (las entradas que incluyes en el arreglo input de la API de Responses)
Tokens de salida (los que se generan en respuesta a tu prompt)
Tokens de razonamiento (los que usa el modelo para planificar una respuesta)
Los tokens generados que superen el límite de la ventana de contexto podrían quedar truncados en las respuestas de la API.
Para ver ejemplos y casos de uso más específicos, visita el OpenAI Cookbook. También puedes aprender a usar las API para ampliar las capacidades de los modelos: