
Las capacidades de audio de la IA abren nuevas posibilidades para la experiencia de usuario. A principios de este año lanzamos varios modelos de audio, entre ellos gpt-realtime, junto con nuevas funciones de la API para que los desarrolladores puedan crear estas experiencias.
La semana pasada lanzamos nuevas versiones de los modelos de audio para abordar algunos de los desafíos habituales al crear agentes de audio confiables. Estas versiones mejoran la confiabilidad y la calidad de los flujos de trabajo de voz en producción, desde la transcripción y la síntesis de voz hasta los agentes que operan de forma nativa de voz a voz en tiempo real.
Estas actualizaciones incluyen:
gpt-4o-mini-transcribe-2025-12-15para convertir voz a texto con la API de transcripción o la Realtime APIgpt-4o-mini-tts-2025-12-15para convertir texto a voz con la API de síntesis de vozgpt-realtime-mini-2025-12-15para interactuar de voz a voz de forma nativa y en tiempo real con la Realtime APIgpt-audio-mini-2025-12-15para interactuar de voz a voz de forma nativa con la API para completar chats
Las nuevas versiones comparten varias mejoras:
Con entrada de audio:
- Menores tasas de error por palabra en grabaciones reales y en audio con ruido
- Menos alucinaciones durante los silencios o cuando hay ruido de fondo
Con salida de audio:
- Voz más natural y estable, incluso al usar voces personalizadas
Los precios son los mismos que los de las versiones anteriores de los modelos, por lo que te recomendamos cambiar a las nuevas versiones para obtener un mejor rendimiento por el mismo precio.
Si desarrollas agentes de voz, sistemas de atención al cliente o experiencias de voz para una marca, estas actualizaciones te ayudarán a que tus implementaciones sean más confiables en producción. A continuación, detallamos las novedades y cómo se reflejan estas mejoras en los flujos de trabajo de voz en situaciones reales.
De voz a voz
Estamos implementando nuevos modelos Realtime mini y Audio mini que optimizamos para que llamen a herramientas y sigan instrucciones con mayor precisión. Estos modelos reducen la brecha de capacidades entre las versiones mini y las de tamaño completo, lo que permite reducir los costos de algunas aplicaciones al pasar al modelo mini.
gpt-realtime-mini-2025-12-15
El modelo gpt-realtime-mini está diseñado para usarse con la Realtime API, nuestra API para interacciones multimodales nativas de baja latencia. Admite funciones como la transmisión continua de audio de entrada y salida, el manejo de interrupciones (con detección opcional de actividad de voz) y la llamada a funciones en segundo plano mientras el modelo sigue hablando.
La nueva versión de Realtime mini se adapta mejor a los agentes en tiempo real gracias a mejoras claras en el seguimiento de instrucciones y las llamadas a herramientas. En nuestras evaluaciones internas de voz a voz, la precisión aumentó 18,6 puntos porcentuales en el seguimiento de instrucciones y 12,9 puntos porcentuales en las llamadas a herramientas respecto de la versión anterior. También observamos una mejora en la prueba de referencia Big Bench Audio.
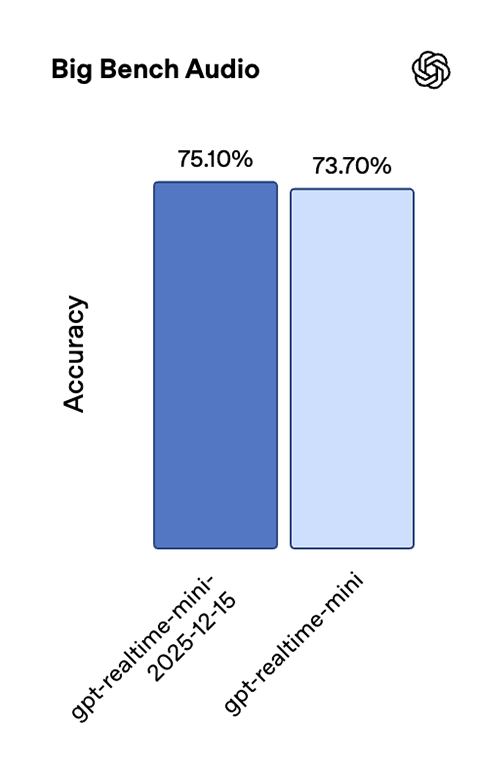
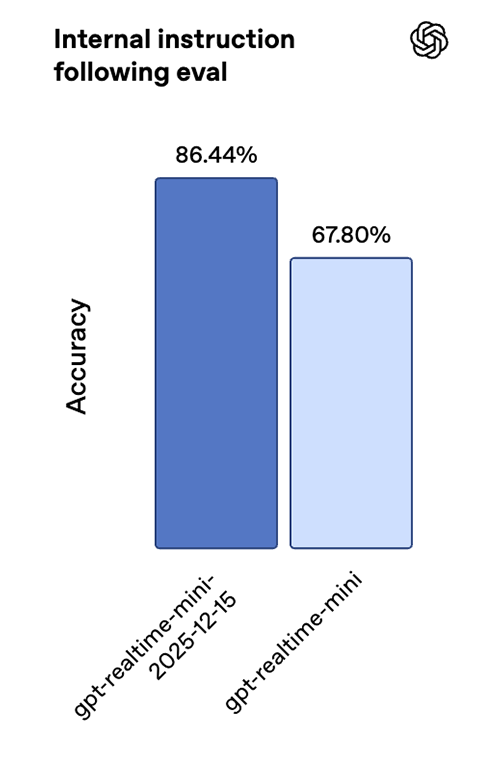
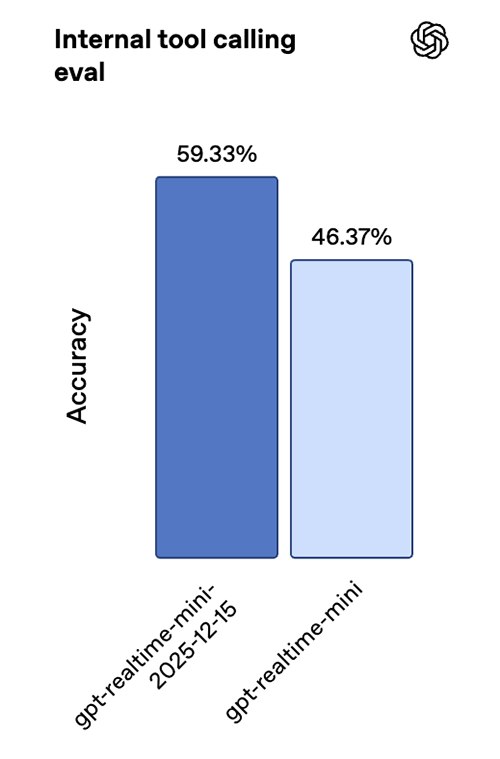
En conjunto, estas mejoras permiten interacciones de varios pasos más confiables y una ejecución más consistente de las funciones en entornos de baja latencia que operan en tiempo real.
Cuando la precisión del agente justifica un costo mayor, gpt-realtime sigue siendo nuestro modelo de mejor rendimiento. Si el costo y la latencia son prioritarios, gpt-realtime-mini es una excelente opción que ofrece buenos resultados en situaciones reales.
Por ejemplo, Genspark sometió el modelo a pruebas de estrés en tareas de traducción bilingüe y de enrutamiento inteligente según la intención del usuario. Además de observar una mejora en la calidad de la voz, comprobó que la respuesta era casi instantánea y que el modelo reconocía la intención con precisión incluso en intercambios rápidos.
gpt-audio-mini-2025-12-15
Puedes usar el modelo gpt-audio-mini con la API para completar chats en casos de uso de voz a voz que no requieran interacción en tiempo real.
Ambas versiones también incorporan un decodificador mejorado que produce voces más naturales y mantienen mejor la consistencia de las voces personalizadas.
De texto a voz
Nuestro modelo de texto a voz más reciente, gpt-4o-mini-tts-2025-12-15, es considerablemente más preciso que la generación anterior, con tasas de error por palabra mucho más bajas en las pruebas de referencia estándar de voz. En Common Voice y FLEURS, observamos una reducción aproximada del 35 % en la tasa de error por palabra (WER), con mejoras consistentes también en Multilingual LibriSpeech.
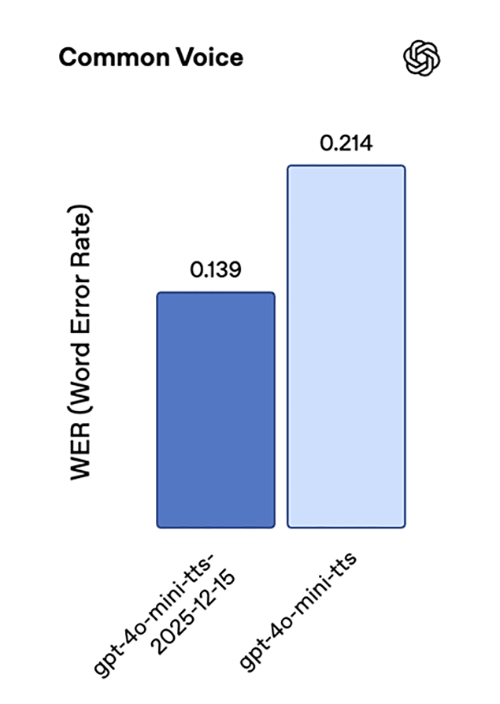
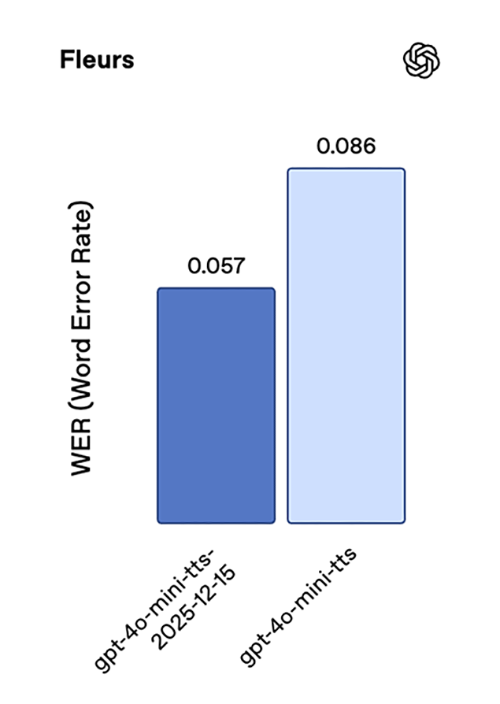
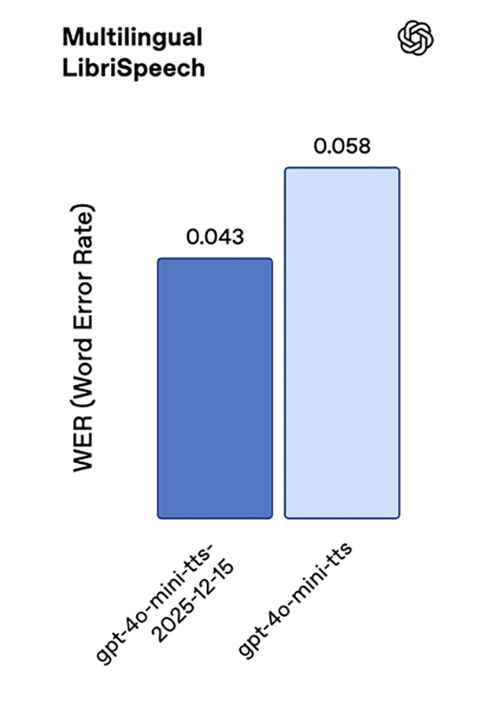
En conjunto, estos resultados reflejan una pronunciación más precisa y un rendimiento más robusto en una amplia variedad de idiomas.
Al igual que la nueva versión de gpt-realtime-mini, este modelo suena mucho más natural y ofrece mejores resultados con las voces personalizadas.
De voz a texto
El modelo de transcripción más reciente, gpt-4o-mini-transcribe-2025-12-15, mejora considerablemente tanto en precisión como en confiabilidad. En pruebas de referencia estándar de reconocimiento automático del habla, como Common Voice y FLEURS, logra tasas de error por palabra más bajas que los modelos anteriores sin recibir indicaciones sobre el idioma. Optimizamos el modelo para conversaciones reales, por ejemplo, cuando el usuario dice solo unas palabras o hay ruido de fondo. En una evaluación interna de alucinaciones en presencia de ruido, reprodujimos grabaciones de ruido de fondo de entornos reales y audios con intervalos de habla de distinta duración y períodos de silencio. El modelo produjo aproximadamente un 90 % menos de alucinaciones que Whisper v2 y cerca de un 70 % menos que los modelos GPT-4o-transcribe anteriores.
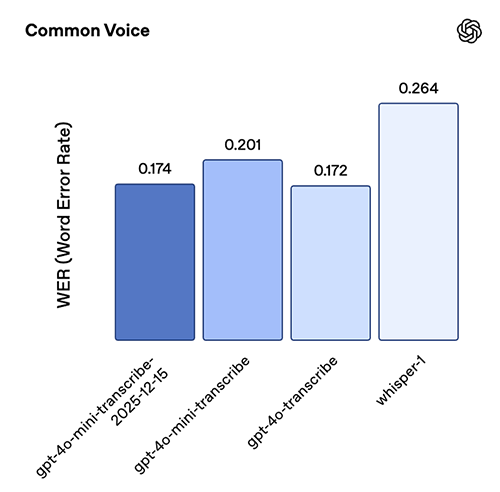
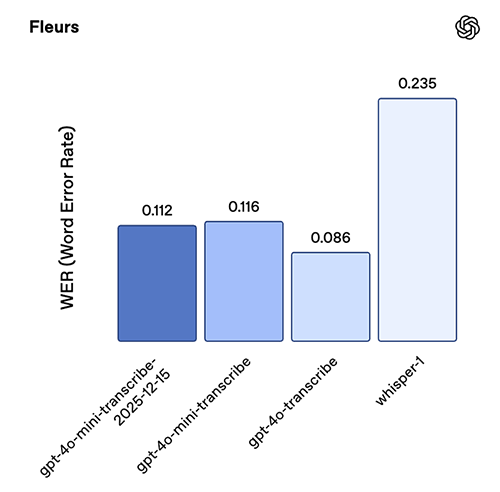
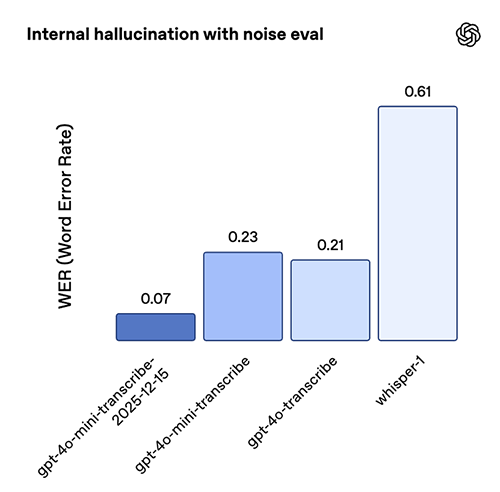
Esta versión del modelo ofrece resultados especialmente buenos en chino mandarín, hindi, bengalí, japonés, indonesio e italiano.
Voces personalizadas
Las voces personalizadas permiten a las organizaciones comunicarse con sus clientes con una voz propia de su marca. Ya sea que estés creando un agente de atención al cliente o un avatar de marca, la tecnología de voces personalizadas de OpenAI facilita la creación de voces distintivas y realistas.
Con los nuevos modelos de voz a voz y de texto a voz, las voces personalizadas tienen tonos más naturales, reproducen con mayor fidelidad la muestra original y ofrecen mayor precisión en distintos dialectos.
Para garantizar el uso seguro de esta tecnología, las voces personalizadas solo están disponibles para los clientes que cumplen los requisitos. Para obtener más información, comunícate con tu director de cuenta o contacta a nuestro equipo de ventas.
Del prototipo a la producción
Las aplicaciones de voz suelen fallar en las mismas situaciones, sobre todo en conversaciones largas, en casos límite como los silencios y en flujos de trabajo que dependen de herramientas y exigen precisión al agente de voz. Estas actualizaciones abordan esas fallas al reducir las tasas de error y las alucinaciones, hacer más consistente el uso de herramientas y mejorar el seguimiento de instrucciones. Además, mejoramos la estabilidad del audio de salida para que tus experiencias de voz suenen más naturales.
Si ya tienes experiencias de voz en producción, te recomendamos cambiar a las nuevas versiones del 2025-12-15 y volver a ejecutar tus principales casos de prueba de producción.
Quienes probaron primero los modelos confirmaron que bastó con cambiar a las nuevas versiones para observar mejoras perceptibles sin modificar sus instrucciones. Aun así, te recomendamos experimentar con tus propios casos de uso y ajustar tus prompts según sea necesario.