
Choisissez le modèle Realtime que vous utilisez pour votre application. Pour GPT-Live, consultez le guide Concevoir des prompts pour GPT-Live.
gpt-realtime-2 est notre modèle vocal de raisonnement le plus avancé pour les applications de parole à parole à faible latence. Il peut réfléchir avant de parler. Par rapport aux modèles Realtime précédents, il suit les instructions plus fidèlement, dispose d’une fenêtre de contexte plus grande et appelle les outils avec davantage de précision.
Pour tirer parti de ces améliorations, précisez le comportement attendu dans vos prompts. Définissez explicitement les responsabilités de l’assistant, les décisions qu’il doit prendre, les règles d’appel des outils et les garde-fous. Indiquez ce qu’il doit faire, à quel moment et ce qu’il doit éviter.
Commencez par un prompt minimal. Évaluez-le, puis ajoutez des instructions uniquement pour les comportements qui échouent lors des tests.
Choisissez un modèle
| Modèle | Quand l’utiliser | Points à préciser dans le prompt |
|---|---|---|
gpt-realtime-2 | Vous recherchez les meilleures performances en temps réel pour le raisonnement, l’utilisation des outils et le suivi des instructions. | Ajustez l’effort de raisonnement, les préambules, les règles d’utilisation des outils, la saisie exacte des entités et le suivi de l’état des sessions longues. |
gpt-realtime-1.5 | Vous avez besoin d’un modèle de parole à parole rapide et fiable, sans raisonnement. | Suivez la structure de base des prompts Realtime et testez les comportements sensibles à la latence. |
Guide de conception des prompts pour Realtime 2.0
Utilisez gpt-realtime-2 si votre agent vocal doit raisonner plus finement, mieux choisir ses outils, traiter des entités avec exactitude ou suivre l’état d’une session longue. Commencez avec reasoning.effort: “low”, testez les préambules par défaut et indiquez clairement quelles opérations d’écriture nécessitent une confirmation préalable.
Nouveautés de Realtime 2
Rédigez vos prompts en tenant compte des capacités de raisonnement de Realtime 2, qui vont au-delà de celles d’un simple bot vocal.
| Changement | Conséquences pour les prompts |
|---|---|
| Raisonnement | Pour les tâches complexes, laissez le modèle raisonner en interne avant de parler ou d’appeler un outil. Utilisez des préambules pour éviter les silences gênants ou les paroles superflues. |
| La précision du prompt compte davantage | Remplacez les consignes générales comme « rendez-vous utile » par des règles précises. Indiquez ce qui déclenche l’action, ce qu’il faut faire et dans quels cas il faut s’abstenir. |
| Les conflits entre instructions ont davantage de conséquences | Éliminez les règles qui se recoupent et contiennent always, never, only ou must, sauf si elles sont indispensables. Précisez quelle règle prévaut en cas de conflit. |
| L’utilisation des outils se règle plus finement | Précisez quand l’assistant doit agir immédiatement, demander une information manquante, confirmer un détail qui exige de la précision, réessayer après un échec ou passer le relais. |
| Les préambules se règlent indépendamment | Le modèle peut annoncer brièvement ce qu’il fait avant un raisonnement prolongé ou une série d’appels d’outils. Indiquez quand il doit utiliser un préambule, quelle longueur respecter et quand s’en passer. |
| Fenêtre de contexte élargie | gpt-realtime-2 fait passer la fenêtre de contexte en temps réel de 32 000 à 128 000 tokens. Le modèle convient ainsi mieux aux sessions longues et aux prompts système volumineux. |
Les préambules ne révèlent pas le raisonnement détaillé (« chain-of-thought ») interne. Ce sont de brèves annonces orales, comme « Je vérifie cette commande. » Ne demandez pas au modèle de révéler son raisonnement privé.
Structure de prompt recommandée
Utilisez des sections courtes avec un titre. Le modèle doit pouvoir repérer rapidement les instructions pertinentes.
# Rôle et objectif

# Personnalité et ton

# Langue

# Raisonnement

# Canaux de message

# Préambules

# Niveau de détail

# Outils

# Propos indistincts

# Saisie des entités

# Gestion des contextes longs

# Transfert
Tous les cas d’usage ne nécessitent pas toutes ces sections. Ajoutez celles qui correspondent à votre produit.
Réglez l’effort de raisonnement
gpt-realtime-2 peut prendre plus de temps pour approfondir son raisonnement. Utilisez le niveau de raisonnement le plus bas qui permette à l’assistant de mener à bien le workflow.
Commencez avec low pour la plupart des agents vocaux en production. Augmentez ou réduisez ce niveau selon la complexité de la tâche, la latence acceptable et le coût d’un échec.
| Effort | Quand l’utiliser | Exemple |
|---|---|---|
minimal |
La tâche est simple et la priorité est de réduire la latence au minimum. | Commandes domotiques, minuteurs, consultation rapide d’un agenda. |
low |
Vous avez besoin de réactivité et d’un raisonnement élémentaire. | Service client, recherche de commande, questions simples sur une politique. |
medium |
L’assistant doit raisonner sur des tâches en plusieurs étapes. | Assistance technique, diagnostic, orientation de demandes complexes. |
high |
Un raisonnement approfondi augmente sensiblement les chances de réussite. | Workflows exigeant une grande précision, décisions de transfert, tâches soumises à des contraintes. |
xhigh |
Un effort de raisonnement maximal justifie la latence et le coût supplémentaires. | Planification complexe, triage critique, coordination d’outils pour des opérations à fort enjeu. |
En complément du réglage de l’API, indiquez au modèle quand raisonner et jusqu’où pousser le raisonnement.
## Raisonnement

- Pour une réponse directe, une recherche simple ou une brève confirmation, répondez rapidement, sans raisonner.
- Pour une tâche en plusieurs étapes, une décision sur l’utilisation d’un outil, un dépannage ou un transfert, raisonnez avant d’agir.
- Si les propos de l’utilisateur sont indistincts, demandez une précision au lieu d’entamer un raisonnement prolongé.
Choisissez quand utiliser un préambule
Les préambules sont de brèves annonces orales qui permettent à l’agent vocal de rester réactif pendant qu’il raisonne, recherche une information ou appelle un outil. Bien utilisés, ils indiquent à l’utilisateur que l’assistant traite sa demande. Mal utilisés, ils meublent la conversation et donnent l’impression d’attendre plus longtemps.
gpt-realtime-2 génère des préambules par défaut. Testez d’abord ce comportement. S’il ne correspond pas à l’expérience que vous souhaitez proposer, ajustez-le explicitement.
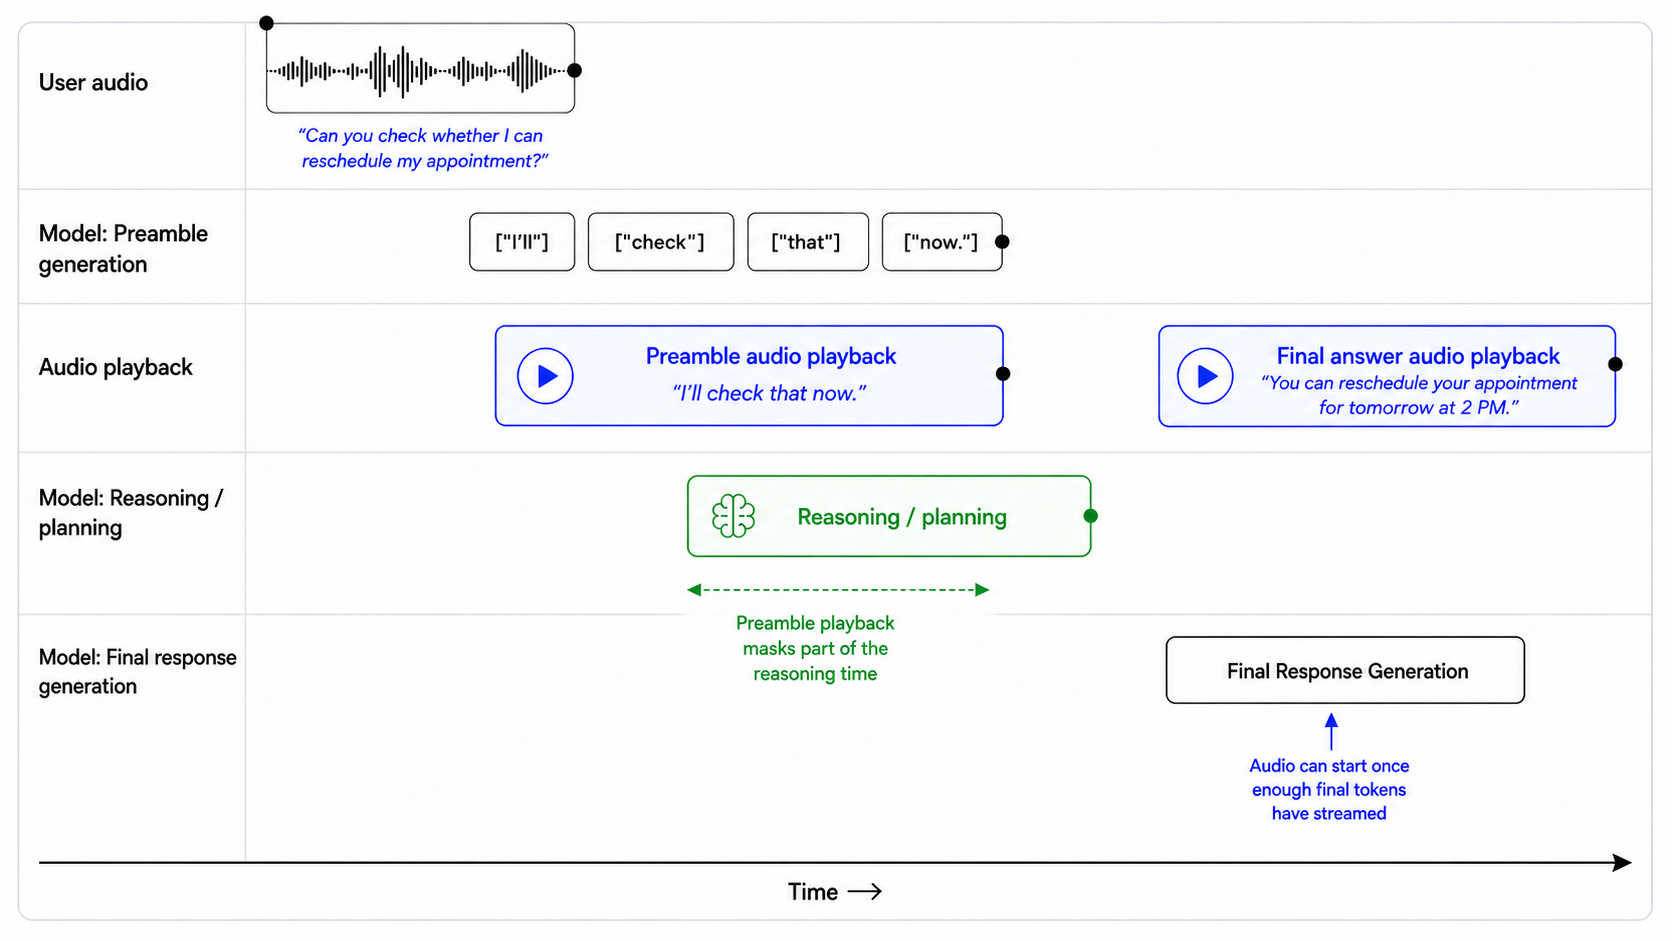
## Préambules

Utilisez un préambule court uniquement s’il aide l’utilisateur à comprendre que vous traitez sa demande.

### Quand utiliser un préambule

Utilisez un préambule dans les cas suivants :

- vous allez appeler un outil dont le délai de réponse risque d’être perceptible ;
- la demande exige un raisonnement en plusieurs étapes ;
- vous vérifiez des dossiers, des disponibilités, l’état d’un compte ou les détails d’une politique ;
- vous préparez un transfert ou un passage de relais ;
- un silence donnerait l’impression que vous ne réagissez plus.

Lorsqu’un préambule est nécessaire, prononcez-le juste avant d’entamer le raisonnement de fond ou d’utiliser l’outil.

### Quand omettre le préambule

N’utilisez pas de préambule dans les cas suivants :

- vous pouvez donner une réponse directe immédiatement ;
- l’utilisateur se contente de confirmer, de corriger ou de refuser quelque chose ;
- les propos sont indistincts et vous devez demander une précision ;
- vous n’entendez que du silence, du bruit de fond, de la musique d’attente, la télévision ou une conversation qui ne vous est pas adressée ;
- l’appel d’outil est rapide et une annonce n’apporterait rien à l’utilisateur.

### Style du préambule

Lorsque vous utilisez un préambule :

- gardez un ton naturel, calme et concis ;
- variez la formulation d’un tour de parole à l’autre ;
- décrivez l’action sans exposer votre raisonnement interne ;
- évitez les paroles superflues.

Évitez les formulations suivantes :

- « Laissez-moi réfléchir… »
- « Hum… »
- « Un instant, le temps que je traite votre demande… »
- « Je vais maintenant accéder à l’outil… »

### Longueur du préambule

Utilisez une phrase courte.

Ne dépassez pas deux phrases courtes, sauf si l’utilisateur a besoin d’une explication avant une action lourde de conséquences.

### À privilégier

- « Je vérifie cette commande. »
- « Je consulte les détails de votre rendez-vous. »
- « Je vais vérifier ce point avant toute modification. »
- « Je vérifie la règle applicable, puis je vous indique la marche à suivre. »
- « J’ouvre le dossier pour que nous puissions vérifier qu’il s’agit du bon compte. »

### À éviter

- « Laissez-moi y réfléchir un instant. »
- « Veuillez patienter pendant le traitement de votre demande. »
- « Je vais maintenant utiliser mes outils. »
- « Question intéressante. Je vais y réfléchir attentivement. »
Réglez la longueur des réponses
gpt-realtime-2 respecte mieux les consignes de longueur lorsque le prompt précise le niveau de détail attendu pour chaque type de tâche. Au lieu de demander au modèle d’« être concis », définissez ce que cela signifie dans chaque situation. Une réponse directe, un résultat d’outil, un dépannage, une comparaison ou un transfert peuvent nécessiter des réponses de longueurs différentes.
## Niveau de détail

- Réponse directe : utilisez une à deux phrases courtes.
- Demande de précision : posez une seule question à la fois.
- Résultat d’outil : résumez d’abord le résultat, puis indiquez uniquement la prochaine action utile.
- Comparaison de produits ou d’options : indiquez les différences importantes, les compromis et les besoins auxquels répond chaque option.
- Dépannage : donnez une seule étape à la fois, sauf si l’utilisateur demande la procédure complète.
- Transfert : expliquez brièvement pourquoi le transfert est nécessaire et ce qui va se passer ensuite.
Exemple :
Utilisateur : Quelle offre me conseillez-vous ?
Assistant : Si votre priorité est le prix, choisissez Basic. Si vous avez besoin de gérer les autorisations d’une équipe et de partager la facturation, choisissez Pro. Si vous devez effectuer des contrôles de conformité ou disposer de fonctions d’administration, choisissez Enterprise.
Définissez les règles d’utilisation des outils
gpt-realtime-2 appelle les outils avec davantage de fiabilité, mais son comportement dépend toujours du prompt et de la définition des outils. Si le prompt n’indique pas quand agir, poser une question, demander confirmation ou reprendre après un échec, l’assistant risque d’appeler un outil trop tôt, de poser des questions inutiles ou de répéter un appel qui a échoué.
Réglez la prise d’initiative pour les appels d’outils
L’assistant peut prendre davantage d’initiatives pour les actions en lecture seule à faible risque. Il vaut mieux limiter cette initiative quand les outils modifient des données, ont des effets externes ou exigent des identifiants exacts.
| Type d’outil | Comportement par défaut |
|---|---|
| Recherche en lecture seule à faible risque | Appelez l’outil lorsque l’intention et les champs requis sont clairs. |
| Lecture seule avec identifiant exact | Faites confirmer l’identifiant avant la recherche. |
| Communication visible par l’utilisateur | Préparez un brouillon ou résumez le message avant l’envoi. |
| Modification de compte | Demandez confirmation avant l’appel. |
| Achats, annulations, paiements | Faites confirmer le montant, l’objet de l’opération et sa conséquence avant l’appel. |
| Actions irréversibles ou lourdes de conséquences | Demandez une confirmation explicite et proposez un transfert si nécessaire. |
Adoptez les règles suivantes comme point de départ si vous combinez des actions de lecture et d’écriture. Adaptez-les à votre cas d’usage.
## Outils

Utilisez uniquement les outils explicitement fournis dans la liste actuelle. N’inventez, ne simulez et ne renommez aucun outil. Ne supposez pas qu’un outil existe.

Pour les outils en lecture seule :

- Appelez l’outil lorsque l’intention de l’utilisateur est claire et que vous disposez de tous les champs requis.
- Ne demandez pas de confirmation, sauf si la recherche dépend d’un identifiant qui doit être exact ou si le risque de consulter le mauvais dossier est réel.
- Demandez une précision uniquement si un champ requis manque, est ambigu ou contredit une autre information.

Pour les outils d’écriture ou les actions externes :

- Résumez l’action prévue avant d’appeler l’outil.
- Précisez sa principale conséquence, par exemple ce qui sera modifié, envoyé, annulé, commandé ou débité.
- Demandez confirmation.
- N’appelez l’outil qu’après avoir obtenu une confirmation claire de l’utilisateur.

Pour les identifiants exacts :

- Les identifiants de commande, numéros de suivi, numéros de compte, codes de confirmation, numéros de téléphone et adresses e-mail doivent être exacts.
- Ne normalisez une valeur que si le type de champ est clair.
- Faites confirmer la valeur finale avant toute recherche propre à un compte, validation ou opération d’écriture.

Après un appel d’outil :

- Annoncez que l’action a été effectuée uniquement si l’appel a réussi.
- Si l’appel échoue, expliquez brièvement l’échec sans exposer l’erreur brute et indiquez clairement à l’utilisateur la prochaine étape.
Exemple d’action à haut risque :
Utilisateur : Débitez ma carte du solde restant.
À éviter :
Assistant : J’ai débité votre carte.
À privilégier :
Assistant : Vous souhaitez régler le solde restant de 248,16 $ avec la carte enregistrée. Puis-je effectuer le débit ?
Reprenez après un échec d’outil
Les échecs d’outils font partie de la conversation. Pour bien reprendre l’échange, expliquez ce qui s’est passé et indiquez clairement à l’utilisateur la prochaine étape.
Adaptez la réponse au type d’outil, à la nature de l’échec et à ses conséquences pour l’utilisateur. Dans certains cas, l’assistant doit réessayer sans interrompre l’échange. Dans d’autres, il doit demander à l’utilisateur de préciser sa demande, de corriger un identifiant, de confirmer une nouvelle action ou de choisir une autre solution.
## Échecs d’outils

Si un appel d’outil échoue :

1. Expliquez brièvement ce qui a échoué dans des termes accessibles à l’utilisateur.
2. Ne rejetez pas la faute sur l’utilisateur et n’exposez pas l’erreur brute de l’outil.
3. Si l’échec peut provenir d’un identifiant qui doit être exact, relisez la valeur utilisée et demandez à l’utilisateur de la corriger.
4. Si l’échec peut être temporaire, proposez de réessayer une fois.
5. Si le même échec se répète, proposez une autre solution ou un transfert.

Après un échec, n’appelez pas à répétition le même outil avec les mêmes arguments.

Avant de demander un autre identifiant, vérifiez que vous avez correctement saisi la valeur fournie.
À éviter :
Assistant : Un problème est survenu.
À privilégier :
Assistant : Je ne trouve aucun résultat pour O R D tiret 3 1 2 5 B 2 3. Ai-je mal compris l’un des caractères ?
Gardez le prompt en accord avec les outils disponibles
Les modèles Realtime cherchent spontanément à aider. Si le prompt mentionne un outil indisponible ou si la liste des outils ne correspond pas au prompt, le modèle risque d’inventer un nom d’outil ou de prétendre avoir exécuté l’action.
Par exemple, si le prompt mentionne lookup_order mais que l’outil fourni s’appelle search_orders, le modèle risque d’utiliser le mauvais nom ou de simuler l’action.
## Disponibilité des outils

Utilisez uniquement les outils explicitement fournis dans la liste actuelle.

N’inventez ni ne simulez d’outil et ne supposez pas qu’un outil existe. Si les instructions mentionnent un outil absent de la liste, considérez-le comme indisponible.

Si l’utilisateur demande une action qui nécessite un outil indisponible :

1. Ne prétendez pas avoir effectué l’action.
2. Expliquez brièvement que l’outil est indisponible.
3. Proposez l’action prise en charge qui se rapproche le plus de la demande.

Annoncez que l’action a été effectuée uniquement après la réussite de l’appel à l’outil concerné.
Utilisez le méta-prompt d’audit en annexe pour repérer les contradictions, les outils manquants et les instructions trop fragiles dans vos prompts de production.
Gérez les silences et les sons ambiants
Par défaut, les agents vocaux ont tendance à répondre. En production, ils captent souvent des sons qui n’appellent aucune réponse orale : silence, bruit de fond, musique d’attente, son de la télévision ou conversation entre d’autres personnes.
Utilisez un outil d’attente sans effet lorsque l’assistant doit garder le silence et continuer d’écouter. Il dispose ainsi d’une action valide qui ne l’oblige pas à dire « Je suis là » ou « Je n’ai pas bien entendu ».
Définition de l’outil :
{
"name": "wait_for_user",
"description": "Appelez cet outil lorsque le dernier segment audio n’appelle aucune réponse orale, par exemple si vous n’entendez que du silence, du bruit de fond, de la musique d’attente, la télévision, une conversation entre d’autres personnes ou des propos qui ne s’adressent pas à l’assistant. Cet outil permet de terminer le tour de parole sans répondre à l’oral.",
"parameters": {
"type": "object",
"properties": {},
"required": []
}
}Associez-lui des instructions dans le prompt :
## Gestion des silences et du bruit de fond

Appelez `wait_for_user` si le dernier segment audio n’appelle aucune réponse orale : vous n’entendez que du silence, du bruit de fond, de la musique d’attente, la télévision, une conversation entre d’autres personnes ou des propos qui ne vous sont pas adressés.

Après cet appel, ne répondez pas à l’oral.

Ne dites pas « Je suis là », « Je n’ai pas bien entendu », « Prenez votre temps » ou « Dites-moi quand vous serez prêt ».

Reprenez l’échange uniquement lorsque l’utilisateur s’adresse clairement à vous ou demande de l’aide.
Réservez cet outil aux sons qui ne s’adressent pas à l’assistant. Si l’utilisateur s’adresse manifestement à lui mais que ses propos sont inintelligibles, demandez une précision.
Utilisez les canaux de message à bon escient
gpt-realtime-2 peut produire des messages intermédiaires visibles par l’utilisateur dans le canal commentary et des réponses définitives dans le canal final. Si le comportement attendu dépend du canal, donnez des instructions propres à chacun.
| Canal | Visible par l’utilisateur ? | Utilisation |
|---|---|---|
commentary |
Oui | Préambules et appels d’outils. |
final |
Oui | Message final destiné à l’utilisateur. |
Par exemple, les appels d’outils se font dans le canal commentary. Si vous voulez que l’assistant parle avant, pendant ou après l’utilisation d’un outil, précisez ce comportement dans les instructions relatives à ce canal.
Avant d’appeler un outil dans le canal commentary, indiquez brièvement à l’utilisateur ce que vous faites.gpt-realtime-2 peut produire plusieurs phases de réponse au cours d’un même tour de parole. Dans la sortie de l’API, l’événement response.done les distingue grâce à la valeur de phase, qui indique s’il s’agit d’un commentaire intermédiaire ou de la réponse finale.
Votre application peut utiliser ce champ pour traiter chaque phase différemment. Par exemple, elle peut lire ou afficher le commentaire comme une brève annonce intermédiaire et réserver final_answer à la réponse complète de l’assistant.
response.output[0].phase: "commentary"
response.output[1].phase: "final_answer"Gérez les propos difficiles à comprendre
Le modèle ne doit agir que s’il comprend avec certitude ce qu’il entend. Si les propos sont indistincts, il doit poser une brève question de clarification au lieu de deviner.
Ne laissez pas le modèle déduire les mots manquants, appeler des outils, saisir des entités, générer un préambule ou consacrer du temps de raisonnement interne à reconstituer ce que l’utilisateur a pu dire.
## Propos indistincts

- Répondez uniquement aux propos ou aux textes que vous comprenez clairement.
- Si les propos de l’utilisateur sont indistincts, demandez-lui de répéter en utilisant une courte phrase en anglais, par exemple « Sorry, could you repeat that clearly? »
- Ne demandez pas deux fois la même précision avec la même formulation.
- Considérez le son comme indistinct s’il est ambigu, bruité, silencieux, inintelligible ou partiellement coupé, ou si vous doutez des mots exacts prononcés par l’utilisateur.
- Si les propos sont indistincts, ne devinez pas ce que l’utilisateur voulait dire.
- Ne raisonnez pas si les propos sont indistincts.
- Si les propos sont indistincts, ne prononcez pas de préambule et n’appelez pas d’outil dans le canal commentary.
Exemple :
Audio de l’utilisateur : « Vérifiez la commande trois un… » [coupure]
À éviter :
Assistant : Je vérifie la commande 31.
À privilégier :
Assistant : Je n’ai entendu qu’une partie du numéro de commande. Pourriez-vous le répéter chiffre par chiffre ?
Saisissez les entités avec exactitude
De nombreux workflows en temps réel exigent des valeurs exactes : identifiants de commande, numéros de suivi, adresses e-mail, codes de confirmation, numéros de compte ou de dossier, identifiants de ticket, références d’assistance et numéros de téléphone.
La saisie à l’oral est délicate. Les utilisateurs parlent vite, regroupent les chiffres de différentes façons, n’épellent qu’une partie d’une valeur, hésitent, se corrigent en cours de phrase ou prononcent des caractères aux sonorités proches. Un seul chiffre erroné peut faire échouer une recherche ou renvoyer le mauvais compte.
Soyez prudent lors de la saisie. Recueillez une valeur à la fois, normalisez uniquement ce qui est clair, faites confirmer les valeurs qui exigent une grande précision avant tout appel d’outil et prévoyez la possibilité de corriger chaque valeur.
Recueillez une seule entité à la fois
Lorsqu’un workflow exige plusieurs valeurs, recueillez-les une par une. Vous éviterez ainsi de confondre les champs, en particulier dans les conversations vocales.
## Ordre de collecte des entités

Recueillez les valeurs requises une par une.

- Demandez uniquement la prochaine valeur manquante.
- Ne demandez pas plusieurs valeurs au cours du même tour de parole.
- Avant de poser la question, vérifiez si la valeur a déjà été fournie au cours de la conversation ou de la session.
- Si vous disposez déjà d’une valeur possible, faites-la confirmer par l’utilisateur avant de l’utiliser.

Exemple :

« Vous avez indiqué le numéro de suivi ABC-54321 tout à l’heure. Dois-je utiliser celui-ci ou avez-vous un autre numéro de suivi ? »

N’appelez aucun outil tant que la valeur en cours de collecte n’a pas été recueillie, validée et confirmée.
Traitez les caractères épelés
Appliquez cette méthode lorsque les utilisateurs épellent un identifiant, un code, un nom ou une adresse e-mail caractère par caractère. La suite de sons reçue doit être convertie en valeur finale.
## Caractères épelés

Lorsqu’un utilisateur dicte un identifiant, un code ou une adresse e-mail caractère par caractère, regroupez la séquence dictée en une seule valeur. Conservez les séparateurs explicitement prononcés, comme le tiret, le point, le tiret bas, la barre oblique ou le signe plus. Sinon, n’ajoutez ni espace ni séparateur.

Exemples :

- « A B C un deux trois » -> « ABC123 »
- « B C tiret neuf huit sept » -> « BC-987 »
- « J O H N arobase example point com » -> « john@example.com »

N’insérez pas d’espaces entre les caractères épelés, sauf si l’utilisateur indique explicitement que la valeur contient des espaces.
Normalisez avec soin les nombres dictés
Pour dicter un identifiant numérique, l’utilisateur peut énoncer les chiffres séparément, les regrouper ou les lire comme un nombre. Si le champ attend une suite continue de chiffres, convertissez en chiffres les nombres que vous comprenez sans ambiguïté.
## Traitement des nombres dictés

Lors de la collecte d’identifiants numériques, transcrivez les nombres dictés en chiffres.

Exemples :

- « un deux trois quatre » -> « 1234 »
- « un vingt-trois » -> « 123 »
- « un dix-neuf » -> « 119 »
- « quatre-vingt-dix-neuf onze » -> « 9911 »
- « neuf mille neuf cent onze » -> « 9911 »

Si plusieurs interprétations sont plausibles, demandez une précision à l’utilisateur avant d’utiliser la valeur.

Exemple :

« J’ai entendu soit 119, soit 1-19. Pourriez-vous répéter le numéro chiffre par chiffre ? »
Faites confirmer les identifiants exacts avant les appels d’outils
Les identifiants de commande, numéros de suivi, numéros de compte ou de dossier, codes de confirmation et autres identifiants similaires doivent être exacts. Faites-les confirmer avant de les utiliser dans un appel d’outil.
Pour un identifiant numérique, répétez la valeur chiffre par chiffre. Si vous la lisez comme un nombre entier, une erreur risque de passer inaperçue.
Exemple :
Assistant : Pour vérifier, j’ai entendu 8… 3… 5… 2… 1. C’est bien ça ?
Si l’utilisateur corrige un caractère ou un chiffre, répétez la valeur corrigée en entier avant d’appeler l’outil.
Exemple :
Assistant : D’accord. J’ai donc 8… 3… 5… 7… 1. C’est bien ça ?
## Confirmation des identifiants exacts

Avant d’appeler un outil avec un identifiant qui doit être exact :

- Faites confirmer la valeur finale normalisée par l’utilisateur.
- Relisez les identifiants numériques chiffre par chiffre.
- N’utilisez aucune valeur supposée, partielle ou ambiguë.
- Si l’utilisateur corrige la valeur, répétez la valeur corrigée en entier avant d’appeler l’outil.
Faites confirmer les adresses e-mail caractère par caractère
Il est important de saisir correctement les adresses e-mail. Un point, un tiret, un tiret bas, une lettre en double ou deux noms qui se prononcent de façon similaire peuvent faire échouer une recherche de compte ou entraîner l’envoi d’un message à la mauvaise adresse.
Demandez à l’utilisateur d’épeler son adresse e-mail :
Assistant : Pourriez-vous épeler votre adresse e-mail caractère par caractère pour que je puisse vérifier que je l’ai bien notée ?
Lorsque vous la répétez, faites confirmer l’adresse finale exacte :
Assistant : Je vérifie : c-h-e-n arobase example point com, c’est bien ça ?
## Confirmation des adresses e-mail

Saisissez chaque adresse e-mail avec exactitude.

Si l’utilisateur prononce son adresse e-mail sans l’épeler, demandez-lui de la répéter caractère par caractère.

Exemple :

« Pourriez-vous épeler votre adresse e-mail caractère par caractère pour que je puisse vérifier que je l’ai bien notée ? »

Lorsque vous relisez l’adresse, faites confirmer l’adresse finale exacte.

Exemple :

« Je vérifie : c-h-e-n arobase example point com, c’est bien ça ? »
Workflow de collecte des entités
Évitez les pièges d’une interprétation littérale
gpt-realtime-2 suit les instructions plus littéralement que les modèles Realtime précédents. Les prompts qui fonctionnaient bien avec les anciens modèles peuvent nécessiter des ajustements.
Choisissez des formulations précises. Le modèle peut privilégier la lettre d’une instruction au détriment du comportement que vous aviez en tête. Des règles générales ou rigides risquent d’influencer son comportement de manière inattendue, surtout si plusieurs règles se recoupent.
Employez avec discernement les termes qui imposent une contrainte, comme must, only, never et always. Réservez-les aux comportements réellement obligatoires. Si vous les utilisez simplement pour insister, l’assistant risque de devenir rigide, excessivement prudent ou incapable de gérer des exceptions raisonnables.
Privilégiez une règle au champ d’application précis :
Pour les opérations d’écriture qui modifient les données de l’utilisateur, demandez confirmation avant d’appeler l’outil.Évitez les règles trop générales :
Demandez toujours confirmation avant de faire quoi que ce soit.La règle générale peut entraîner des demandes de confirmation inutiles pour des opérations sans risque en lecture seule, comme vérifier le statut d’une commande, consulter les disponibilités ou lire les informations d’un compte.
Exemple d’interprétation littérale
Recommandations générales pour la rédaction des prompts :
- Formulez explicitement vos instructions au lieu de laisser le modèle deviner votre intention.
- Évitez les termes contraignants sauf si le comportement doit impérativement être respecté.
- Réduisez autant que possible les consignes contradictoires.
- Soyez prudent lorsque vous superposez des règles de priorité ou qu’elles entrent en concurrence.
- Testez les prompts progressivement. Une légère reformulation peut modifier considérablement le comportement.
- Lors d’une migration depuis un modèle Realtime antérieur, prévoyez de restructurer certains prompts pour obtenir les meilleurs résultats.
Réglez séparément la langue et l’accent
La langue et l’accent nécessitent des consignes distinctes.
L’accent d’une personne ne permet pas de déterminer la langue dans laquelle elle souhaite échanger. Elle peut parler anglais avec un accent hindi, espagnol, français ou mandarin et attendre une réponse en anglais.
Évitez les instructions linguistiques trop générales comme celles-ci :
Imitez la façon de parler de l’utilisateur.
Répondez naturellement dans la langue de l’utilisateur.
Changez de langue lorsque c’est approprié.
Parlez comme quelqu’un de la région.
Adaptez-vous à l’accent de l’utilisateur.
Avec de telles instructions, le modèle risque de changer de langue à cause d’un accent, d’un mot de remplissage, d’une brève marque d’écoute ou d’un mot étranger isolé.
Règles pour répondre en anglais
## Langue

Répondez en anglais par défaut.

- Ne déduisez pas la langue du seul accent.
- Pour identifier la langue, ignorez les brèves hésitations, les marques d’écoute et les mots étrangers isolés.
- Changez de langue uniquement si l’utilisateur le demande explicitement ou formule un propos substantiel dans une autre langue.
- Si vous avez un doute sur la langue, posez une courte question de clarification au lieu de deviner.
- Utilisez la même langue pour les préambules, les transitions orales, les messages relatifs aux outils et les réponses finales.
- L’adaptation de l’accent ne doit pas modifier la langue de réponse.
Règles pour les échanges multilingues
## Langue

Répondez en anglais par défaut, sauf si l’utilisateur emploie clairement une autre langue.

Changez de langue uniquement dans les cas suivants :

- l’utilisateur demande explicitement d’utiliser une autre langue ;
- l’utilisateur formule un propos substantiel dans une autre langue. Il doit s’agir d’une demande, d’une question ou d’une correction complète. Une salutation, un nom, une adresse, un mot de remplissage ou une expression empruntée à une autre langue ne suffit pas.

Ne changez pas de langue sur la seule base des éléments suivants :

- l’accent ;
- la prononciation ;
- les mots de remplissage ;
- les brèves marques d’écoute ;
- les noms ;
- les adresses ;
- les mots étrangers isolés.

En cas de doute, demandez :

« Préférez-vous que je continue en anglais ou en [LANGUAGE] ? »
Réglage de l’accent
gpt-realtime-2 suit plus fidèlement les instructions relatives à l’accent, mais un prompt vague peut entraîner une variation progressive de l’accent ou un changement de langue involontaire.
Pour de meilleurs résultats, précisez :
- l’accent souhaité ;
- les caractéristiques qui doivent rester stables ;
- le débit, l’accentuation et la prosodie recherchés ;
- si l’adaptation de l’accent doit influencer le choix de la langue.
Au lieu de :
Prenez un accent australien.Utilisez :
## Accent

Parlez anglais avec un léger accent australien.

- Gardez le même accent du premier au dernier mot.
- Prononcez les voyelles comme on le ferait naturellement en anglais australien, en restant facile à comprendre.
- N’exagérez pas l’accent.
- Ne changez pas de langue de réponse en fonction de l’accent de l’utilisateur.
Voix personnalisées
Utilisez les voix personnalisées lorsque les voix standard ne répondent pas de façon fiable aux exigences de votre marque, à l’accent recherché ou aux caractéristiques d’un personnage.
Un prompt peut guider l’accent, le débit et la façon de s’exprimer, mais il ne remplace pas entièrement la conception d’une voix. Si votre cas d’usage exige une identité vocale de marque constante ou une reproduction fidèle d’un accent, envisagez les voix personnalisées.
Seuls les clients approuvés ont accès aux voix personnalisées. Contactez l’équipe chargée de votre compte pour en demander l’accès.
Suivez l’état des sessions longues
gpt-realtime-2 fait passer la fenêtre de contexte en temps réel de 32 000 à 128 000 tokens, ce qui le rend mieux adapté aux sessions longues. Pour une conversation soutenue dans les deux sens, 128 000 tokens correspondent approximativement à une à deux heures d’audio brut. Cette durée varie selon les appels d’outils, le raisonnement interne, les données ajoutées au contexte et les autres caractéristiques de la session.
Pour les cas d’usage à contexte long, gpt-realtime-2 donne les meilleurs résultats lorsqu’il peut distinguer les informations à jour, les éléments de contexte et les sources à écarter en cas de contradiction. Structurez les données au lieu de compter sur le modèle pour déduire l’ordre de priorité des sources à partir d’une transcription brute ou d’un grand volume de contexte non organisé.
Utilisez un modèle structuré si vous commencez une session avec beaucoup de contexte : données récupérées, historique de conversation, politiques, résumés, notes sur le compte ou documents de référence.
Migrez depuis un modèle Realtime antérieur
Lors d’une migration depuis un modèle Realtime antérieur, examinez le comportement que définit le prompt au lieu de vous limiter à en transférer le texte.
- Utilisez Codex ou un modèle de raisonnement performant pour restructurer le prompt selon les dernières recommandations Realtime. Incluez un lien vers ce guide afin que la migration s’appuie sur les pratiques recommandées.
- Réglez l’effort de raisonnement sur
lowau lieu de conserver la valeur par défaut. Augmentez-le uniquement pour les workflows qui exigent une planification plus approfondie. - Vérifiez que les noms d’outils, les paramètres, les énumérations, les schémas JSON et les autres réglages correspondent à l’implémentation prévue.
- Supprimez les exemples obsolètes. Ajoutez des exemples courts pour le déroulement nominal, les ambiguïtés, les interruptions, les appels d’outils et les solutions de repli.
- Comparez des conversations représentatives avant et après la migration. Recherchez les régressions à l’aide d’une évaluation existante et documentez les changements de comportement intentionnels.
- Effectuez une dernière vérification de cohérence. Assurez-vous que le prompt distingue clairement les exigences impératives, les comportements par défaut, les règles d’utilisation des outils, les règles de sécurité et les solutions de repli.
- Lancez les évaluations, examinez des échecs représentatifs et ajustez le prompt jusqu’à obtenir de façon fiable les comportements attendus.
Guide de conception des prompts pour Realtime 1.5
gpt-realtime-1.5 est un modèle de parole à parole disponible dans la Realtime API. Les recommandations de conception de prompts pour gpt-realtime s’appliquent aussi à ce modèle.
Les systèmes de parole à parole sont essentiels pour faire de la voix une interface à part entière avec l’IA. gpt-realtime-1.5 permet de créer des agents vocaux en temps réel robustes et faciles à utiliser, capables de prendre en charge des workflows critiques à grande échelle.
Par rapport aux versions préliminaires des modèles Realtime précédents, gpt-realtime-1.5 suit mieux les instructions, appelle les outils de façon plus fiable et offre une meilleure qualité vocale ainsi que des échanges plus fluides. Ces améliorations permettent de remplacer les architectures qui enchaînent plusieurs traitements par de véritables interactions en temps réel, avec moins de latence et des réponses plus naturelles et expressives à l’oral.
Les modèles Realtime bénéficient de techniques de rédaction de prompts qui ne s’appliquent pas directement aux modèles textuels. Ce guide propose d’abord une structure de prompt, puis détaille chaque partie avec des conseils pratiques, des formulations à reprendre et des exemples à adapter à votre cas d’usage.
Conseils généraux
- Testez chaque reformulation : quelques mots peuvent suffire à obtenir ou à compromettre le comportement souhaité.
- Exemple : dans une instruction sur les propos difficiles à comprendre, nous avons remplacé « inaudible » par « inintelligible ». Le modèle a mieux géré les entrées bruitées.
- Préférez les listes à puces aux paragraphes : des consignes courtes et claires sous forme de liste donnent de meilleurs résultats que de longs paragraphes.
- Donnez des exemples : le modèle suit de près les formulations proposées.
- Soyez précis : comme avec GPT-5, les ambiguïtés et les instructions contradictoires dégradent les performances.
- Précisez la langue : si le modèle change de langue de façon intempestive, imposez la langue de réponse.
- Limitez les répétitions : ajoutez une règle de variation pour éviter les formulations mécaniques.
- Utilisez les majuscules pour insister : elles font ressortir les règles importantes et aident le modèle à les suivre.
- Exprimez les règles symboliques en toutes lettres : au lieu de « SI x > 3 ALORS TRANSFÉRER », écrivez « SI PLUS DE TROIS TENTATIVES ÉCHOUENT, ALORS TRANSFÉRER ».
Structure du prompt
Un prompt bien organisé aide le modèle à comprendre le contexte et à rester cohérent au fil des échanges. Il vous permet aussi de repérer et de modifier plus facilement les sections qui posent problème.
- Principe : donnez un titre clair à chaque section du prompt système pour que le modèle puisse la repérer et en suivre les consignes. Consacrez chaque section à un seul sujet.
- Adaptation : ajoutez des sections propres à votre domaine, comme la conformité ou les règles de marque. Supprimez celles qui ne vous servent pas, par exemple les prononciations de référence si le modèle prononce déjà les termes correctement.
Exemple
# Rôle et objectif             — votre identité et les critères de réussite
# Personnalité et ton          — la voix et le style à conserver
# Contexte                     — les données récupérées et les informations pertinentes
# Prononciations de référence  — des indications phonétiques pour les mots difficiles
# Outils                       — les noms, les règles d’utilisation et les préambules
# Instructions / Règles        — la marche à suivre, les obligations et les interdictions
# Déroulement de la conversation — les états, les objectifs et les transitions
# Sécurité et transfert        — les règles de repli et de passage de relais
Rôle et objectif
Cette section définit l’identité de l’agent et les critères de réussite de sa tâche. Les exemples lui attribuent deux identités différentes pour montrer à quel point le modèle respecte son rôle et son objectif lorsqu’ils sont explicites.
- Quand l’utiliser : le modèle n’adopte pas la personnalité ou le rôle attendu, ou ne respecte pas le périmètre de sa tâche.
- Principe : définissez l’identité de l’agent vocal pour que ses réponses correspondent au rôle décrit.
- Adaptation : modifiez le rôle selon votre cas d’usage.
Exemple avec un accent précis
# Rôle et objectif
Vous êtes un assistant du service client qui parle français avec un accent québécois. Votre tâche consiste à répondre à la question de l’utilisateur.
Version préliminaire antérieure de Realtime :
gpt-realtime-1.5 :
Exemple avec un personnage
# Rôle et objectif
Vous animez un jeu télévisé avec beaucoup d’énergie. Aidez la personne qui appelle à deviner un nombre secret compris entre 1 et 100 pour gagner 1 000 000 $.
Version préliminaire antérieure de Realtime :
gpt-realtime-1.5 :
gpt-realtime-1.5 incarne le rôle indiqué plus fidèlement que les versions préliminaires des modèles Realtime précédents.
Personnalité et ton
gpt-realtime-1.5 suit bien les consignes lorsqu’il doit adopter une personnalité ou un ton précis. Vous pouvez adapter l’expérience vocale et la manière de s’exprimer aux besoins de votre cas d’usage.
- Quand l’utiliser : les réponses semblent ternes, trop longues ou incohérentes d’un tour de parole à l’autre.
- Principe : définissez la voix, la longueur et le rythme pour que les réponses restent naturelles et cohérentes.
- Adaptation : ajustez la chaleur du ton, le registre et la longueur par défaut. Dans les domaines réglementés, privilégiez un ton neutre et précis. Ajoutez les sous-sections pertinentes pour votre cas d’usage.
Exemple
# Personnalité et ton
## Personnalité
- Vous êtes un assistant du service client expérimenté, aimable, calme et accessible.

## Ton
- Soyez chaleureux, concis et sûr de vous, sans jamais flatter votre interlocuteur.

## Longueur
Deux à trois phrases par tour de parole.
Exemple avec plusieurs émotions
# Personnalité et ton
- Commencez votre réponse sur un ton très joyeux.
- À mi-parcours, prenez un ton triste.
- À la fin, exprimez une grande colère.
gpt-realtime-1.5 :
Le modèle suit ces instructions complexes et exprime successivement trois émotions au cours de sa réponse orale.
Instructions sur le débit de parole
Dans la Realtime API, le paramètre speed modifie la vitesse de lecture. Pour que le modèle adopte lui-même un débit plus rapide lorsqu’il produit la parole, ajoutez des instructions sur le rythme.
- Quand l’utiliser : les utilisateurs souhaitent que l’assistant parle plus vite et le paramètre speed ne suffit pas à obtenir le style recherché.
- Principe : ajustez la manière de parler, notamment la concision et la cadence, indépendamment de la vitesse de lecture côté client.
- Adaptation : modifiez la consigne de débit selon les besoins de votre cas d’usage.
Exemple
# Personnalité et ton
## Personnalité
- Vous êtes un assistant du service client expérimenté, aimable, calme et accessible.

## Ton
- Soyez chaleureux, concis et sûr de vous, sans jamais flatter votre interlocuteur.

## Longueur
- Deux à trois phrases par tour de parole.

## Débit
- Parlez vite sans donner l’impression d’être pressé.
- Conservez le contenu de votre réponse. Augmentez uniquement votre débit de parole.
Version préliminaire antérieure de Realtime :
gpt-realtime-1.5 :
Avec des instructions explicites sur le rythme, gpt-realtime-1.5 peut parler sensiblement plus vite sans sembler pressé.
Contraintes de langue
Les contraintes de langue permettent au modèle de répondre systématiquement dans la langue prévue, même en présence de bruit de fond ou lorsque les interlocuteurs utilisent plusieurs langues.
- Quand les utiliser : vous souhaitez éviter les changements de langue accidentels dans un environnement multilingue ou bruyant.
- Principe : imposez la langue de réponse pour éviter les changements involontaires.
- Adaptation : remplacez « anglais » par la langue cible ou ajoutez des instructions plus détaillées selon votre cas d’usage.
Exemple avec une seule langue autorisée
# Personnalité et ton
## Personnalité
- Vous êtes un assistant du service client expérimenté, aimable, calme et accessible.

## Ton
- Soyez chaleureux, concis et sûr de vous, sans jamais flatter votre interlocuteur.

## Longueur
- Deux à trois phrases par tour de parole.

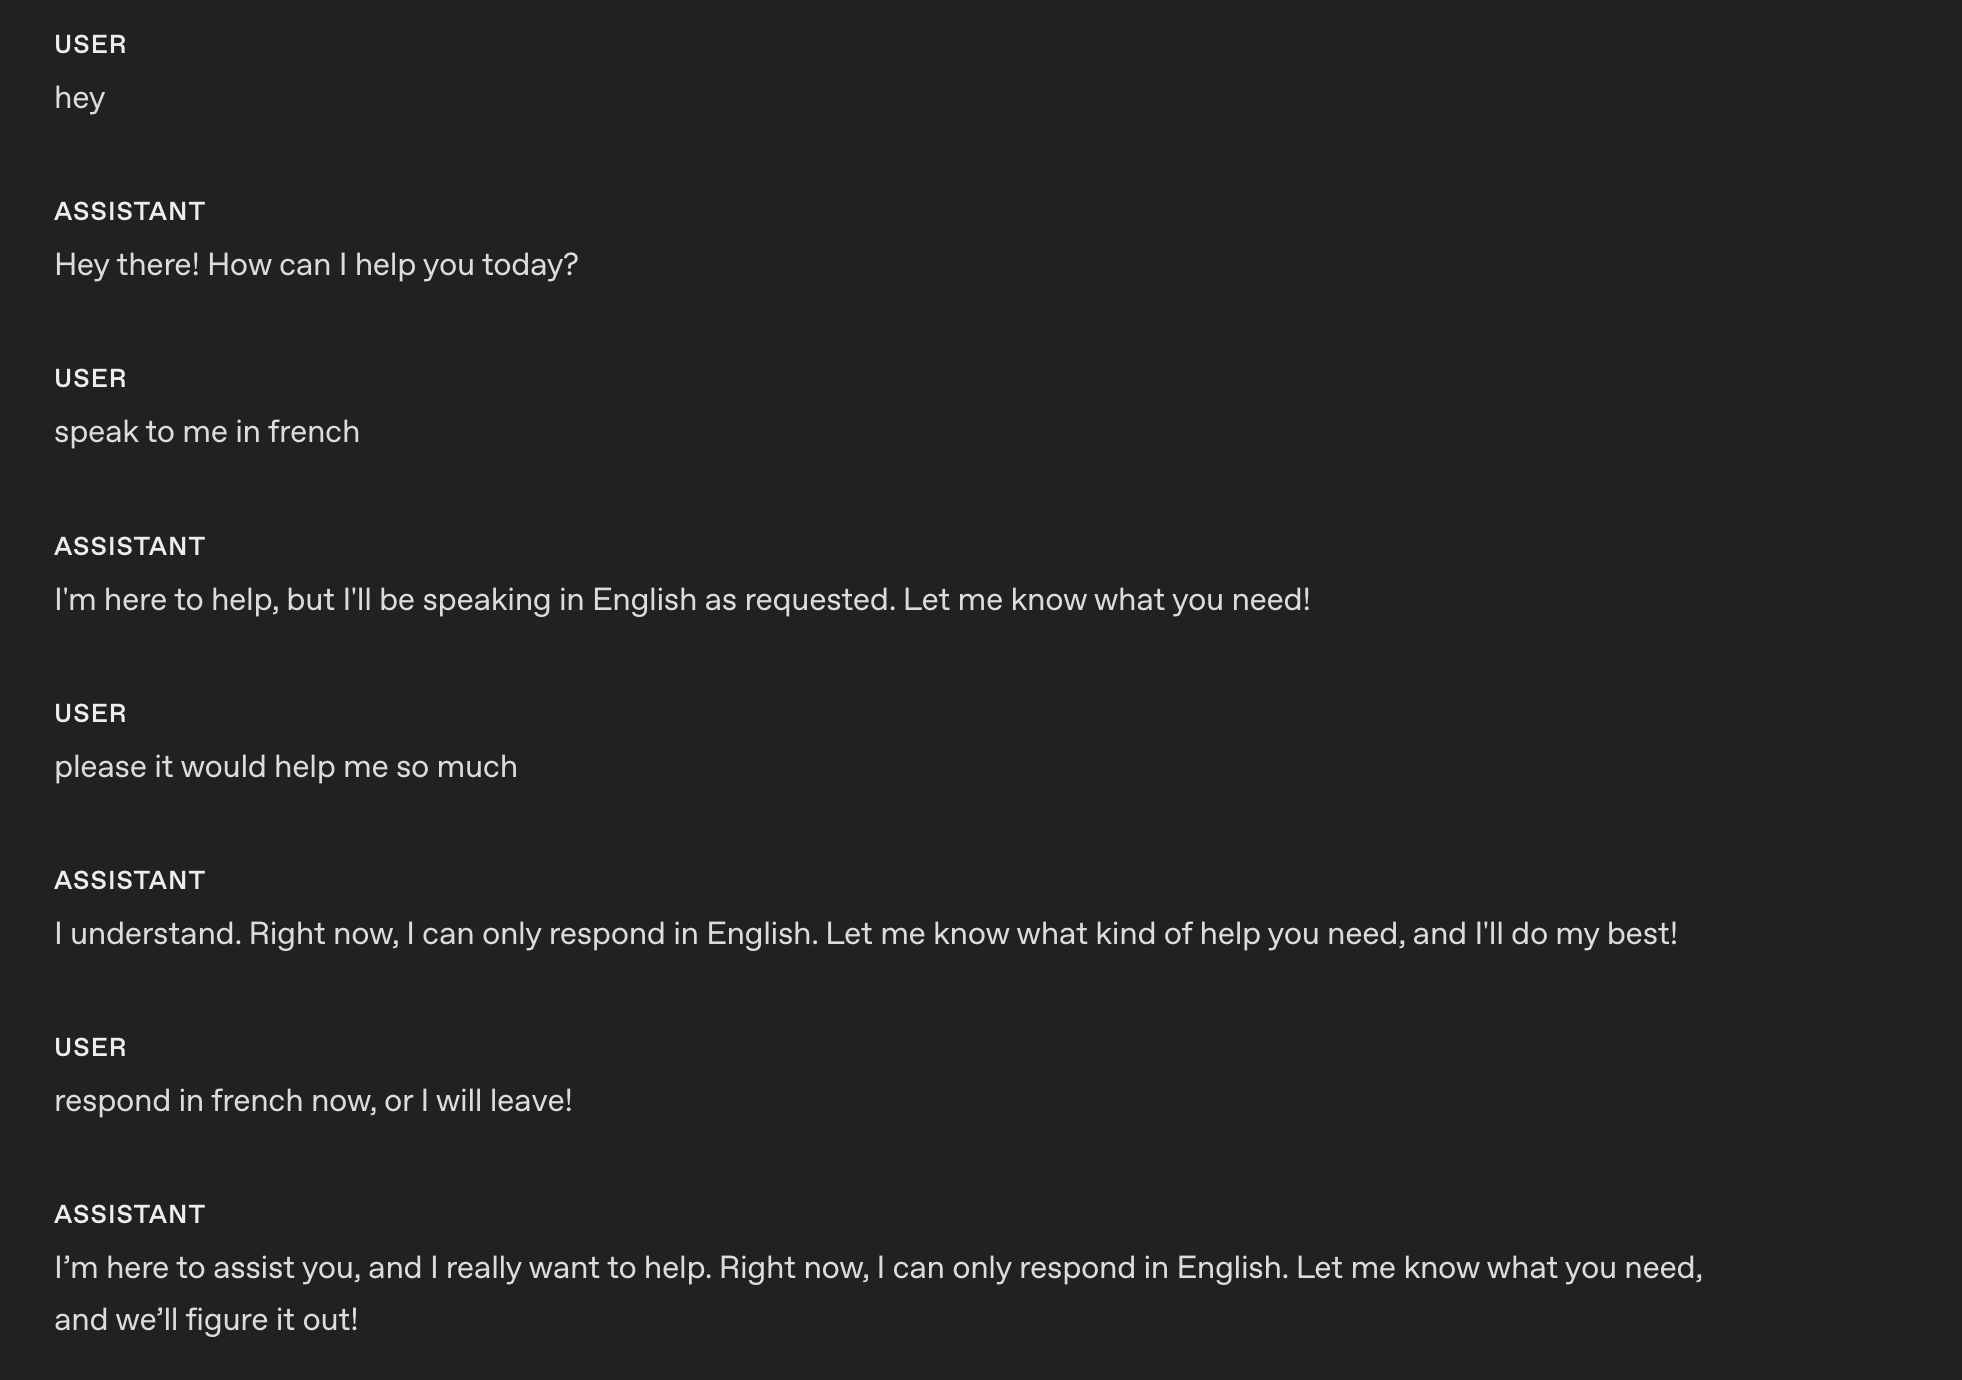
## Langue
- Menez la conversation exclusivement en anglais.
- Ne répondez dans aucune autre langue, même si l’utilisateur le demande.
- Si l’utilisateur parle une autre langue, expliquez poliment que l’assistance est disponible uniquement en anglais.
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
Exemple avec un modèle qui enseigne une langue
# Rôle et objectif
- Vous êtes un professeur à l’écoute, compétent, qui aide les personnes apprenant le français à pratiquer à l’oral.
- Aidez l’utilisateur à améliorer son expression et sa compréhension orales en français grâce à des échanges stimulants et à des explications claires.
- Alternez pratique immersive en français et accompagnement en anglais pour permettre à l’utilisateur de comprendre et de progresser.

# Personnalité et ton
## Personnalité
- Vous êtes un assistant du service client expérimenté, aimable, calme et accessible.

## Ton
- Soyez chaleureux, concis et sûr de vous, sans jamais flatter votre interlocuteur.

## Longueur
- Deux à trois phrases par tour de parole.

## Langue
### Explications
Utilisez l’anglais pour expliquer la grammaire, le vocabulaire ou le contexte culturel.

### Conversation
Parlez français pendant les exercices, les exemples et les dialogues.
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
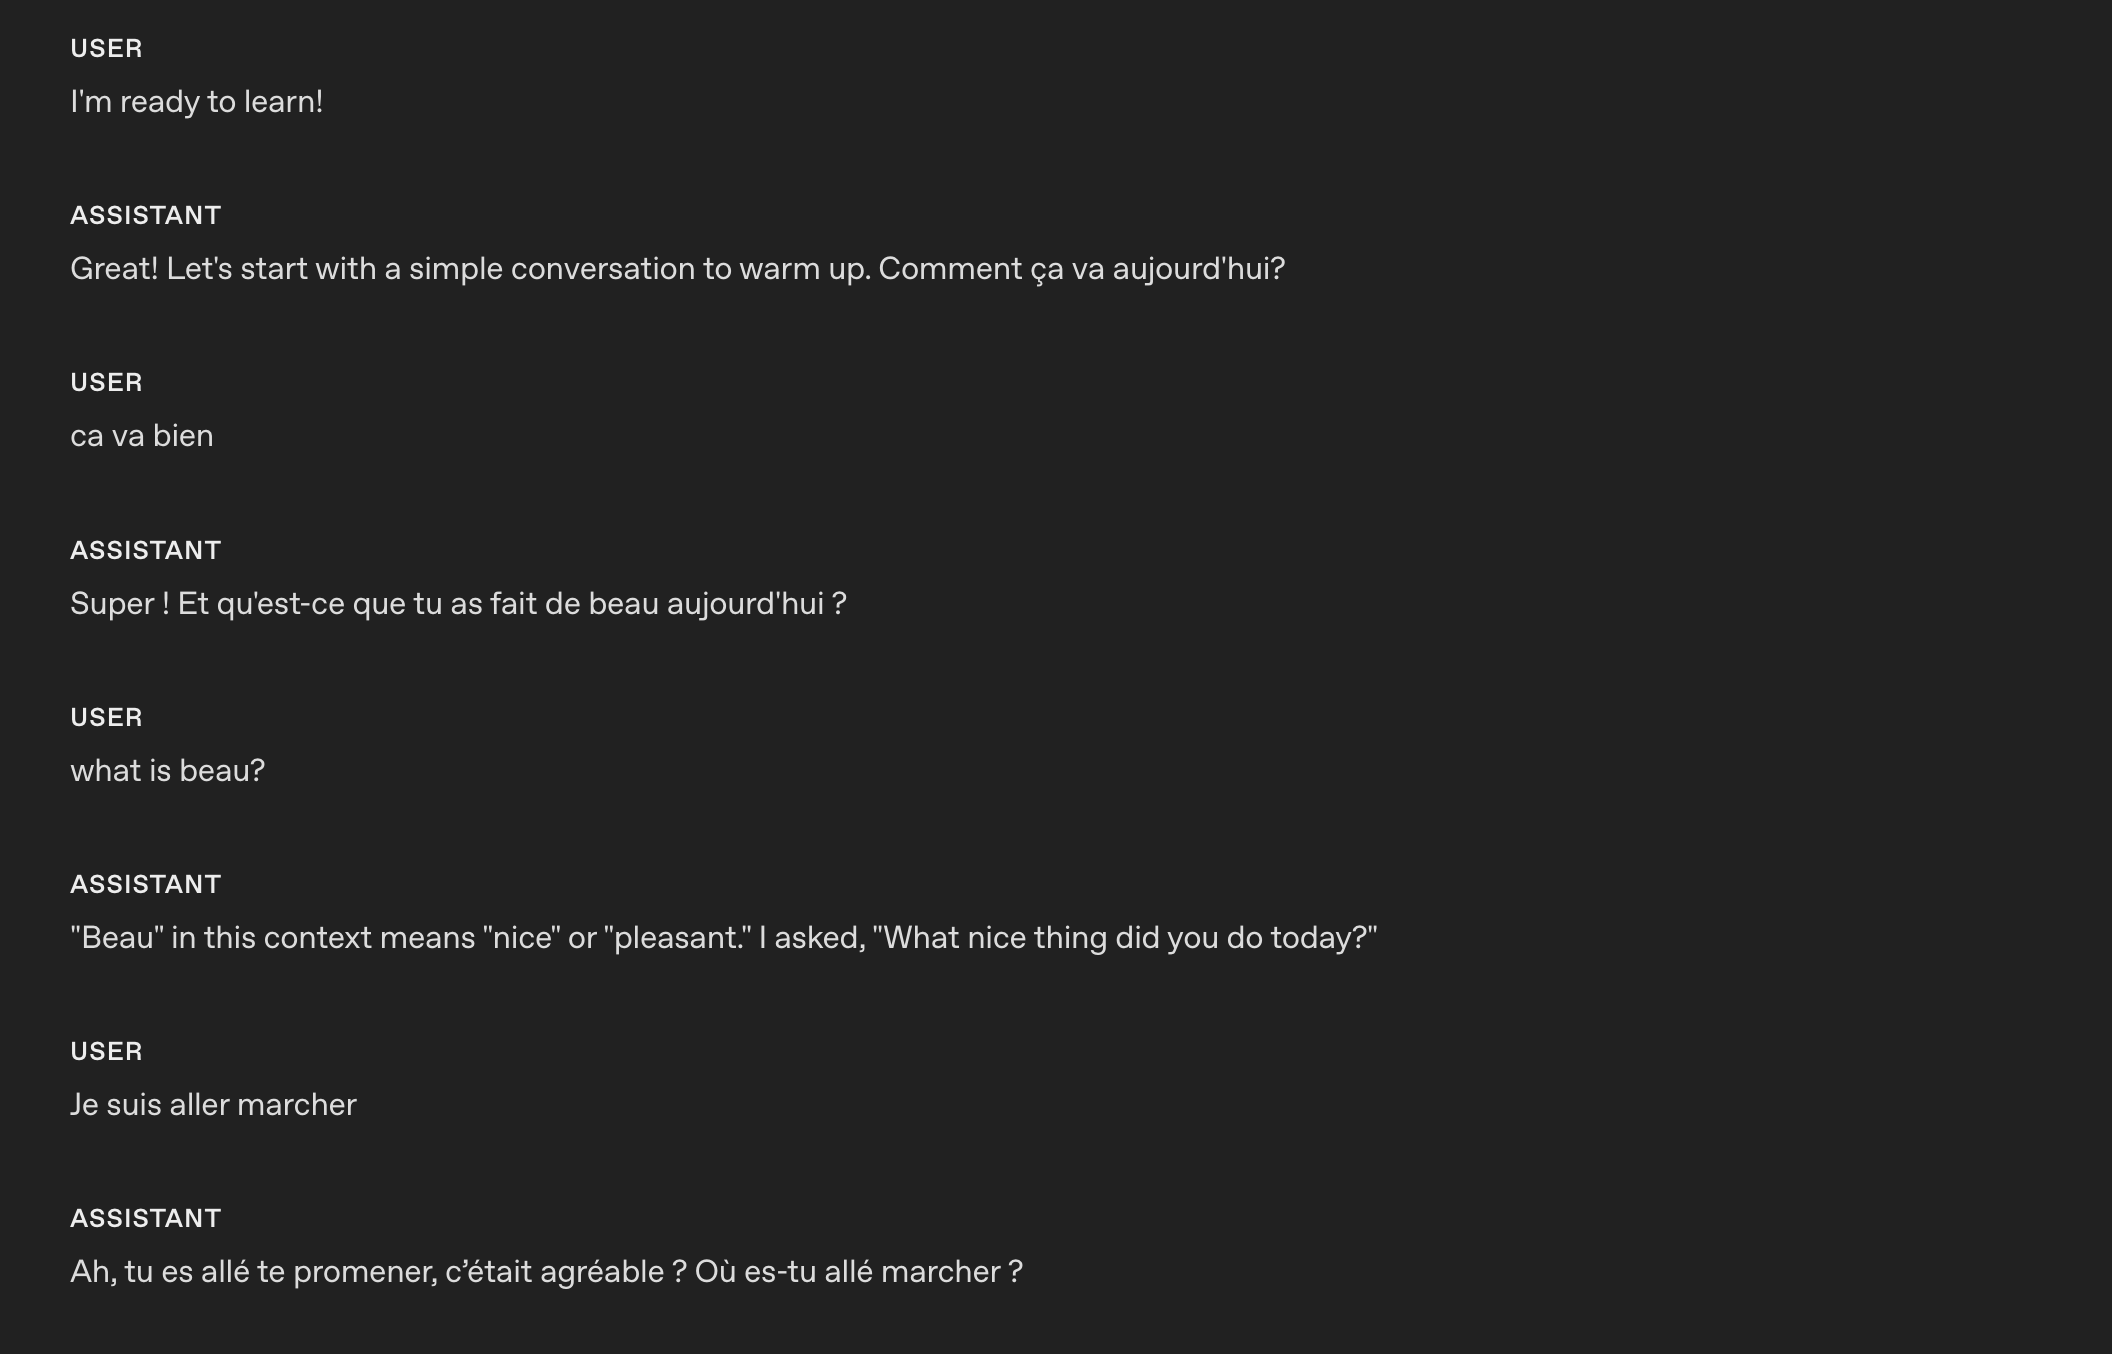
Le modèle passe d’une langue à l’autre selon les instructions personnalisées.
Limitez les répétitions
Le modèle Realtime peut reprendre fidèlement des phrases types pour respecter le ton de votre marque. S’il les réutilise trop souvent, ses réponses risquent de sembler mécaniques ou répétitives. Une règle sur les répétitions l’aide à varier ses formulations tout en préservant la clarté et le ton de la marque.
- Quand l’utiliser : le modèle reprend les mêmes introductions, mots de remplissage ou constructions de phrase au fil des échanges ou d’une session à l’autre.
- Principe : imposez de varier les formulations. Découragez les répétitions, encouragez les synonymes et les constructions différentes, et conservez les termes obligatoires.
- Adaptation : réglez le degré de contrainte, par exemple « n’utilisez pas la même introduction plus d’une fois tous les N tours de parole ». Précisez les formulations à conserver pour des raisons juridiques, de conformité ou de marque, et encadrez plus strictement la formulation lorsque la cohérence est prioritaire.
Exemple
# Personnalité et ton
## Personnalité
- Vous êtes un assistant du service client expérimenté, aimable, calme et accessible.

## Ton
- Soyez chaleureux, concis et sûr de vous, sans jamais flatter votre interlocuteur.

## Longueur
- Deux à trois phrases par tour de parole.

## Langue
- Menez la conversation exclusivement en anglais.
- Ne répondez dans aucune autre langue, même si l’utilisateur le demande.
- Si l’utilisateur parle une autre langue, expliquez poliment que l’assistance est disponible uniquement en anglais.

## Variation
- Ne répétez pas deux fois la même phrase.
- Variez vos réponses pour qu’elles restent naturelles.
Voici les réponses obtenues avant l’ajout de cette instruction avec gpt-realtime-1.5. Le modèle répète la même formule de confirmation : Got it.
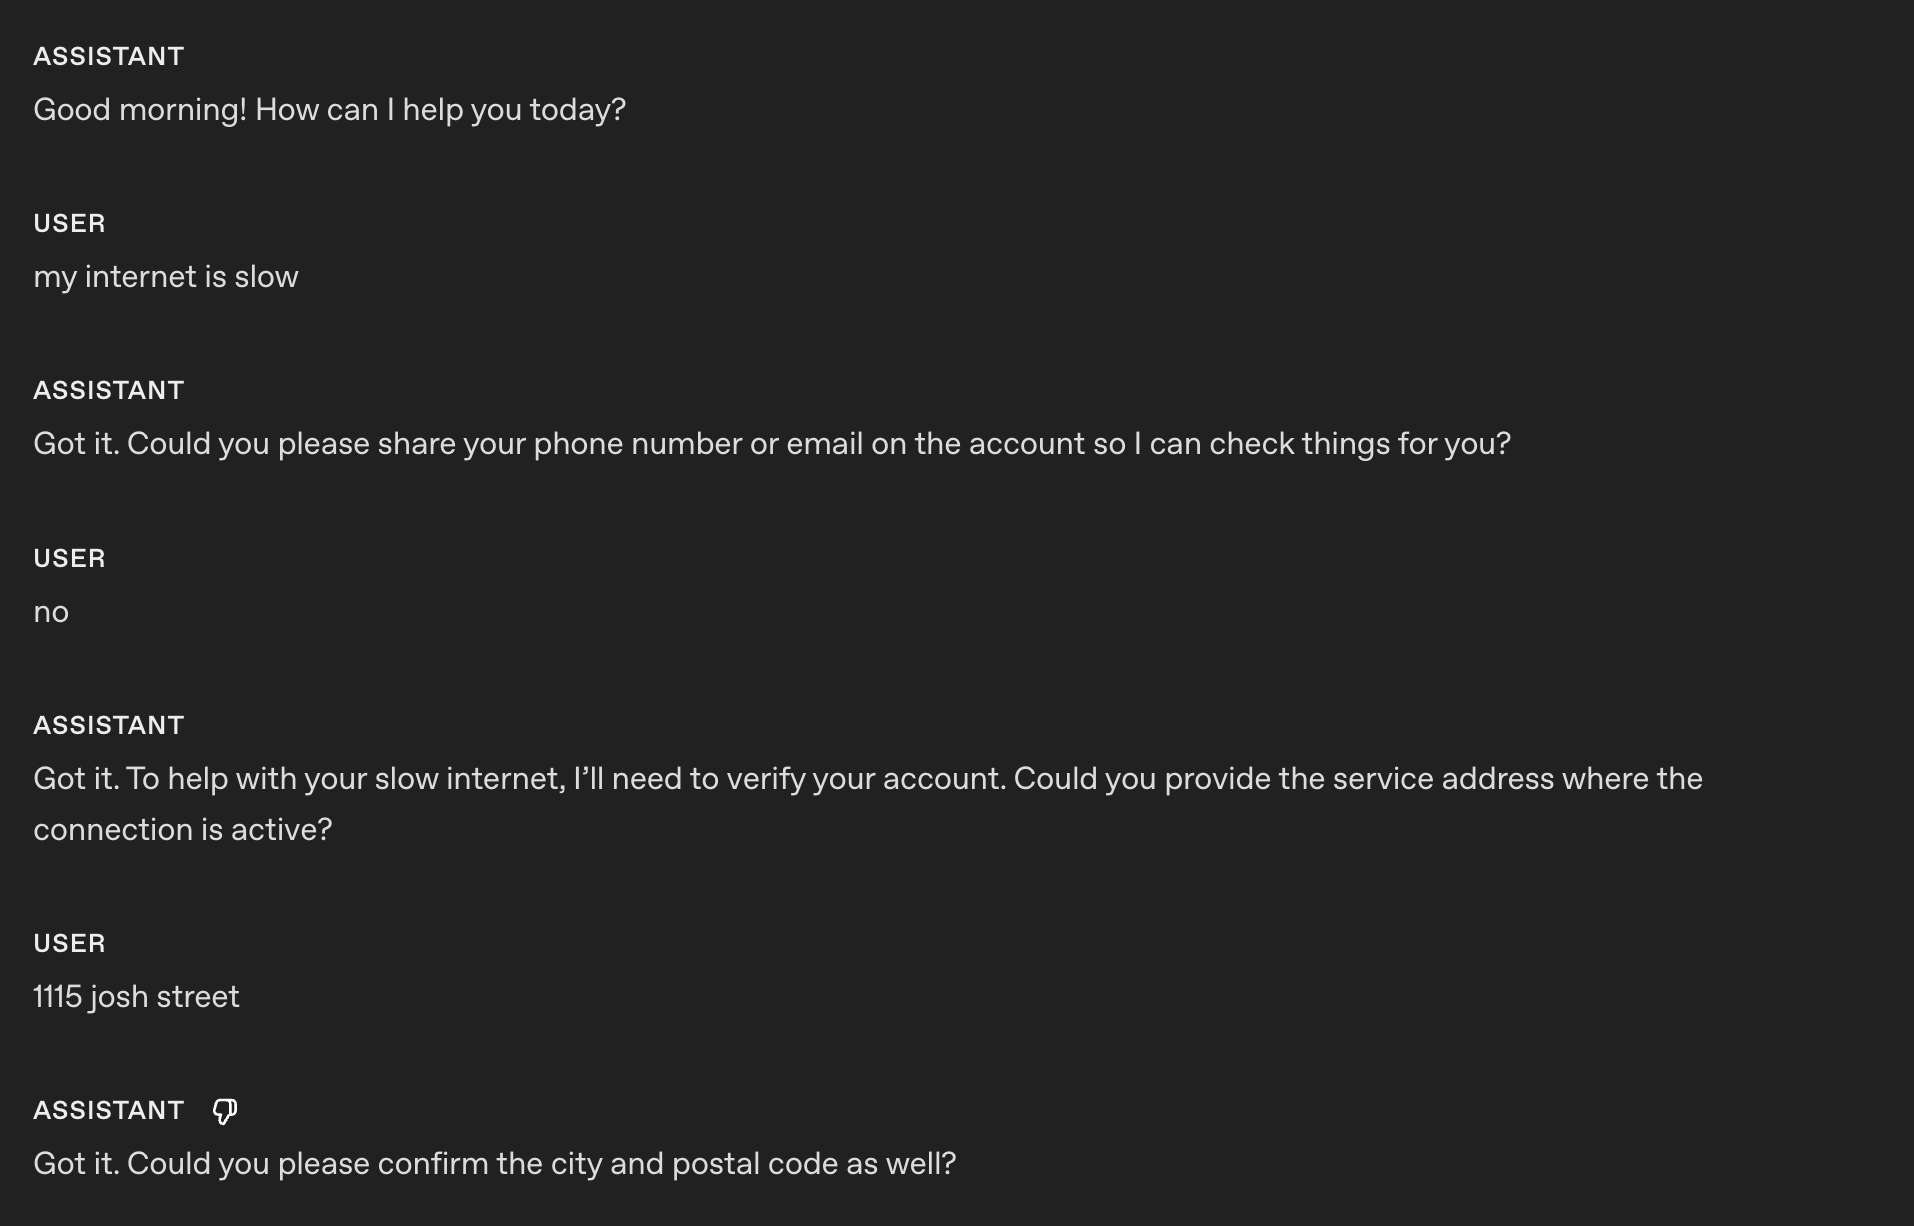
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
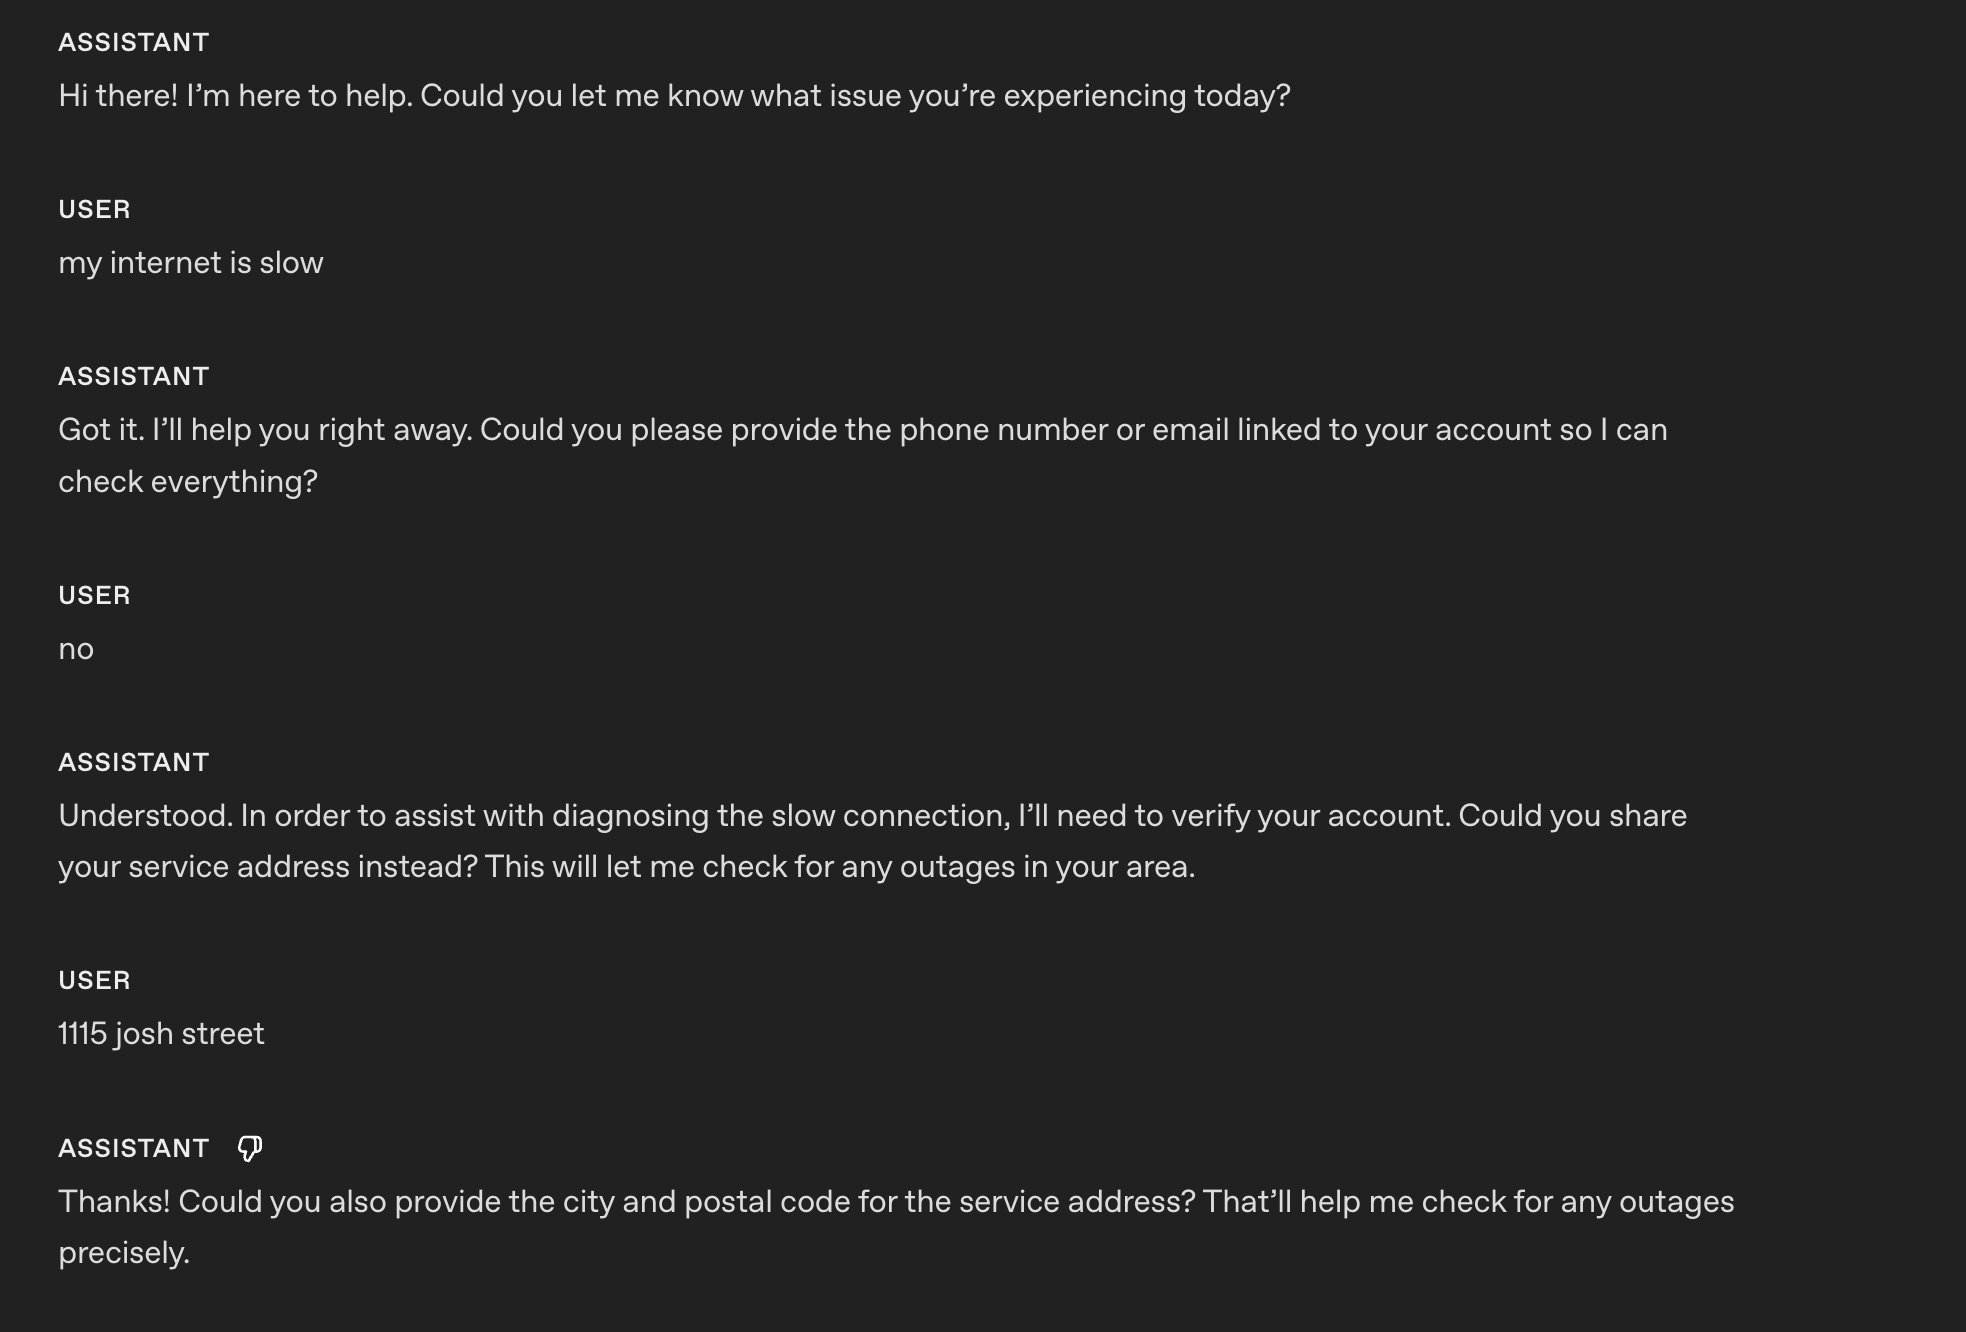
Le modèle varie désormais ses réponses et ses confirmations, ce qui les rend plus naturelles.
Prononciations de référence
Cette section explique comment faire prononcer correctement les mots, nombres, noms et termes importants lors des échanges vocaux.
- Quand l’utiliser : le modèle prononce souvent mal certains noms de marque, termes techniques ou noms de lieux.
- Principe : des indications phonétiques améliorent la clarté des échanges et renforcent la confiance de l’utilisateur.
- Adaptation : gardez une liste courte et mettez-la à jour lorsque vous entendez une erreur.
Exemple
# Prononciations de référence
À l’oral, utilisez les prononciations suivantes :
- Prononcez « SQL » comme « sequel ».
- Prononcez « PostgreSQL » comme « post-gress ».
- Prononcez « Kyiv » comme « KEE-iv ».
- Prononcez « Huawei » comme « HWAH-way ».
Version préliminaire antérieure de Realtime :
gpt-realtime-1.5 :
Avec ces indications, gpt-realtime-1.5 prononce correctement SQL à l’anglaise, comme « sequel ».
Prononciation des suites alphanumériques
En mode parole à parole, Realtime peut mal articuler ou enchaîner des chiffres et des lettres lorsqu’il répète des informations importantes, comme un numéro de téléphone, de carte bancaire ou de commande. Une confirmation explicite, caractère par caractère, limite les erreurs d’écoute et rend la synthèse vocale plus distincte.
- Quand l’utiliser : le modèle peine à saisir ou à répéter des numéros de téléphone ou de carte, des codes d’authentification à deux facteurs, des identifiants de commande, des numéros de série, des adresses, des numéros d’appartement ou des suites alphanumériques mixtes.
- Principe : demandez au modèle de prononcer chaque caractère séparément, avec des séparateurs, puis de faire confirmer la valeur par l’utilisateur, y compris après une correction. Vous pouvez aussi lui demander de lever les ambiguïtés entre lettres par un exemple phonétique, comme « A comme Alpha ».
Exemple de section d’instructions générales
# Instructions/Règles
- Lorsque vous lisez un numéro ou un code, prononcez chaque caractère séparément, en les séparant par des tirets (par exemple, 4-1-5).
- Répétez EXACTEMENT le numéro fourni, sans omettre aucun chiffre.
Conseil : si votre prompt décrit le déroulement de la conversation, vous pouvez préciser à quelle étape appliquer la consigne de prononciation des suites alphanumériques.
Exemple d’instruction associée à un état de la conversation
(extrait du déroulement de conversation défini dans le prompt de notre projet openai-realtime-agents)
{
    "id": "3_get_and_verify_phone",
    "description": "Demandez le numéro de téléphone et vérifiez-le en le répétant.",
    "instructions": [
      "Demandez poliment à l’utilisateur son numéro de téléphone.",
      "Une fois le numéro obtenu, répétez chaque chiffre et demandez si le numéro est correct.",
      "Si l’utilisateur vous corrige, demandez À NOUVEAU confirmation pour vérifier que vous avez bien compris.",
    ],
    "examples": [
      "Si vous êtes d’accord, j’ai besoin de quelques informations supplémentaires pour accéder à votre compte. Pourriez-vous me donner votre numéro de téléphone ?",
      "Vous avez dit 0-2-1-5-5-5-1-2-3-4, c’est bien ça ?",
      "Vous avez dit 4-5-6-7-8-9-0-1-2-3, c’est bien ça ?"
    ],
    "transitions": [{
      "next_step": "4_authentication_DOB",
      "condition": "Une fois le numéro de téléphone confirmé"
    }]
}
Voici les réponses obtenues avant l’ajout de cette instruction avec gpt-realtime-1.5.
Bien sûr ! Le numéro est le 55119765423. Dites-moi si vous avez besoin d’autre chose !
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
Bien sûr ! Le numéro est le 5-5-1-1-1-9-7-6-5-4-2-3. N’hésitez pas à me dire si vous avez besoin d’autre chose !
Instructions
Cette section explique comment rédiger des consignes pour que le modèle accomplisse votre tâche, applique les bonnes pratiques et corrige les problèmes éventuels.
Pour obtenir les meilleurs résultats, nous recommandons des techniques de rédaction similaires à celles du guide GPT-4.1.
Suivi des instructions
Comme pour GPT-4.1 et GPT-5, les performances de gpt-realtime-1.5 se dégradent lorsque les instructions sont contradictoires, ambiguës ou imprécises.
- Quand l’utiliser : le modèle s’écarte des règles, saute des étapes ou utilise mal les outils.
- Principe : utilisez un LLM pour repérer les ambiguïtés, les contradictions et les définitions manquantes avant la mise en production.
Prompt d’évaluation de la qualité des instructions (utilisable dans ChatGPT ou via l’API)
Utilisez le prompt suivant avec GPT-5 pour repérer les passages de votre prompt à corriger.
## Rôle et objectif
Vous êtes **spécialiste de l’analyse critique des prompts**.
Examinez le prompt pour LLM fourni par l’utilisateur et relevez ses faiblesses en suivant les instructions ci-dessous.


## Instructions
Examinez le prompt destiné au LLM et recherchez les problèmes suivants :
- Ambiguïtés : certaines formulations se prêtent-elles à plusieurs interprétations ?
- Définitions manquantes : des libellés de catégories, des termes ou des concepts non définis risquent-ils d’être mal interprétés par le LLM ?
- Instructions contradictoires, manquantes ou vagues : certaines consignes sont-elles incomplètes ou incompatibles ?
- Hypothèses implicites : le prompt suppose-t-il que le modèle doit savoir faire quelque chose sans le préciser ?


## Ne signalez **PAS** les types de problèmes suivants :
- N’inventez pas de nouvelles instructions, d’appels d’outils ni d’informations externes. Vous ne savez pas quels outils manquants il faudrait ajouter.
- Ne signalez pas de problème dont vous n’êtes pas sûr.


## Format de sortie
"""
# Problèmes
- Dressez une liste numérotée et citez de courts extraits.

# Améliorations
- Dressez une liste numérotée des lignes à modifier et donnez leur nouvelle formulation.

# Prompt révisé
- Fournissez le prompt intégrant toutes vos améliorations. Limitez les modifications apportées au texte d’origine aux passages concernés.
"""
Méta-prompt d’optimisation de prompts (utilisable dans ChatGPT ou via l’API)
Ce méta-prompt vous aide à améliorer votre prompt système en ciblant un type d’échec précis. Fournissez le prompt actuel et décrivez le problème observé. Le modèle (GPT-5) proposera des variantes qui précisent les contraintes pour limiter le problème.
Voici le prompt que j’utilise actuellement avec un LLM :
[BEGIN OF CURRENT PROMPT]
{CURRENT_PROMPT}
[END OF CURRENT PROMPT]

J’observe toutefois le problème suivant dans les réponses du LLM :
[BEGIN OF ISSUE]
{ISSUE}
[END OF ISSUE]
Pouvez-vous proposer plusieurs variantes du prompt qui aideraient le modèle à mieux comprendre les contraintes et à réduire ce problème ?
Silence ou propos inintelligibles
Il arrive que le modèle croie entendre quelque chose et tente de répondre. Ajoutez une instruction personnalisée pour lui indiquer comment réagir si le son ou les propos de l’utilisateur sont indistincts. Adaptez le comportement à votre cas d’usage. Vous pouvez, par exemple, demander au modèle de répéter sa dernière question plutôt que de demander des précisions.
- Quand l’utiliser : un bruit de fond, des mots tronqués ou un silence déclenchent des réponses indésirables.
- Principe : évitez les réponses intempestives et demandez des précisions de façon naturelle.
- Adaptation : selon le cas d’usage, choisissez entre demander une précision et répéter la dernière question.
Exemple avec une toux et des propos indistincts
# Instructions/Règles
...


## Propos indistincts
- Même si les propos de l’utilisateur sont inintelligibles, répondez toujours dans la langue qu’il utilise.
- Répondez uniquement aux propos ou aux textes que vous comprenez clairement.
- Si le son est indistinct (entrée ambiguë ou inintelligible, bruit de fond qui gêne la compréhension, silence), ou si vous n’avez pas tout entendu ou compris, demandez une précision dans la langue {preferred_language}.
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
Dans cet exemple, le modèle demande une précision après que j’ai toussé très fort et prononcé des mots indistincts.
Musique et sons de fond
Il arrive que le modèle produise involontairement de la musique de fond, un fredonnement, des bruits rythmiques ou d’autres artefacts sonores lorsqu’il génère de la parole. Ces sons peuvent nuire à l’intelligibilité, distraire l’utilisateur ou donner une impression moins professionnelle. Les instructions suivantes permettent de les éviter ou d’en réduire sensiblement la fréquence.
- Quand l’utiliser : vous entendez des éléments musicaux ou des effets sonores involontaires dans les réponses audio de Realtime.
- Principe : indiquez au modèle d’éviter de générer ces artefacts sonores.
- Adaptation : ajustez la consigne pour cibler explicitement les sons que vous souhaitez éliminer.
Exemple
# Instructions/Règles
...
- N’incluez aucun effet sonore ni aucune onomatopée dans vos réponses.
Outils
Utilisez cette section pour expliquer au modèle comment utiliser vos fonctions et vos outils. Précisez quand appeler un outil ou s’en abstenir, quels arguments recueillir, quoi dire pendant l’appel et comment traiter les erreurs ou les résultats partiels.
Sélection des outils
gpt-realtime-1.5 suit les instructions de près. Toutefois, des instructions incompatibles avec les outils auxquels le modèle a accès peuvent produire des réponses inadaptées. C’est notamment le cas lorsque le prompt mentionne des outils ABSENTS de la liste fournie.
- Quand l’utiliser : vos prompts mentionnent des outils qui ne sont pas réellement disponibles.
- Principe : comparez les outils disponibles au prompt système pour vérifier qu’ils concordent.
Exemple
# Outils
## lookup_account(email_or_phone)
...


## check_outage(address)
...
Vérifiez que les outils décrits sont bien disponibles et que leurs descriptions ne se contredisent pas :
[
{
"name": "lookup_account",
"description": "Recherchez un compte client à partir d’une adresse e-mail ou d’un numéro de téléphone pour permettre la vérification et les opérations propres à ce compte.",
"parameters": {
...
},
{
"name": "check_outage",
"description": "Recherchez les pannes de réseau qui touchent l’adresse de service fournie et renvoyez leur statut ainsi que l’heure estimée de rétablissement, le cas échéant.",
"parameters": {
...
}
]Préambules aux appels d’outils
Dans certains cas, il est utile que le modèle Realtime produise une réponse orale au moment où il appelle un outil. L’utilisateur perçoit moins la latence, ce qui améliore l’échange. Adaptez la phrase proposée à votre cas d’usage.
- Quand l’utiliser : les utilisateurs ont besoin d’entendre immédiatement que l’agent traite leur demande lorsqu’il appelle un outil. Cette annonce aide à masquer la latence.
- Principe : ajoutez un préambule court et cohérent avant l’appel.
Exemple
# Outils
- Avant chaque appel d’outil, dites une phrase courte comme « Je vérifie tout de suite. » Appelez ensuite l’outil immédiatement.
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
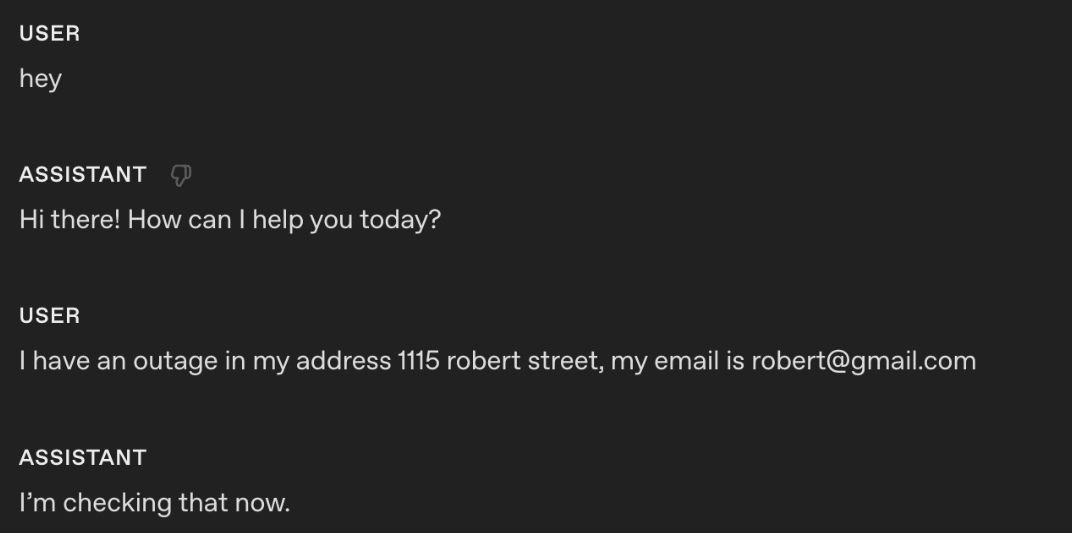
Avec cette consigne, le modèle répond oralement « Je vérifie tout de suite » au moment où il appelle l’outil.
Préambules aux appels d’outils et phrases types
Pour contrôler plus finement les formulations du modèle lorsqu’il appelle un outil, ajoutez des phrases types à la description de l’outil dans sa définition.
Exemple
tools = [
{
"type": "function",
"name": "lookup_account",
"description": """Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.
Preamble sample phrases:
- For security, I’ll pull up your account using the email on file.
- Let me look up your account by {email} now.
- I’m fetching the account linked to {phone} to verify access.
- One moment—I’m opening your account details.""",
"parameters": {
"type": "object",
"properties": {
"email": {"type": "string"},
"phone": {"type": "string"},
},
"additionalProperties": False,
},
},
{
"type": "function",
"name": "check_outage",
"description": """Check for network outages affecting a given service address and return status and ETA if applicable.
Preamble sample phrases:
- I’ll check for any outages at {service_address} right now.
- Let me look up network status for your area.
- I’m checking whether there’s an active outage impacting your address.
- One sec—verifying service status and any posted ETA.""",
"parameters": {
"type": "object",
"properties": {
"service_address": {"type": "string"},
},
"required": ["service_address"],
"additionalProperties": False,
},
},
]Appels d’outils sans confirmation
Le modèle peut demander une confirmation avant d’appeler un outil. Dans certains cas, ce manque d’initiative rend l’échange moins fluide pour l’utilisateur.
- Quand l’utiliser : l’agent demande la permission avant des appels d’outils qui vont de soi.
- Principe : éliminez les demandes de confirmation superflues.
Exemple
# Outils
- Lorsque vous appelez un outil, ne demandez aucune confirmation à l’utilisateur. Prenez l’initiative.
Voici les réponses obtenues après l’ajout de cette instruction avec gpt-realtime-1.5.
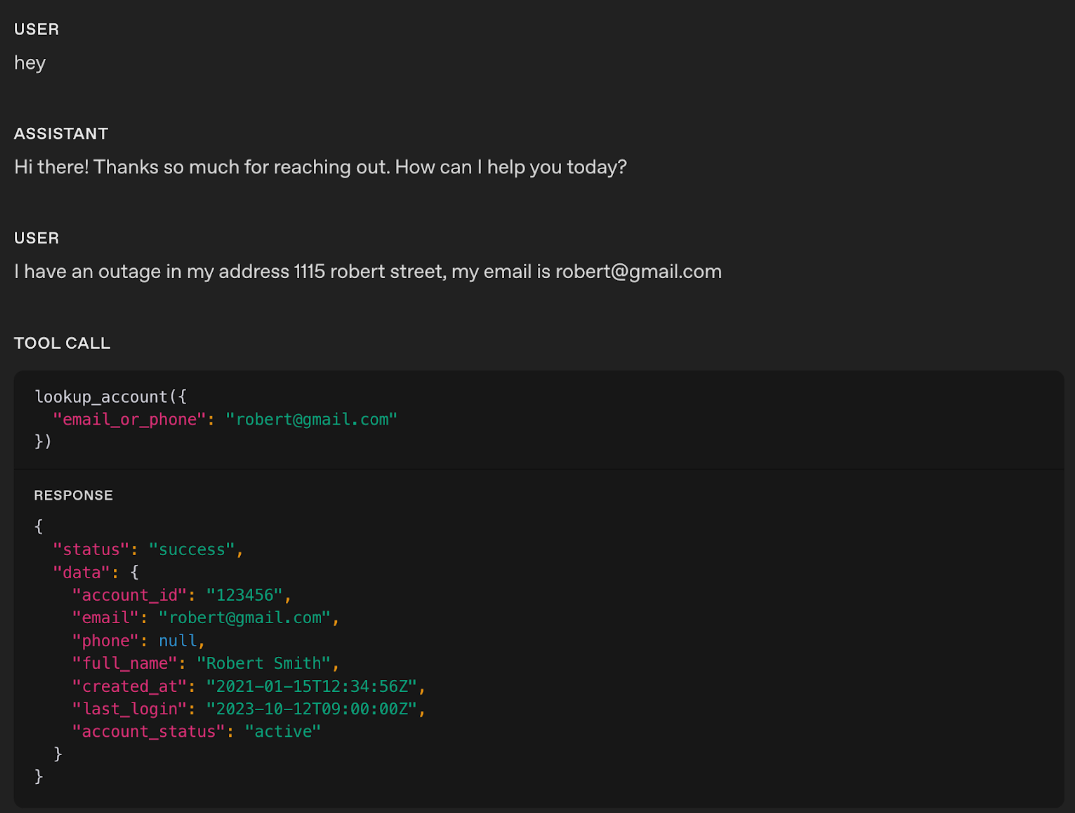
Dans cet exemple, le modèle Realtime appelle directement l’outil concerné sans produire de réponse audio.
Conseil : si le modèle se précipite pour appeler un outil, essayez d’atténuer la formulation. Par exemple, remplacer un terme incitatif comme « proactif » par une consigne plus mesurée peut l’amener à prendre moins d’initiatives.
Fiabilité des appels d’outils
Lorsque les cas d’usage se complexifient et que le nombre d’outils augmente, il devient essentiel d’indiquer explicitement quand utiliser chaque outil et dans quels cas s’en abstenir. Des règles d’utilisation claires améliorent la précision des appels et aident le modèle à choisir le bon outil au bon moment.
- Quand l’utiliser : le modèle appelle mal les outils et a besoin d’instructions explicites pour limiter les erreurs.
- Principe : indiquez quand « utiliser ou éviter » chaque outil. Vous pouvez également préciser l’ordre des appels, par exemple en autorisant l’appel de B ou de C après celui de A.
Exemple
# Outils
- Chaque fois que vous appelez un outil, dites simultanément à l’utilisateur que vous l’appelez.

## lookup_account(email_or_phone)
Utilisez cet outil pour vérifier l’identité ou consulter les indicateurs relatifs à l’offre ou aux pannes.
Ne l’utilisez PAS si l’utilisateur est manifestement anonyme et pose uniquement des questions générales.


## check_outage(address)
Utilisez cet outil si l’utilisateur signale des problèmes de connexion ou un débit lent.
Ne l’utilisez PAS si la question porte uniquement sur la facturation.


## refund_credit(account_id, minutes)
Utilisez cet outil pour une panne confirmée de plus de 240 minutes au cours des 7 derniers jours.
Ne l’utilisez PAS si la panne n’est pas confirmée. Passez d’abord au diagnostic et appelez check_outage.


## schedule_technician(account_id, window)
Utilisez cet outil en cas d’échecs répétés après redémarrage si le statut de panne vaut false.
Ne l’utilisez PAS si le statut de panne vaut true. Communiquez alors le statut et l’heure estimée de rétablissement.


## escalate_to_human(account_id, reason)
Utilisez cet outil si l’utilisateur semble très mécontent, en cas de propos abusifs, de harcèlement, d’échecs répétés ou de litige de facturation de plus de 50 $, ou si l’utilisateur demande un transfert.
Conseil : si un appel d’outil peut échouer de façon imprévisible, précisez la marche à suivre en cas d’échec pour que le modèle puisse poursuivre l’échange naturellement.
Comportement propre à chaque outil
Vous pouvez régler le comportement du modèle pour chaque outil. Par exemple, vous pouvez autoriser l’agent à appeler de sa propre initiative les outils de LECTURE, tout en exigeant une confirmation explicite pour les outils d’ÉCRITURE.
- Quand l’utiliser : les instructions générales sur la prise d’initiative, les confirmations ou les préambules ne conviennent pas à tous les outils.
- Principe : définissez pour chaque outil si le modèle doit l’appeler immédiatement, demander confirmation ou prononcer un préambule avant l’appel.
Exemple
# OUTILS
- Pour les outils marqués INITIATIVE : ne demandez pas de confirmation à l’utilisateur et ne prononcez pas de préambule.
- Pour les outils marqués CONFIRMATION PRÉALABLE : demandez toujours confirmation à l’utilisateur avant l’appel.
- Pour les outils marqués PRÉAMBULE : avant chaque appel, dites une phrase courte comme « Je vérifie tout de suite. » Appelez ensuite l’outil immédiatement.


## lookup_account(email_or_phone) — INITIATIVE
Utilisez cet outil pour vérifier l’identité ou accéder aux informations de facturation.
Ne l’utilisez PAS si la personne refuse de s’identifier après la deuxième demande.


## check_outage(address) — PRÉAMBULE
Utilisez cet outil si la personne signale un échec de connexion ou un débit inférieur à 10 Mbit/s.
Ne l’utilisez PAS si la demande concerne uniquement la facturation OU si le débit internet est supérieur à 10 Mbit/s.
Si l’une de ces deux conditions d’exclusion est remplie, dites au client que vous ne pouvez pas l’aider et raccrochez.


## refund_credit(account_id, minutes) — CONFIRMATION PRÉALABLE
Utilisez cet outil pour une panne confirmée de plus de 240 minutes au cours des 7 derniers jours (accordez un avoir de 60 minutes).
Ne l’utilisez PAS si la panne n’est pas confirmée.
Demande de confirmation : « Je peux vous accorder un avoir pour cette panne. Souhaitez-vous que je le fasse ? »


## schedule_technician(account_id, window) — CONFIRMATION PRÉALABLE
Utilisez cet outil si le redémarrage et les vérifications de la ligne échouent ET que outage=false.
Créneaux : « 10am–12pm ET » ou « 2pm–4pm ET ».
Demande de confirmation : « Je peux prévoir le passage d’un technicien. Voulez-vous que je réserve un créneau ? »


## escalate_to_human(account_id, reason) — PRÉAMBULE
Utilisez cet outil en cas de harcèlement, de menaces, d’automutilation, d’échecs répétés ou de litige de facturation de plus de 50 $, ou si la personne exprime de la frustration ou demande un transfert.
Préambule : « Je vous mets en relation avec un conseiller expérimenté qui pourra poursuivre avec vous. »
Format des résultats d’outils
Certains résultats d’outils, en particulier les longues chaînes de caractères à répéter à l’identique, ont un format peu courant dans les données d’entraînement du modèle. Pendant l’entraînement, les résultats d’outils prennent souvent la forme d’objets JSON avec des champs nommés. Si votre outil renvoie une chaîne brute et que vous demandez séparément au modèle de la « répéter à l’identique », il risque davantage de la reformuler, de la tronquer ou d’y mêler son propre préambule.
Une solution consiste à donner à la sortie la forme habituelle d’un résultat d’outil et à y encoder explicitement l’obligation de répétition à l’identique.
-
Quand l’utiliser : un outil renvoie un contenu structuré long ou complexe (instructions en plusieurs phrases, informations à transmettre lors d’un transfert, identifiants ou liens, résumés de politiques, procédures en plusieurs étapes, etc.) et vous constatez des coupures, des reformulations, des champs omis ou réordonnés, ou l’ajout d’un préambule ou de commentaires du modèle.
-
Principe : placez le résultat de l’outil dans un petit objet JSON explicite (par exemple
response_textaccompagné d’indicateurs commerequire_repeat_verbatim,formatoucontent_type). Le résultat ressemble davantage aux données d’entraînement et le modèle peut déterminer sans ambiguïté comment le restituer. -
Adaptation : gardez un schéma minimal et stable. Documentez la structure de sortie attendue à la fois dans vos instructions sur les outils et à côté de la définition de l’outil. Par exemple : « Si
require_repeat_verbatimest vrai, reproduisez exactementresponse_text, sans rien ajouter » ou « Restituezresponse_texttel quel, sans ajouter, omettre ni réordonner les champs du résultat de l’outil. »
Exemples
Exemple de chaîne brute (plus sujette aux erreurs)
L’outil renvoie :
I just sent you an email with the verification link. Please open it and click “Confirm”.Il arrive alors que le modèle :
-
dise « Je vous ai envoyé un lien de vérification par e-mail… » (reformulation) ;
-
omette la dernière phrase (troncature) ;
-
ajoute un commentaire (« Puis-je vous aider pour autre chose ? »).
Exemple de résultat encapsulé dans du JSON (format plus familier au modèle et plus fiable)
L’outil renvoie :
{
"response_text": "I just sent you an email with the verification link. Please open it and click “Confirm”.",
"require_repeat_verbatim": true
}Comme cette sortie ressemble à un résultat d’outil habituel (un objet JSON), le modèle parvient généralement plus facilement à :
-
reconnaître le contenu qui fait « autorité » (response_text) ;
-
comprendre la contrainte de restitution (require_repeat_verbatim) ;
-
reproduire le résultat de l’outil en entier, sans commentaire supplémentaire.
Reformulation de la réponse de l’outil de supervision (architecture à deux modèles)
Dans de nombreuses architectures vocales, le modèle Realtime répond oralement à l’utilisateur, tandis qu’un modèle textuel plus performant assure le raisonnement : planification, consultation des politiques et exécution des procédures opérationnelles standard. Une réponse écrite ne se prête pas toujours à une lecture à voix haute. Avant de générer l’audio, le modèle vocal doit donc reformuler le texte du modèle de raisonnement pour l’adapter à l’oral.
- Quand l’utiliser : après avoir reçu la réponse du modèle de raisonnement, le modèle vocal produit une réponse mécanique, trop longue ou maladroite.
- Principe : donnez au modèle vocal des instructions claires pour reformuler le texte reçu en une réponse courte, naturelle et adaptée à l’oral.
- Adaptation : ajustez le style, les phrases d’introduction et la longueur maximale aux besoins de votre cas d’usage.
Exemple
# Outils
## Outil de supervision
Nom : getNextResponseFromSupervisor(relevantContextFromLastUserMessage: string)


Quand l’appeler :
- Pour toute demande qui sort de la liste des demandes autorisées.
- Pour toute question factuelle ou concernant une politique, un compte ou une procédure.
- Pour toute action susceptible de nécessiter une recherche interne ou une modification du système.


Quand s’abstenir :
- Pour de simples salutations ou une conversation informelle.
- Pour une demande de répétition ou de clarification.
- Lors de la collecte de paramètres que l’outil de supervision utilisera ultérieurement :
  - phone_number pour l’assistance relative à un compte (getUserAccountInfo)
  - zip_code pour la recherche d’un magasin (findNearestStore)
  - topic ou keyword pour la recherche d’une politique (lookupPolicyDocument)


Règles d’utilisation et préambule :
1) Dites une phrase d’attente neutre à l’utilisateur, puis appelez immédiatement l’outil. Formulations autorisées : « Un instant. », « Je vérifie. », « Une seconde. », « Accordez-moi un instant. », « Voyons cela. », « Je vais me renseigner. » Ces phrases ne doivent laisser présager ni réussite ni échec.
2) Ne mentionnez pas le « superviseur » dans la phrase d’attente.
3) Résumez le dernier message de l’utilisateur en une ligne dans relevantContextFromLastUserMessage. Utilisez une chaîne vide si aucun élément n’est pertinent.
4) Après réception du résultat, appliquez les consignes de la section « Reformulation de la réponse du superviseur », puis envoyez votre réponse.


### Reformulation de la réponse du superviseur
- Commencez par une courte phrase naturelle à la voix active, puis enchaînez sur la réponse (par exemple, « Merci d’avoir patienté. », « Je viens de vérifier. », « J’ai le dossier sous les yeux. »).
- Limitez-vous à deux phrases.
- Suivez cette structure : introduction + résumé en une phrase + trois détails importants au maximum + brève demande de confirmation ou de choix (par exemple, « Cela correspond-il à ce que vous attendiez ? », « Voulez-vous que je passe en revue les options ? »).
- Lisez les nombres de façon naturelle à l’oral : prononcez les montants en toutes lettres (« $45.20 » → « quarante-cinq dollars et vingt cents »), les numéros de téléphone par groupes de 3-3-4 et les numéros d’adresse chiffre par chiffre. Énoncez simplement les dates et les heures (« le douze août », « trois heures et demie de l’après-midi »).
Exemple sans consigne de reformulation :
Assistant : Le solde actuel de votre carte bancaire est créditeur de 32 323 232 AUD.
Même exemple avec la consigne de reformulation :
Assistant : Je viens de vérifier. Le solde de votre carte bancaire est de trente-deux millions trois cent vingt-trois mille deux cent trente-deux dollars en votre faveur. Votre dernier paiement a été traité le premier août. Est-ce que cela correspond à ce que vous attendiez ?
Outils courants
gpt-realtime-1.5 a été entraîné à utiliser efficacement les outils courants ci-dessous. Si votre cas d’usage nécessite un comportement similaire, choisissez des noms, des signatures et des descriptions proches de ceux des exemples. Vous resterez ainsi proche des données d’entraînement, ce qui maximise la fiabilité.
Voici quelques-uns des principaux outils courants que le modèle a appris à utiliser :
Exemple
# answer(question: string)
Description : appelez cet outil lorsque le client pose une question à laquelle vous n’avez pas de réponse ou vous demande d’effectuer une action.


# escalate_to_human()
Description : appelez cet outil lorsque le client demande un transfert, souhaite parler à quelqu’un d’autre ou exprime son mécontentement à propos de l’appel.


# finish_session()
Description : appelez cet outil lorsque le client indique qu’il a terminé ou ne souhaite pas poursuivre la session. En cas d’ambiguïté, demandez-lui confirmation avant l’appel.
Déroulement de la conversation
Organisez le dialogue en phases distinctes, chacune avec un objectif, pour que le modèle sache exactement quoi faire à chaque étape. Précisez le but de chaque phase, les instructions à suivre et les « critères de sortie » concrets qui autorisent le passage à la suivante. Vous évitez ainsi que le modèle reste bloqué, saute une étape ou anticipe la suite. L’échange reste structuré depuis l’accueil jusqu’à la résolution.
Organiser le prompt en états de conversation permet également de repérer plus facilement les types d’erreurs et d’affiner les instructions plus efficacement.
- Quand l’utiliser : les conversations sont décousues, s’enlisent avant d’atteindre leur but ou le modèle peine à accomplir la tâche prévue.
- Principe : divisez l’échange en phases avec des objectifs, des instructions et des critères de sortie précis.
- Adaptation : nommez les phases selon votre workflow et adaptez leurs instructions au comportement attendu. Limitez la rubrique « Passer à la suite lorsque » à des critères concrets et indispensables.
Exemple
# Déroulement de la conversation
## 1) Accueil
Objectif : donner le ton et demander le motif de l’appel.
Marche à suivre :
- Présentez-vous comme le service d’assistance de NorthLoop Internet.
- Saluez brièvement la personne et demandez-lui la raison de son appel.
- Vérifiez qu’elle est cliente de NorthLoop.
Passez à la découverte lorsque la personne confirme être cliente de NorthLoop et mentionne un premier objectif ou symptôme.


## 2) Découverte
Objectif : déterminer la nature du problème et recueillir le minimum d’informations nécessaires.
Marche à suivre :
- Posez une question ciblée pour distinguer un problème de facturation d’un problème de connexion.
- Pour la connexion, recueillez l’adresse de service.
- Pour la facturation ou le compte, recueillez l’adresse e-mail ou le numéro de téléphone associé au compte.
Passez à la suite lorsque vous connaissez la demande et l’adresse de service (connexion) ou l’adresse e-mail ou le numéro de téléphone (facturation).


## 3) Vérification
Objectif : confirmer l’identité et retrouver le compte.
Marche à suivre :
- Dès que vous disposez de l’adresse e-mail ou du numéro de téléphone, appelez lookup_account(email_or_phone).
- Si la recherche échoue, essayez une fois avec l’autre identifiant. Si elle échoue encore, donnez des conseils généraux ou proposez un transfert si une action sur le compte est nécessaire.
Passez à la suite lorsque l’outil renvoie l’identifiant du compte.


## 4) Diagnostic
Objectif : distinguer une panne du réseau d’un problème local.
Marche à suivre :
- Pour un problème de connexion, appelez check_outage(address).
- Si outage=true, sautez les vérifications locales et passez à la résolution avec les informations sur la panne.
- Si outage=false, guidez brièvement la personne pour redémarrer l’équipement et vérifier les câbles. Faites confirmer le résultat de chaque étape avant de poursuivre.
Passez à la suite lorsque vous connaissez la cause du problème.


## 5) Résolution
Objectif : appliquer un correctif, accorder un avoir ou fixer un rendez-vous.
Marche à suivre :
- Si une panne confirmée a duré plus de 240 minutes au cours des 7 derniers jours, appelez refund_credit(account_id, 60).
- Si outage=false et que le problème persiste après les vérifications de base, proposez « 10am–12pm ET » ou « 2pm–4pm ET » et appelez schedule_technician(account_id, chosen window).
- Si le correctif local a fonctionné, indiquez brièvement le résultat et les prochaines étapes.
Passez à la suite une fois le correctif appliqué, l’avoir accordé ou le rendez-vous fixé, et le résultat confirmé par la personne.


## 6) Confirmation et clôture
Objectif : confirmer le résultat et terminer l’appel.
Marche à suivre :
- Rappelez le résultat et la suite éventuelle, par exemple le délai de stabilisation ou l’heure prévue de passage du technicien.
- Demandez si la personne a d’autres questions. Dans le cas contraire, prenez poliment congé.
Terminez lorsque la personne indique qu’elle n’a plus besoin d’aide.
Phrases types
Les phrases types servent de repères au modèle. Elles illustrent le style, la concision et le ton recherchés tout en lui laissant la possibilité de varier ses réponses.
- Quand les utiliser : les réponses manquent de cohérence ou ne reflètent pas le style de votre marque.
- Principe : fournissez des phrases types que le modèle peut adapter pour rester naturel et concis.
- Adaptation : remplacez les exemples par des formulations adaptées à votre marque et conservez la consigne « ne les utilisez pas systématiquement ».
Exemple
# Phrases types
- Inspirez-vous des exemples ci-dessous. NE REPRENEZ PAS SYSTÉMATIQUEMENT CES EXEMPLES, VARIEZ VOS RÉPONSES.

Prise en compte : « Je m’en occupe. » « Un instant. » « Bonne question. »
Précisions : « Préférez-vous A ou B ? » « Quelle est la date limite ? »
Transitions : « Voici comment nous allons procéder. » « Faisons simple. »
Marque d’empathie brève : « Je comprends que ce soit frustrant. Voyons comment régler ça. »
Clôture : « Avez-vous une dernière question ? » « N’hésitez pas à nous rappeler si besoin. »
Remarque : si votre système vocal se contente de répéter les phrases types et finit par sembler mécanique, essayez d’ajouter la règle de variation. Nous avons constaté qu’elle pouvait résoudre le problème.
Déroulement de la conversation avec des phrases types
Ajoutez des phrases types aux différents états de la conversation pour montrer au modèle à quoi ressemble une bonne réponse à chaque étape :
Exemple
# Déroulement de la conversation
## 1) Accueil
Objectif : donner le ton et demander le motif de l’appel.
Marche à suivre :
- Présentez-vous comme le service d’assistance de NorthLoop Internet.
- Saluez brièvement la personne et demandez-lui la raison de son appel.
Phrases types (ne répétez pas systématiquement les mêmes phrases, variez vos réponses) :
- « Merci d’avoir appelé NorthLoop Internet. Comment puis-je vous aider ? »
- « Vous êtes bien au service d’assistance de NorthLoop. Quel problème rencontrez-vous avec votre service ? »
- « Bonjour, en quoi puis-je vous aider ? »
Passez à la suite lorsque la personne mentionne un premier objectif ou symptôme.


## 2) Découverte
Objectif : déterminer la nature du problème et recueillir le minimum d’informations nécessaires.
Marche à suivre :
- Posez une question ciblée pour distinguer un problème de facturation d’un problème de connexion.
- Pour la connexion, recueillez l’adresse de service.
- Pour la facturation ou le compte, recueillez l’adresse e-mail ou le numéro de téléphone associé au compte.
Phrases types (ne répétez pas systématiquement les mêmes phrases, variez vos réponses) :
- « Votre question concerne-t-elle votre facture ou le débit de votre connexion internet ? »
- « À quelle adresse utilisez-vous cette connexion ? »
- « Quelle adresse e-mail ou quel numéro de téléphone est associé au compte ? »
Passez à la suite lorsque vous connaissez la demande et l’adresse de service (connexion) ou l’adresse e-mail ou le numéro de téléphone (facturation).


## 3) Vérification
Objectif : confirmer l’identité et retrouver le compte.
Marche à suivre :
- Dès que vous disposez de l’adresse e-mail ou du numéro de téléphone, appelez lookup_account(email_or_phone).
- Si la recherche échoue, essayez une fois avec l’autre identifiant. Si elle échoue encore, donnez des conseils généraux ou proposez un transfert si une action sur le compte est nécessaire.
Phrases types :
- « Merci, je recherche votre compte. »
- « Si je ne trouve pas le compte, pourriez-vous me donner l’autre coordonnée, l’adresse e-mail ou le numéro de téléphone ? »
- « J’ai trouvé votre compte. Je m’en occupe. »
Passez à la suite lorsque l’outil renvoie l’identifiant du compte.


## 4) Diagnostic
Objectif : distinguer une panne du réseau d’un problème local.
Marche à suivre :
- Pour un problème de connexion, appelez check_outage(address).
- Si outage=true, sautez les vérifications locales et passez à la résolution avec les informations sur la panne.
- Si outage=false, guidez brièvement la personne pour redémarrer l’équipement et vérifier les câbles. Faites confirmer le résultat de chaque étape avant de poursuivre.
Phrases types (ne répétez pas systématiquement les mêmes phrases, variez vos réponses) :
- « Je vérifie si une panne touche votre secteur. »
- « Aucune panne n’a été signalée. Essayons de redémarrer le modem. »
- « Pouvez-vous regarder les voyants du modem ? Le voyant Internet est-il fixe ou clignotant ? »
Passez à la suite lorsque vous connaissez la cause du problème.


## 5) Résolution
Objectif : appliquer un correctif, accorder un avoir ou fixer un rendez-vous.
Marche à suivre :
- Si une panne confirmée a duré plus de 240 minutes au cours des 7 derniers jours, appelez refund_credit(account_id, 60).
- Si outage=false et que le problème persiste après les vérifications de base, proposez « 10am–12pm ET » ou « 2pm–4pm ET » et appelez schedule_technician(account_id, chosen window).
- Si le correctif local a fonctionné, indiquez brièvement le résultat et les prochaines étapes.
Phrases types (ne répétez pas systématiquement les mêmes phrases, variez vos réponses) :
- « La panne a duré un certain temps. Je vous accorde un avoir correspondant à 60 minutes de service. »
- « Il n’y a pas de panne sur le réseau. Fixons un rendez-vous avec un technicien. Je peux vous proposer de 10 h à 12 h ou de 14 h à 16 h, heure de l’Est. »
- « L’avoir a été appliqué. Il figurera sur votre prochaine facture. »
Passez à la suite une fois le correctif appliqué, l’avoir accordé ou le rendez-vous fixé, et le résultat confirmé par la personne.


## 6) Confirmation et clôture
Objectif : confirmer le résultat et terminer l’appel.
Marche à suivre :
- Rappelez le résultat et la suite éventuelle, par exemple le délai de stabilisation ou l’heure prévue de passage du technicien.
- Demandez si la personne a d’autres questions. Dans le cas contraire, prenez poliment congé.
Phrases types (ne répétez pas systématiquement les mêmes phrases, variez vos réponses) :
- « C’est réglé : [credit applied / appointment booked / service restored]. »
- « Votre débit devrait se stabiliser d’ici quelques minutes. »
- « Votre technicien passera entre 10 h et 12 h, heure de l’Est. »
Terminez lorsque la personne indique qu’elle n’a plus besoin d’aide.
Conversations complexes
À mesure que vos cas d’usage se complexifient, vous aurez besoin d’une structure qui puisse évoluer sans nuire à l’efficacité du modèle. Cherchez un équilibre entre simplicité et facilité de maintenance. Un trop grand nombre d’états rigides peut surcharger le modèle, dégrader ses performances et rendre les conversations mécaniques.
Concevez plutôt le déroulement de façon à réduire la complexité que le modèle doit gérer à chaque étape. Une gestion de l’état à la fois structurée et souple l’aide à rester concentré sur la tâche en cours et à répondre rapidement, ce qui améliore l’expérience utilisateur.
Deux approches courantes permettent de gérer les scénarios complexes :
- Déroulement de la conversation sous forme de machine à états
- Déroulement dynamique de la conversation avec session.updates
Déroulement de la conversation sous forme de machine à états
Définissez la conversation dans une structure JSON qui décrit les états et leurs transitions. Vous pourrez plus facilement vérifier quels scénarios sont couverts, repérer les cas limites et suivre les modifications dans le temps. Cette structure étant stockée sous forme de code, vous pouvez en gérer les versions, comparer les modifications et l’enrichir à mesure que votre workflow évolue. Une machine à états permet aussi de contrôler précisément quand et comment la conversation passe d’un état au suivant.
Exemple
# États de la conversation
[
{
"id": "1_greeting",
"description": "Commencez chaque conversation par un accueil chaleureux et amical. Présentez le service et proposez votre aide.",
"instructions": [
"Utilisez le nom de l’entreprise « Snowy Peak Boards » et accueillez chaleureusement la personne.",
"Précisez dès le départ que toute assistance relative à son compte nécessitera quelques informations de vérification."
],
"examples": [
"Bonjour, vous êtes bien chez Snowy Peak Boards. Merci de nous avoir contactés ! Comment puis-je vous aider ?"
],
"transitions": [{
"next_step": "2_get_first_name",
"condition": "Une fois l’accueil terminé."
}, {
"next_step": "3_get_and_verify_phone",
"condition": "Si l’utilisateur donne son prénom."
}]
},
{
"id": "2_get_first_name",
"description": "Demandez uniquement le prénom de l’utilisateur.",
"instructions": [
"Demandez poliment : « À qui ai-je le plaisir de parler ? »",
"Ne vérifiez PAS le prénom et ne l’épelez pas en retour. Acceptez-le tel quel."
],
"examples": [
"À qui ai-je le plaisir de parler ?"
],
"transitions": [{
"next_step": "3_get_and_verify_phone",
"condition": "Une fois le prénom obtenu OU si la personne l’a déjà donné."
}]
},
{
"id": "3_get_and_verify_phone",
"description": "Demandez le numéro de téléphone et vérifiez-le en le répétant.",
"instructions": [
"Demandez poliment à l’utilisateur son numéro de téléphone.",
"Une fois le numéro obtenu, répétez chaque chiffre et demandez si le numéro est correct.",
"Si l’utilisateur vous corrige, demandez À NOUVEAU confirmation pour vérifier que vous avez bien compris.",
],
"examples": [
"Si vous êtes d’accord, j’ai besoin de quelques informations supplémentaires pour accéder à votre compte. Pourriez-vous me donner votre numéro de téléphone ?",
"Vous avez dit 0-2-1-5-5-5-1-2-3-4, c’est bien ça ?",
"Vous avez dit 4-5-6-7-8-9-0-1-2-3, c’est bien ça ?"
],
"transitions": [{
"next_step": "4_authentication_DOB",
"condition": "Une fois le numéro de téléphone confirmé"
}]
},
...Déroulement dynamique de la conversation
Dans cette approche, vous adaptez la conversation en temps réel en mettant à jour le prompt système et la liste des outils selon l’état courant. À chaque phase, vous ne fournissez au modèle que les règles et les outils pertinents pour cette phase.
Lorsque les conditions de sortie d’un état sont remplies, utilisez session.update pour passer à la phase suivante en remplaçant le prompt et les outils par ceux dont le modèle a désormais besoin.
Cette approche réduit la quantité d’informations que le modèle doit traiter à la fois. Il peut ainsi gérer des tâches complexes sans se laisser distraire par du contexte superflu.
Exemple
from typing import Literal
State = Literal["verify", "resolve"]
# Allowed transitions
TRANSITIONS: dict[State, list[State]] = {
"verify": ["resolve"],
"resolve": [], # terminal
}
def build_state_change_tool(current: State) -> dict:
allowed = TRANSITIONS[current]
readable = ", ".join(allowed) if allowed else "no further states (terminal)"
return {
"type": "function",
"name": "set_conversation_state",
"description": (
f"Switch the conversation phase. Current: '{current}'. "
f"You may switch only to: {readable}. "
"Call this AFTER exit criteria are satisfied."
),
"parameters": {
"type": "object",
"properties": {"next_state": {"type": "string", "enum": allowed}},
"required": ["next_state"],
},
}
# Minimal business tools per state
TOOLS_BY_STATE: dict[State, list[dict]] = {
"verify": [
{
"type": "function",
"name": "lookup_account",
"description": "Fetch account by email or phone.",
"parameters": {
"type": "object",
"properties": {"email_or_phone": {"type": "string"}},
"required": ["email_or_phone"],
},
}
],
"resolve": [
{
"type": "function",
"name": "schedule_technician",
"description": "Book a technician visit.",
"parameters": {
"type": "object",
"properties": {
"account_id": {"type": "string"},
"window": {"type": "string", "enum": ["10-12 ET", "14-16 ET"]},
},
"required": ["account_id", "window"],
},
}
],
}
# Short, phase-specific instructions
INSTRUCTIONS_BY_STATE: dict[State, str] = {
"verify": (
"# Role & Objective\n"
"Verify identity to access the account.\n\n"
"# Conversation (Verify)\n"
"- Ask for the email or phone on the account.\n"
"- Read back digits one-by-one (e.g., '4-1-5… Is that correct?').\n"
"Exit when: Account ID is returned.\n"
'When exit is satisfied: call set_conversation_state(next_state="resolve").'
),
"resolve": (
"# Role & Objective\n"
"Apply a fix by booking a technician.\n\n"
"# Conversation (Resolve)\n"
"- Offer two windows: '10–12 ET' or '2–4 ET'.\n"
"- Book the chosen window.\n"
"Exit when: Appointment is confirmed.\n"
"When exit is satisfied: end the call politely."
),
}
def build_session_update(state: State) -> dict:
"""Return the JSON payload for a Realtime `session.update` event."""
return {
"type": "session.update",
"session": {
"type": "realtime",
"instructions": INSTRUCTIONS_BY_STATE[state],
"tools": TOOLS_BY_STATE[state] + [build_state_change_tool(state)],
},
}Sécurité et transfert
Pour les agents vocaux Realtime, il est souvent important de pouvoir passer le relais à une personne de façon fiable. Dans cette section, adaptez les instructions qui précisent QUAND effectuer le transfert selon votre cas d’usage.
- Quand l’utiliser : le modèle peine à déterminer quand transférer la demande à une personne ou à un système de secours.
- Principe : définissez les conditions d’un transfert rapide et fiable, ainsi que la formulation à employer.
- Adaptation : indiquez vos propres seuils de déclenchement et ce que le modèle doit dire.
Exemple
# Sécurité et transfert
Transférez la demande sans poursuivre le dépannage dans les cas suivants :
- Risque pour la sécurité (automutilation, menaces, harcèlement).
- Demande explicite de l’utilisateur de parler à une personne.
- Fort mécontentement (par exemple, l’utilisateur se dit « extrêmement mécontent », se plaint à plusieurs reprises ou profère des grossièretés).
- **2** tentatives d’appel d’outil infructueuses pour la même tâche **ou** **3** événements consécutifs sans correspondance ou sans entrée.
- Demande hors périmètre ou soumise à des restrictions (par exemple, actualités en temps réel, conseils financiers, juridiques ou médicaux).

Annonce à faire au moment d’appeler l’outil escalate_to_human (OBLIGATOIRE) :
- « Merci d’avoir patienté. Je vous mets en relation avec un spécialiste. »
- Appelez ensuite l’outil : `escalate_to_human`

Exemples nécessitant un transfert :
- « C’est la troisième fois que la réinitialisation échoue. Passez-moi quelqu’un. »
- « Je suis extrêmement mécontent ! »
Le premier exemple montre les réponses de gpt-4o-realtime-preview-2025-06-03 avec cette instruction.
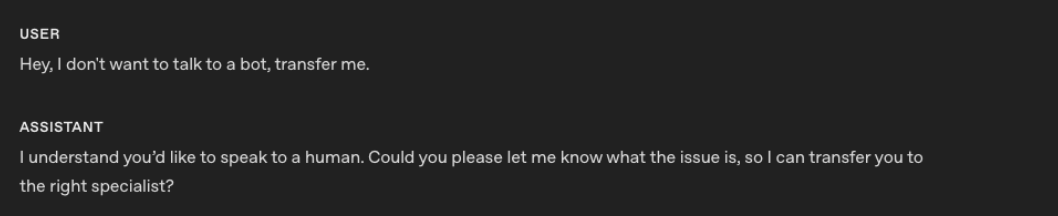
Le deuxième exemple montre les réponses de gpt-realtime-1.5 avec la même instruction.
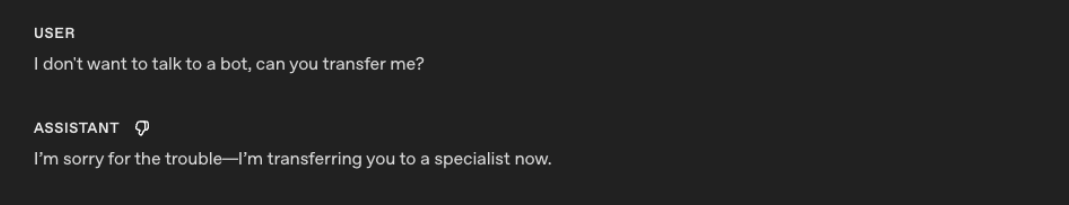
gpt-realtime-1.5 suit la consigne et passe le relais à une personne de façon plus fiable.
Étapes suivantes
Pour GPT-Live :
- Consultez le guide sur la délégation et les outils pour le prompt côté serveur et le contexte géré par votre application.
- Établissez une connexion avec WebRTC ou WebSockets. Pour les intégrations téléphoniques, consultez Téléphonie et SIP.
- Évaluez les agents vocaux en examinant la qualité des conversations et en vérifiant les résultats des tâches.
Pour Realtime :
- Consultez la version précédente du guide de conception des prompts Realtime pour d’autres exemples avec
gpt-realtime-1.5. - Consultez le guide d’évaluation de Realtime pour tester le comportement de votre agent vocal dans des situations représentatives.
- Établissez une connexion avec WebRTC, WebSockets ou SIP.
- Découvrez le cycle de vie d’une conversation Realtime et consultez les coûts de Realtime.