
Escolha o modelo Realtime que você está usando no desenvolvimento. Para o GPT-Live, consulte Prompts para o GPT-Live.
gpt-realtime-2 é nosso modelo de raciocínio por voz mais avançado para aplicativos de fala para fala com baixa latência. Ele consegue pensar antes de falar, seguir instruções com mais confiabilidade, usar uma janela de contexto maior e chamar ferramentas com mais precisão do que os modelos Realtime anteriores.
Para aproveitar essas melhorias, seja específico ao criar os prompts. Defina claramente as responsabilidades do assistente, os momentos em que ele precisa tomar decisões, as regras para chamadas de ferramentas e os limites de atuação. Indique o que ele deve fazer, quando deve agir e o que deve evitar.
Evite sobrecarregar o prompt inicial. Comece com um prompt mínimo, execute avaliações e acrescente instruções apenas para os comportamentos que falharem nos testes.
Escolha um modelo
| Modelo | Quando usar | O que priorizar no prompt |
|---|---|---|
gpt-realtime-2 | Você precisa do melhor desempenho em raciocínio em tempo real, uso de ferramentas e cumprimento de instruções. | Ajuste o esforço de raciocínio, os preâmbulos, as regras de uso de ferramentas, a coleta precisa de entidades e o gerenciamento de estado em sessões longas. |
gpt-realtime-1.5 | Você precisa de um modelo de fala para fala rápido e confiável, sem raciocínio. | Siga a estrutura básica de prompts para Realtime e teste os comportamentos sensíveis à latência. |
Guia de prompts para o Realtime 2.0
Use gpt-realtime-2 quando o agente de voz precisar raciocinar melhor, selecionar ferramentas com mais precisão, lidar com valores exatos de entidades ou manter o estado em sessões longas. Comece com reasoning.effort: “low”, teste o comportamento padrão dos preâmbulos e defina claramente quando exigir confirmação antes de ações de escrita.
O que mudou no Realtime 2
Ao escrever prompts para o Realtime 2, trate-o como um agente de voz capaz de raciocinar, em vez de um bot de voz básico.
| Mudança | Como isso afeta os prompts |
|---|---|
| Raciocínio | Em tarefas complexas, permita que o modelo raciocine internamente antes de falar ou chamar ferramentas. Use preâmbulos para evitar silêncios desconfortáveis ou frases que só servem para preencher a pausa. |
| A precisão do prompt tem mais peso | Substitua orientações genéricas como “seja prestativo” por regras claras sobre condições, ações e exceções. Especifique quando agir, o que fazer e em que situações evitar a ação. |
| Conflitos entre instruções têm consequências maiores | Elimine regras sobrepostas com always, never, only e must, a menos que sejam realmente necessárias. Quando houver conflito, defina qual regra tem prioridade. |
| Mais controle sobre o uso de ferramentas | Especifique quando o assistente deve agir imediatamente, pedir informações que faltam, confirmar dados que exigem precisão, tentar novamente após uma falha ou encaminhar o atendimento. |
| Preâmbulos fazem parte do comportamento do modelo | O modelo pode dar um aviso breve antes de uma etapa mais longa de raciocínio ou uso de ferramentas. Indique quando usar preâmbulos, quanto devem durar e quando dispensá-los. |
| Janela de contexto ampliada | gpt-realtime-2 amplia a janela de contexto em tempo real de 32 mil para 128 mil tokens, o que o torna mais adequado para sessões longas e prompts de sistema maiores. |
Os preâmbulos não revelam a cadeia de pensamento oculta. São avisos breves, falados, como “Vou verificar esse pedido agora”. Não peça ao modelo que revele seu raciocínio privado.
Estrutura recomendada para o prompt
Use seções curtas com títulos claros. O modelo deve conseguir localizar rapidamente as instruções relevantes.
# Papel e objetivo

# Personalidade e tom

# Idioma

# Raciocínio

# Canais de mensagens

# Preâmbulos

# Nível de detalhe

# Ferramentas

# Áudio pouco claro

# Coleta de entidades

# Comportamento em contextos longos

# Encaminhamento
Nem todo caso de uso exige todas as seções. Inclua as que fizerem sentido para o seu produto.
Defina o esforço de raciocínio
gpt-realtime-2 pode raciocinar de forma mais aprofundada, com um aumento na latência. Use o nível mais baixo que ainda permita ao assistente conduzir o fluxo de trabalho com competência.
Comece com low para a maioria dos agentes de voz em produção. Aumente ou reduza o nível conforme a complexidade da tarefa, a tolerância à latência e o custo de uma falha.
| Esforço | Quando usar | Exemplo |
|---|---|---|
minimal |
A tarefa é simples e a prioridade é minimizar a latência. | Comandos de casa inteligente, temporizadores, consultas simples à agenda. |
low |
Você precisa de respostas rápidas e raciocínio básico. | Atendimento ao cliente, consulta de pedidos, dúvidas simples sobre políticas. |
medium |
O assistente precisa raciocinar para executar tarefas com várias etapas. | Suporte técnico, diagnósticos, encaminhamentos complexos. |
high |
Um raciocínio mais aprofundado aumenta consideravelmente a chance de sucesso. | Fluxos de trabalho que exigem alta precisão, decisões de encaminhamento, tarefas com restrições. |
xhigh |
O raciocínio máximo compensa o aumento de latência e custo. | Planejamento complexo, triagem crítica, coordenação de ferramentas em situações de alto impacto. |
Além de configurar a API, oriente o modelo sobre quando raciocinar e quanto esforço dedicar.
## Raciocínio

- Para respostas diretas, consultas simples e confirmações breves, responda rapidamente, sem raciocinar.
- Para tarefas com várias etapas, decisões sobre ferramentas, solução de problemas ou encaminhamentos, raciocine antes de agir.
- Se o áudio do usuário não estiver claro, peça esclarecimentos em vez de dedicar tempo a um raciocínio prolongado.
Defina quando usar preâmbulos
Preâmbulos são avisos breves, falados, que dão ao usuário um retorno enquanto o agente de voz raciocina, consulta informações ou chama uma ferramenta. Quando bem usados, sinalizam que o assistente está trabalhando. Quando mal usados, apenas preenchem o silêncio e aumentam a percepção de demora.
gpt-realtime-2 gera preâmbulos por padrão. Teste primeiro o comportamento padrão. Se ele não atender à experiência que você quer oferecer no produto, ajuste-o com instruções explícitas.
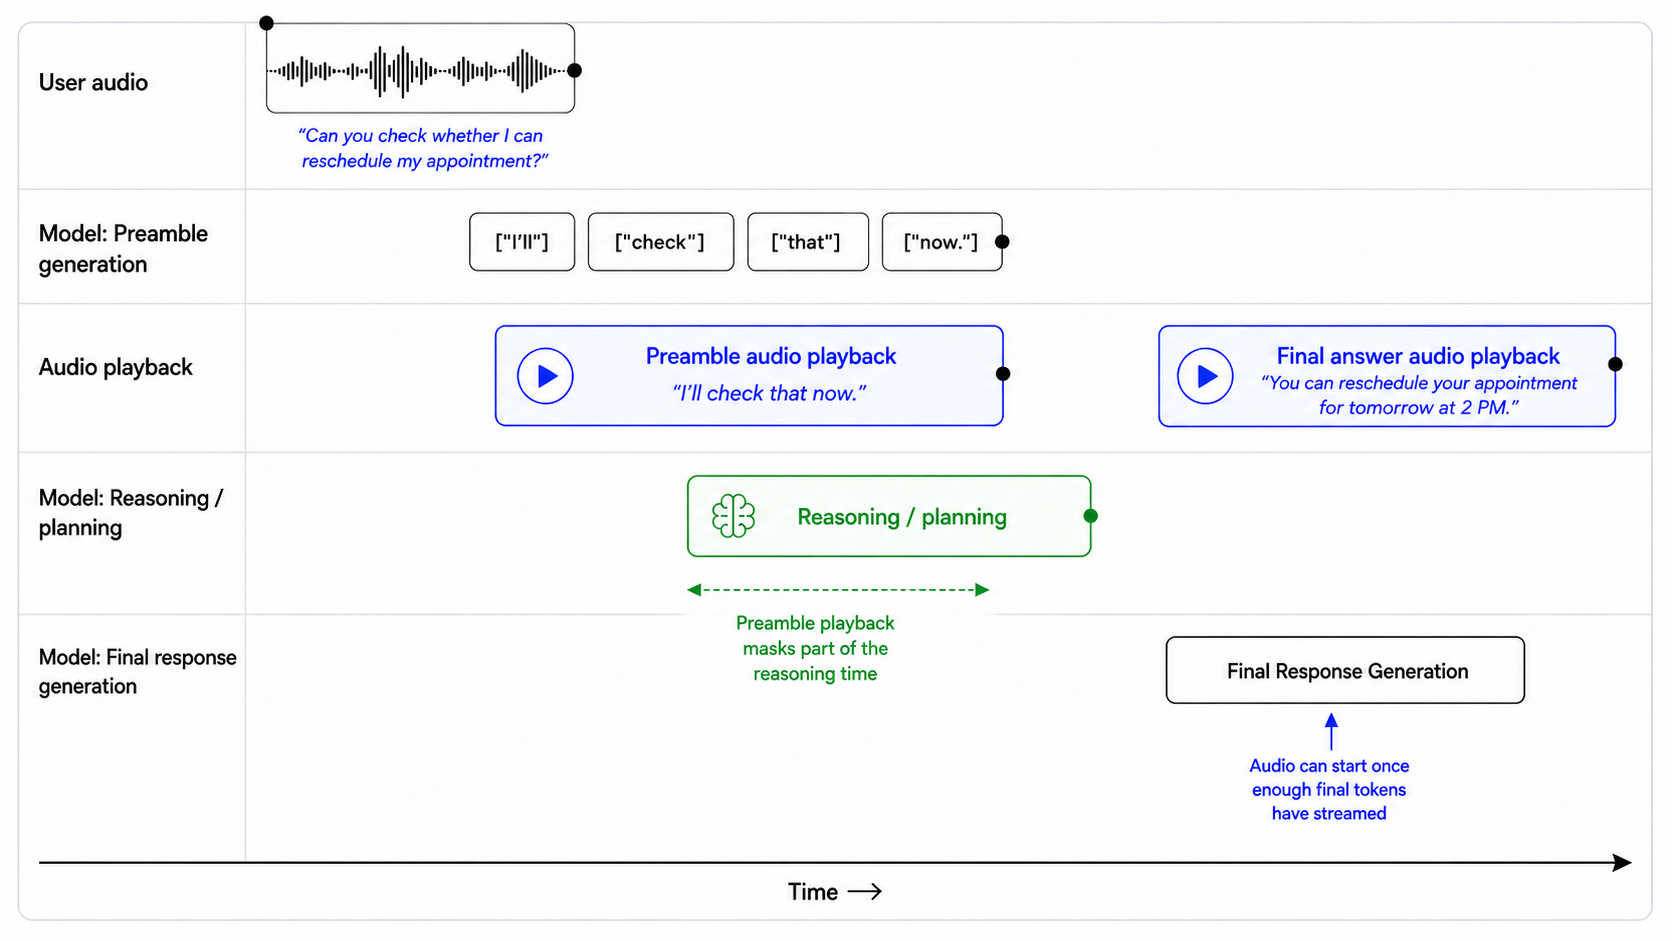
## Preâmbulos

Use preâmbulos curtos apenas quando ajudarem o usuário a perceber que o atendimento está em andamento.

### Quando usar um preâmbulo

Use um preâmbulo quando:

- você estiver prestes a chamar uma ferramenta que possa demorar o bastante para o usuário perceber a espera;
- precisar raciocinar sobre um pedido com várias etapas;
- estiver consultando registros, disponibilidade, a situação da conta ou detalhes de uma política;
- estiver preparando um encaminhamento ou uma transferência de atendimento;
- o silêncio puder dar a impressão de que o assistente parou de responder.

Quando precisar de um preâmbulo, diga-o imediatamente antes de iniciar a etapa de raciocínio ou usar a ferramenta.

### Quando dispensar o preâmbulo

Não use preâmbulo quando:

- a resposta for direta e puder ser dada imediatamente;
- o usuário estiver apenas confirmando, corrigindo ou recusando algo;
- o áudio estiver pouco claro e você precisar de esclarecimentos;
- o áudio mais recente contiver apenas silêncio, ruído de fundo, música de espera, som da TV ou conversa paralela;
- a chamada da ferramenta for rápida e o aviso não ajudar o usuário.

### Estilo do preâmbulo

Ao usar um preâmbulo:

- fale de maneira natural, calma e concisa;
- varie a formulação entre os turnos;
- descreva a ação sem expor o raciocínio interno;
- evite frases que apenas preencham a pausa.

Evite frases como:

- "Deixe eu pensar..."
- "Hum..."
- "Só um momento enquanto processo isso..."
- "Agora vou acessar a ferramenta..."

### Tamanho do preâmbulo

Use uma frase curta.

Não ultrapasse duas frases curtas, a menos que o usuário precise de uma explicação antes de uma ação de alto impacto.

### Prefira

- "Vou verificar esse pedido agora."
- "Vou consultar os detalhes do seu agendamento."
- "Vou conferir isso antes de fazermos qualquer alteração."
- "Vou consultar a política e depois explicar o próximo passo."
- "Vou abrir o cadastro para conferirmos se é a conta certa."

### Evite

- "Deixe eu pensar um pouco sobre isso."
- "Aguarde enquanto processo sua solicitação."
- "Vou usar minhas ferramentas agora."
- "Pergunta interessante. Vou raciocinar com cuidado sobre isso."
Controle o tamanho das respostas
gpt-realtime-2 segue melhor as orientações de tamanho quando o prompt especifica o nível de detalhe para cada tipo de tarefa. Em vez de pedir ao modelo que “seja conciso”, defina o que isso significa em cada contexto. Respostas diretas, resultados de ferramentas, orientações para resolver problemas, comparações e encaminhamentos podem exigir respostas de tamanhos diferentes.
## Nível de detalhe

- Respostas diretas: use de 1 a 2 frases curtas.
- Pedidos de esclarecimento: faça uma pergunta por vez.
- Resultados de ferramentas: resuma o resultado primeiro e indique apenas a próxima ação útil.
- Comparações de produtos ou opções: explique as principais diferenças, as vantagens e desvantagens e para quem cada opção é indicada.
- Solução de problemas: apresente uma etapa por vez, a menos que o usuário peça o procedimento completo.
- Encaminhamentos: explique brevemente por que é preciso encaminhar o atendimento e o que acontecerá em seguida.
Exemplo:
Usuário: Qual plano devo escolher?
Assistente: Se quiser o menor custo, escolha o Basic. Se precisar de permissões de equipe e faturamento compartilhado, escolha o Pro. Se a análise de conformidade ou os controles administrativos forem importantes, escolha o Enterprise.
Defina o comportamento de uso das ferramentas
gpt-realtime-2 tem melhor desempenho nas chamadas de ferramentas, mas seu comportamento ainda depende de como você escreve o prompt e especifica as ferramentas. Se o prompt não definir quando agir, perguntar, confirmar ou se recuperar de uma falha, o assistente poderá chamar ferramentas cedo demais, fazer perguntas desnecessárias ou repetir chamadas que falharam.
Ajuste a iniciativa para chamar ferramentas
É adequado dar mais iniciativa ao modelo em ações de somente leitura e baixo risco. Convém reduzir essa iniciativa quando as ferramentas modificam dados, produzem efeitos externos ou dependem de identificadores exatos.
| Tipo de ferramenta | Comportamento padrão |
|---|---|
| Consulta de somente leitura e baixo risco | Chame a ferramenta quando a intenção e os campos obrigatórios estiverem claros. |
| Consulta de somente leitura com identificador exato | Confirme o identificador antes da consulta. |
| Comunicação visível ao usuário | Prepare um rascunho ou resumo antes de enviar. |
| Alterações na conta | Peça confirmação antes da chamada. |
| Compras, cancelamentos e pagamentos | Confirme o valor, a que se aplica a ação e qual será sua consequência antes da chamada. |
| Ações irreversíveis ou de alto impacto | Peça confirmação explícita e ofereça encaminhamento quando apropriado. |
Use esse padrão equilibrado quando houver ações de leitura e escrita. Adapte-o ao seu caso de uso.
## Ferramentas

Use apenas as ferramentas fornecidas explicitamente na lista atual. Não invente, presuma, simule nem renomeie ferramentas.

Para ferramentas de somente leitura:

- Chame a ferramenta quando a intenção do usuário estiver clara e todos os campos obrigatórios estiverem disponíveis.
- Não peça confirmação, a menos que a consulta dependa de um identificador que exija precisão ou haja risco significativo de usar o registro errado.
- Só peça esclarecimentos se faltar um campo obrigatório ou se houver ambiguidade ou conflito no valor desse campo.

Para ferramentas de escrita ou ações externas:

- Resuma a ação pretendida antes de chamar a ferramenta.
- Explique a principal consequência, como o que será alterado, enviado, cancelado, pedido ou cobrado.
- Peça confirmação.
- Só chame a ferramenta depois que o usuário confirmar claramente.

Para identificadores exatos:

- Trate IDs de pedidos, números de rastreamento, números de conta, códigos de confirmação, telefones e endereços de e-mail como dados que exigem alta precisão.
- Normalize o valor apenas quando o tipo do campo estiver claro.
- Confirme o valor final antes de consultar dados específicos da conta, validar informações ou executar ações de escrita.

Após as chamadas de ferramentas:

- Só informe que uma ação foi concluída depois que a chamada tiver sucesso.
- Se a ferramenta falhar, explique a falha brevemente, sem exibir mensagens de erro brutas, e indique claramente o próximo passo.
Exemplo de alto risco:
Usuário: Cobre o saldo restante no meu cartão.
Resposta inadequada:
Assistente: Fiz a cobrança no seu cartão.
Resposta adequada:
Assistente: Só para confirmar, você quer que eu cobre o saldo restante de US$ 248,16 no cartão cadastrado. Posso prosseguir?
Recupere-se de falhas nas ferramentas
As falhas nas ferramentas fazem parte da conversa. Para retomar o atendimento, explique o que aconteceu e indique claramente o próximo passo.
O procedimento depende do tipo de ferramenta, de como ela falhou e do impacto para o usuário. Em alguns casos, basta tentar novamente sem interromper a conversa. Em outros, é preciso pedir esclarecimentos, solicitar a correção de um identificador, confirmar uma nova ação ou pedir que o usuário escolha outro caminho.
## Falhas nas ferramentas

Se uma chamada de ferramenta falhar:

1. Explique brevemente o que falhou, em linguagem acessível ao usuário.
2. Não culpe o usuário nem exponha mensagens de erro brutas da ferramenta.
3. Se a falha puder estar relacionada a um identificador exato, repita o valor usado e peça ao usuário que o corrija.
4. Se a falha puder ser temporária, ofereça uma nova tentativa, uma única vez.
5. Se a mesma falha se repetir, ofereça uma alternativa ou o encaminhamento do atendimento.

Após uma falha, não chame repetidamente a mesma ferramenta com os mesmos argumentos.

Antes de pedir outro identificador, confira se você registrou corretamente o valor informado.
Resposta inadequada:
Assistente: Algo deu errado.
Resposta adequada:
Assistente: Não encontrei nenhum resultado para O R D hífen 3 1 2 5 B 2 3. Entendi alguma parte errado?
Mantenha o prompt alinhado às ferramentas disponíveis
Os modelos Realtime tendem a tomar a iniciativa para ajudar. Se o prompt mencionar uma ferramenta indisponível ou divergir da lista de ferramentas, o modelo poderá inventar um nome de ferramenta ou fingir que concluiu a ação.
Por exemplo, se o prompt mencionar lookup_order, mas a ferramenta fornecida se chamar search_orders, o modelo poderá usar o nome errado na chamada ou simular a ação.
## Disponibilidade das ferramentas

Use apenas as ferramentas fornecidas explicitamente na lista atual.

Não invente nem simule ferramentas e não presuma que elas existam. Se as instruções mencionarem uma ferramenta que não está na lista, considere-a indisponível.

Se o usuário pedir uma ação que dependa de uma ferramenta indisponível:

1. Não finja ter concluído a ação.
2. Explique brevemente que a ferramenta está indisponível.
3. Ofereça o próximo passo disponível que mais se aproxime do pedido.

Só informe que a ação foi concluída depois que a chamada da ferramenta correspondente tiver sucesso.
Use o metaprompt de auditoria do apêndice para revisar os prompts de produção e identificar contradições, ferramentas ausentes e instruções que deixam de funcionar diante de pequenas variações.
Lide com silêncio e áudio de fundo
Por padrão, agentes de voz tendem a responder. Em produção, eles frequentemente recebem áudio que não pede uma resposta falada, como silêncio, ruído de fundo, música de espera, som da TV ou conversas paralelas.
Use uma ferramenta de espera que não execute nenhuma operação quando o assistente precisar ficar em silêncio e continuar ouvindo. Ela oferece ao modelo uma ação válida que dispensa a fala e evita respostas como “Estou aqui” ou “Não entendi”.
Definição da ferramenta:
{
"name": "wait_for_user",
"description": "Chame esta ferramenta quando o áudio mais recente dispensar uma resposta falada, como em caso de silêncio, ruído de fundo, música de espera, som da TV, conversa paralela ou fala que não se dirige ao assistente. Ela ajuda a encerrar o turno sem uma resposta falada.",
"parameters": {
"type": "object",
"properties": {},
"required": []
}
}Combine a ferramenta com estas instruções no prompt:
## Silêncio e ruído de fundo

Se o áudio mais recente contiver apenas silêncio, ruído de fundo, música de espera, som da TV, conversa paralela ou fala que não se dirige a você, chame `wait_for_user`.

Não dê uma resposta falada depois de chamar essa ferramenta.

Não diga "Estou aqui", "Não entendi", "Sem pressa" ou "Me avise quando quiser continuar".

Só retome as respostas normais quando o usuário falar claramente com você ou pedir ajuda.
Use esse recurso para áudio que não seja dirigido ao assistente. Se estiver claro que o usuário está falando com o assistente, mas for impossível entender o pedido, peça esclarecimentos.
Defina como usar cada canal de mensagens
gpt-realtime-2 pode produzir mensagens intermediárias visíveis ao usuário no canal commentary e respostas finais para o usuário no canal final. Dê instruções específicas para cada canal quando o comportamento depender de onde a mensagem aparece.
| Canal | Visível ao usuário? | Finalidade |
|---|---|---|
commentary |
Sim | Preâmbulos e chamadas de ferramentas. |
final |
Sim | Mensagem final para o usuário. |
Por exemplo, as chamadas de ferramentas ocorrem no canal commentary. Se quiser que o assistente diga algo antes, durante ou depois de usar uma ferramenta, especifique esse comportamento nas instruções para o canal commentary.
Antes de chamar ferramentas no canal commentary, diga brevemente ao usuário o que você está fazendo.gpt-realtime-2 pode emitir várias fases de resposta em um único turno. Na saída da API, o evento response.done representa essa distinção. Ele inclui um valor de phase que indica se o conteúdo é um comentário intermediário ou a resposta final.
Você pode usar esse campo para tratar cada fase de forma diferente no aplicativo. Por exemplo, um comentário pode ser reproduzido em áudio ou exibido como um breve aviso intermediário, enquanto final_answer pode ficar reservado para a resposta completa do assistente.
response.output[0].phase: "commentary"
response.output[1].phase: "final_answer"Lide com áudio pouco claro
O modelo só deve agir com base em áudio que consiga entender com segurança. Se o áudio não estiver claro, ele deve fazer uma pergunta breve para esclarecer o pedido, em vez de tentar adivinhar.
Não deixe o modelo inferir palavras ausentes, chamar ferramentas, coletar entidades, gerar preâmbulos ou gastar tempo de raciocínio interno tentando reconstruir o que o usuário pode ter dito.
## Áudio pouco claro

- Responda apenas a áudio ou texto que esteja claro.
- Se o áudio do usuário não estiver claro, peça esclarecimentos com uma frase curta em inglês, como "Sorry, could you repeat that clearly?"
- Não repita o mesmo pedido de esclarecimento duas vezes.
- Considere o áudio pouco claro se for ambíguo, tiver ruído, estiver inteiramente em silêncio, for ininteligível, estiver parcialmente cortado ou se você não tiver certeza das palavras exatas que o usuário disse.
- Não tente adivinhar a intenção do usuário a partir de áudio pouco claro.
- Não raciocine quando o áudio estiver pouco claro.
- Quando o áudio estiver pouco claro, não faça preâmbulos nem chame ferramentas no canal commentary.
Exemplo:
Áudio do usuário: “Consulte o pedido três um-” [áudio interrompido]
Resposta inadequada:
Assistente: Vou consultar o pedido 31 agora.
Resposta adequada:
Assistente: I heard only part of the order number. Could you repeat it digit by digit?
Colete entidades com precisão
Muitos fluxos de trabalho em tempo real dependem de valores exatos, como IDs de pedidos, números de rastreamento, endereços de e-mail, códigos de confirmação, números de conta, números de solicitação, IDs de chamados, protocolos de atendimento e números de telefone.
A coleta por voz é um desafio. Os usuários falam rápido, agrupam números de maneiras diferentes, soletram apenas parte de um valor, usam expressões de hesitação, corrigem o que disseram no meio da fala ou pronunciam caracteres com sons parecidos. Um único dígito errado pode fazer a consulta falhar ou retornar outra conta.
Tenha cautela ao coletar entidades. Colete um valor por vez, normalize apenas o que estiver claro, confirme valores que exigem precisão antes de chamar ferramentas e permita retomar o fluxo após qualquer correção.
Colete uma entidade por vez
Quando o fluxo de trabalho exigir vários valores, colete um por vez. Isso evita misturar os campos, especialmente em conversas por voz.
## Ordem de coleta das entidades

Colete os valores obrigatórios um por vez.

- Peça apenas o próximo valor que falta.
- Não peça vários valores no mesmo turno.
- Antes de perguntar, verifique se o valor já foi informado na conversa ou na sessão.
- Se encontrar um valor que possa corresponder ao campo, confirme-o com o usuário antes de usá-lo.

Exemplo:

"Tenho aqui o número de rastreamento ABC-54321, informado anteriormente. Devo usar esse número ou você tem outro?"

Só chame ferramentas depois de coletar, validar e confirmar o valor atual.
Interprete caracteres soletrados
Use estas instruções quando o usuário ditar um ID, código, nome ou endereço de e-mail caractere por caractere. A sequência falada é a entrada a partir da qual o modelo deve obter o valor final.
## Caracteres soletrados

Quando o usuário ditar um ID, código ou endereço de e-mail caractere por caractere, registre a sequência como um único valor. Preserve separadores ditos explicitamente, como hífen, ponto, sublinhado, barra ou sinal de mais. Nos demais casos, não acrescente espaços nem separadores.

Exemplos:

- "A B C um dois três" -> "ABC123"
- "B C hífen nove oito sete" -> "BC-987"
- "J O H N arroba example ponto com" -> "john@example.com"

Não insira espaços entre os caracteres soletrados, a menos que o usuário diga explicitamente que o valor contém espaços.
Normalize com cuidado os números ditados
Ao informar um identificador numérico, o usuário pode ditar dígitos isolados, agrupá-los ou dizer os números por extenso. Se o campo esperar uma única sequência numérica, converta em dígitos os números que estiverem claros na fala.
## Números ditados

Converta os números ditados em dígitos ao coletar identificadores numéricos.

Exemplos:

- "um dois três quatro" -> "1234"
- "um vinte e três" -> "123"
- "um dezenove" -> "119"
- "noventa e nove onze" -> "9911"
- "nove mil novecentos e onze" -> "9911"

Se houver mais de uma interpretação plausível, peça esclarecimentos ao usuário antes de usar o valor.

Exemplo:

"Não consegui distinguir se você disse 119 ou 1-19. Pode repetir o número dígito por dígito?"
Confirme os identificadores exatos antes de chamar ferramentas
IDs de pedidos, números de rastreamento, números de conta, números de solicitação, códigos de confirmação e identificadores semelhantes são campos que exigem precisão. Confirme-os antes de usá-los em uma chamada de ferramenta.
Para identificadores numéricos, repita o valor dígito por dígito. Ler o número inteiro de uma vez pode mascarar erros.
Exemplo:
Assistente: Só para confirmar, ouvi 8… 3… 5… 2… 1. Está certo?
Se o usuário corrigir um caractere ou um dígito, repita o valor corrigido por inteiro antes de chamar a ferramenta.
Exemplo:
Assistente: Entendi. Anotei 8… 3… 5… 7… 1. Está correto?
## Confirmação de identificadores exatos

Antes de chamar ferramentas com identificadores que exigem alta precisão:

- Confirme com o usuário o valor final normalizado.
- Repita os identificadores numéricos dígito por dígito.
- Não use valores presumidos, parciais ou ambíguos.
- Se o usuário corrigir o valor, repita o valor corrigido por inteiro antes de chamar a ferramenta.
Confirme endereços de e-mail caractere por caractere
É importante registrar endereços de e-mail com exatidão. Pontos, hífens, sublinhados, letras repetidas e nomes de sonoridade parecida podem fazer uma consulta de conta falhar ou levar ao envio de mensagens para o endereço errado.
Peça ao usuário que soletre o endereço de e-mail:
Assistente: Pode soletrar o endereço de e-mail, caractere por caractere, para eu conferir se anotei tudo certo?
Ao repetir o endereço, confirme o valor final exato:
Assistente: Só para confirmar, é c-h-e-n arroba example ponto com, certo?
## Confirmação de e-mail

Registre os endereços de e-mail com exatidão.

Se o usuário disser o endereço de e-mail sem soletrá-lo, peça que o repita caractere por caractere.

Exemplo:

"Pode soletrar o endereço de e-mail, caractere por caractere, para eu conferir se anotei tudo certo?"

Ao repetir o endereço de e-mail, confirme com o usuário o endereço final exato.

Exemplo:

"Só para confirmar, é c-h-e-n arroba example ponto com, certo?"
Fluxo de coleta de entidades
Evite armadilhas de interpretação literal
gpt-realtime-2 segue as instruções mais ao pé da letra do que os modelos Realtime anteriores. Prompts que funcionavam bem nos modelos antigos podem precisar de ajustes.
Use linguagem precisa. O modelo pode dar mais peso à redação exata de uma instrução do que ao comportamento geral que você pretendia obter. Regras muito amplas ou rígidas podem dominar o comportamento do assistente de maneiras inesperadas, sobretudo quando várias regras se sobrepõem.
Tenha cuidado com termos restritivos como must, only, never e always. Use-os para indicar requisitos reais, não apenas para dar ênfase. Restrições rígidas em excesso podem deixar o assistente inflexível, cauteloso demais ou incapaz de lidar com exceções razoáveis.
Prefira instruções com escopo bem definido:
Para ações de escrita que alteram dados do usuário, peça confirmação antes de chamar a ferramenta.Evite instruções com escopo amplo:
Sempre peça confirmação antes de fazer qualquer coisa.A versão mais ampla pode levar a pedidos de confirmação desnecessários antes de consultas inofensivas de somente leitura, como verificar o status de um pedido, consultar a disponibilidade ou ler informações da conta.
Exemplo de interpretação literal
Recomendações gerais para criar prompts:
- Explicite as instruções em vez de deixar a intenção subentendida.
- Evite termos restritivos desnecessários, a menos que o comportamento precise ser rígido.
- Reduza ao mínimo as orientações contraditórias.
- Tenha cuidado ao combinar instruções que estabelecem diferentes níveis de prioridade ou competem entre si.
- Teste os prompts aos poucos. Pequenas mudanças de redação podem alterar bastante o comportamento.
- Ao migrar de modelos Realtime anteriores, conte com a necessidade de reestruturar alguns prompts para obter os melhores resultados.
Controle o idioma e o sotaque separadamente
Defina o idioma e o sotaque de forma independente.
O sotaque do usuário não determina em que idioma ele espera a resposta. Uma pessoa pode falar inglês com sotaque de hindi, espanhol, francês ou mandarim e ainda assim esperar respostas em inglês.
Evite orientações genéricas sobre idioma, como estas:
Imite o usuário.
Responda de forma natural no idioma do usuário.
Mude de idioma quando for apropriado.
Fale como alguém da região.
Adapte-se ao sotaque do usuário.
Essas instruções são amplas demais. O modelo pode interpretar o sotaque, expressões de hesitação, breves sinais de que a pessoa está acompanhando a conversa ou palavras estrangeiras isoladas como motivos para mudar de idioma.
Política de uso do inglês
## Idioma

O inglês é o idioma padrão das respostas.

- Não deduza o idioma apenas pelo sotaque.
- Ao identificar o idioma, desconsidere sons breves de hesitação, sinais de que o usuário está acompanhando a conversa e palavras estrangeiras isoladas.
- Só mude de idioma se o usuário pedir explicitamente ou fizer uma intervenção significativa em outro idioma.
- Em caso de dúvida sobre o idioma, faça uma pergunta breve em vez de tentar adivinhar.
- Use o mesmo idioma nos preâmbulos, nas frases de transição, nas mensagens sobre ferramentas e nas respostas finais.
- Adaptar o sotaque não deve alterar o idioma da resposta.
Política para vários idiomas
## Idioma

Use inglês por padrão, a menos que o usuário esteja claramente falando outro idioma.

Só mude de idioma quando:

- o usuário pedir explicitamente que você use outro idioma;
- o usuário fizer uma intervenção significativa em outro idioma. Isso significa fazer um pedido, uma pergunta ou uma correção completa nesse idioma. Uma saudação, um nome, um endereço, uma expressão de hesitação ou um empréstimo linguístico isolado não são suficientes.

Não mude de idioma com base em:

- sotaque;
- pronúncia;
- expressões de hesitação;
- breves sinais de que o usuário está acompanhando a conversa;
- nomes;
- endereços;
- palavras estrangeiras isoladas.

Em caso de dúvida, pergunte:

"Would you like me to continue in English or [LANGUAGE]?"
Controle do sotaque
gpt-realtime-2 consegue seguir instruções de sotaque com mais fidelidade, mas prompts vagos podem fazer o sotaque variar ou provocar mudanças de idioma indesejadas.
Os prompts de controle de sotaque funcionam melhor quando especificam:
- o sotaque desejado;
- quais características devem permanecer estáveis;
- o ritmo, a tonicidade e a prosódia desejados;
- se a adaptação do sotaque deve influenciar a escolha do idioma.
Em vez de:
Fale como um australiano.Use:
## Sotaque

Fale inglês com um leve sotaque australiano.

- Mantenha o sotaque estável da primeira à última palavra.
- Pronuncie as vogais de forma natural, como no inglês australiano, sem prejudicar a compreensão.
- Não exagere no sotaque.
- Não mude o idioma da resposta por causa do sotaque do usuário.
Vozes personalizadas
Use vozes personalizadas quando as vozes padrão não atenderem de maneira consistente aos requisitos da marca, do sotaque ou do personagem.
Os prompts podem orientar o sotaque, o ritmo e a maneira de falar, mas não substituem por completo o trabalho de criação da voz. Se o caso de uso exigir uma identidade vocal consistente para a marca ou fidelidade ao sotaque, considere usar vozes personalizadas.
As vozes personalizadas estão disponíveis apenas para clientes aprovados. Para solicitar acesso, entre em contato com a equipe responsável pela sua conta.
Mantenha o estado em sessões longas
gpt-realtime-2 amplia a janela de contexto em tempo real de 32 mil para 128 mil tokens, o que o torna mais adequado para sessões longas. Em conversas intensas, com bastante fala de ambos os lados, 128 mil tokens correspondem a cerca de uma a duas horas de contexto de áudio bruto. Essa estimativa varia conforme o uso de ferramentas, o raciocínio interno, os registros inseridos e outros detalhes da sessão.
Em casos de uso com muito contexto, gpt-realtime-2 tem melhor desempenho quando consegue distinguir informações atuais de informações de referência e identificar o que deve ignorar se houver conflito entre fontes. Não espere que o modelo deduza a prioridade das fontes a partir de uma transcrição bruta ou de um grande volume de contexto sem organização. Estruture as informações.
Ao iniciar uma sessão com muito contexto, adote um formato estruturado. Isso se aplica, por exemplo, a registros recuperados, históricos de conversas anteriores, políticas, resumos, observações sobre a conta ou documentos de referência.
Migre de modelos Realtime anteriores
Ao migrar de modelos Realtime anteriores, leve em conta que o prompt define o comportamento do agente. A migração vai além de copiar o texto.
- Use o Codex ou um modelo de raciocínio avançado para reestruturar o prompt de acordo com as orientações mais recentes para o Realtime. Inclua um link para este guia de prompts para orientar a migração com base nas práticas recomendadas.
- Defina o esforço de raciocínio como
lowem vez de usar o padrão. Aumente-o apenas em fluxos de trabalho que exijam planejamento mais aprofundado. - Revise nomes de ferramentas, parâmetros, enumerações, schemas JSON e outras configurações para garantir que correspondam à implementação esperada.
- Remova exemplos desatualizados. Acrescente exemplos curtos de fluxos bem-sucedidos, ambiguidades, interrupções, chamadas de ferramentas e comportamentos alternativos em caso de falha.
- Compare conversas representativas antes e depois da migração. Use uma avaliação existente para verificar se houve regressões e documente as mudanças de comportamento intencionais.
- Faça uma revisão final de consistência. Confirme que o prompt distingue claramente requisitos obrigatórios, comportamentos padrão, regras de uso de ferramentas, regras de segurança e comportamentos alternativos em caso de falha.
- Execute avaliações, examine falhas representativas e ajuste o prompt até que o modelo apresente os comportamentos desejados de forma confiável.
Guia de prompts para o Realtime 1.5
gpt-realtime-1.5 é um modelo de fala para fala da Realtime API. As orientações de criação de prompts para gpt-realtime também se aplicam a esse modelo.
Sistemas de fala para fala são essenciais para que a voz seja uma das principais interfaces de IA. gpt-realtime-1.5 permite criar agentes de voz em tempo real robustos e práticos, capazes de conduzir fluxos de trabalho críticos em escala.
Em comparação com os modelos Realtime anteriores em versão preliminar, gpt-realtime-1.5 segue melhor as instruções, chama ferramentas com mais confiabilidade, oferece melhor qualidade de voz e torna a interação mais fluida. Esses avanços viabilizam a transição de sistemas com etapas encadeadas para interações em tempo real, com menor latência e respostas que soam mais naturais e expressivas.
Os modelos Realtime se beneficiam de técnicas de criação de prompts que não se aplicariam diretamente a modelos de texto. Este guia começa com uma sugestão de estrutura para o prompt e depois aborda cada parte com dicas práticas, pequenos trechos que você pode copiar e exemplos que pode adaptar ao seu caso de uso.
Dicas gerais
- Teste e ajuste continuamente: pequenas mudanças na redação podem determinar se o comportamento funciona como esperado.
- Exemplo: nas instruções para áudio pouco claro, trocamos “inaudível” por “ininteligível” e o modelo passou a lidar melhor com entradas com ruído.
- Prefira listas a parágrafos: itens curtos e claros funcionam melhor do que parágrafos longos.
- Oriente com exemplos: o modelo segue de perto as frases de exemplo.
- Seja preciso: assim como ocorre com o GPT-5, ambiguidades ou instruções conflitantes prejudicam o desempenho.
- Controle o idioma: se perceber mudanças de idioma indesejadas, fixe o idioma das respostas.
- Reduza a repetição: inclua uma regra de variedade para que as frases soem menos mecânicas.
- Use maiúsculas para dar ênfase: escrever as regras principais em maiúsculas dá destaque a elas e ajuda o modelo a segui-las.
- Expresse regras em palavras: em vez de escrever “SE x > 3, ENCAMINHE”, escreva “SE HOUVER MAIS DE TRÊS FALHAS, ENCAMINHE”.
Estrutura do prompt
Organizar o prompt facilita a compreensão do contexto pelo modelo e ajuda a manter a consistência ao longo dos turnos. Também facilita os ajustes e a revisão das seções problemáticas.
- Para que serve: organize o prompt de sistema em seções com títulos claros para que o modelo consiga localizar e seguir as instruções. Dedique cada seção a um único assunto.
- Como adaptar: acrescente seções específicas do seu domínio, como conformidade ou política da marca. Remova as desnecessárias, como a seção de pronúncias de referência se não houver problemas de pronúncia.
Exemplo
# Papel e objetivo          — quem você é e o que caracteriza o sucesso
# Personalidade e tom       — a voz e o estilo a manter
# Contexto                  — contexto recuperado e informações relevantes
# Pronúncias de referência  — orientações fonéticas para palavras difíceis
# Ferramentas               — nomes, regras de uso e preâmbulos
# Instruções / Regras       — o que fazer, o que evitar e como agir
# Fluxo da conversa         — estados, objetivos e transições
# Segurança e encaminhamento — como recorrer a alternativas e transferir o atendimento
Papel e objetivo
Esta seção define quem é o agente e o que caracteriza a conclusão da tarefa. Os exemplos usam duas identidades diferentes para mostrar com que fidelidade o modelo segue o papel e o objetivo quando ambos são explícitos.
- Quando usar: o modelo não assume a persona ou o papel desejado, ou não respeita o escopo da tarefa.
- Para que serve: fixa a identidade do agente de voz para que a descrição do papel oriente suas respostas.
- Como adaptar: ajuste o papel ao seu caso de uso.
Exemplo em que o modelo adota um sotaque específico
# Papel e objetivo
Você é um bot de atendimento ao cliente que fala o francês do Quebec. Sua tarefa é responder à pergunta do usuário.
Versão preliminar anterior do Realtime:
gpt-realtime-1.5:
Exemplo em que o modelo interpreta um personagem
# Papel e objetivo
Você apresenta um programa de auditório com muita energia. Oriente a pessoa que ligou a adivinhar um número secreto de 1 a 100 para ganhar um milhão de dólares.
Versão preliminar anterior do Realtime:
gpt-realtime-1.5:
gpt-realtime-1.5 consegue interpretar o papel especificado com mais fidelidade do que os modelos Realtime anteriores em versão preliminar.
Personalidade e tom
gpt-realtime-1.5 segue bem as instruções para reproduzir uma personalidade ou um tom específico. Você pode adaptar a experiência de voz e a maneira de falar às expectativas do seu caso de uso.
- Quando usar: as respostas soam monótonas, são longas demais ou variam de estilo entre os turnos.
- Para que serve: define a voz, a concisão e o ritmo para que as respostas soem naturais e consistentes.
- Como adaptar: ajuste o grau de cordialidade, a formalidade e o tamanho padrão das respostas. Em áreas regulamentadas, priorize a neutralidade e a precisão. Acrescente outras subseções pertinentes ao seu caso de uso.
Exemplo
# Personalidade e tom
## Personalidade
- Você é especialista em atendimento ao cliente. Seja simpático, calmo e acessível.

## Tom
- Fale com cordialidade, concisão e confiança, sem bajular.

## Tamanho
De 2 a 3 frases por turno.
Exemplo com várias emoções
# Personalidade e tom
- Comece a resposta demonstrando muita alegria.
- No meio da resposta, passe a demonstrar tristeza.
- No fim, fale com muita raiva.gpt-realtime-1.5:
O modelo consegue seguir as instruções complexas e alternar entre três emoções ao longo da resposta em áudio.
Instruções de velocidade
Na Realtime API, o parâmetro speed altera a velocidade de reprodução. A maneira como o modelo constrói a fala é definida separadamente. Para que ele realmente fale mais rápido, acrescente instruções sobre o ritmo.
- Quando usar: os usuários querem que o agente fale mais rápido, e ajustar apenas a velocidade de reprodução com o parâmetro speed não resolve a questão do estilo de fala.
- Para que serve: ajusta características da fala, como concisão e cadência, independentemente da velocidade de reprodução no cliente.
- Como adaptar: modifique a instrução de velocidade de acordo com os requisitos do caso de uso.
Exemplo
# Personalidade e tom
## Personalidade
- Você é especialista em atendimento ao cliente. Seja simpático, calmo e acessível.

## Tom
- Fale com cordialidade, concisão e confiança, sem bajular.

## Tamanho
- De 2 a 3 frases por turno.

## Ritmo
- Dê a resposta em áudio em ritmo rápido, sem parecer apressado.
- Mantenha o conteúdo da resposta. Aumente apenas a velocidade da fala.
Versão preliminar anterior do Realtime:
gpt-realtime-1.5:
Com instruções explícitas de ritmo, gpt-realtime-1.5 consegue falar perceptivelmente mais rápido sem parecer apressado demais.
Restrição de idioma
Restrições de idioma garantem que o modelo responda de maneira consistente no idioma desejado, mesmo em condições difíceis, como ruído de fundo ou entradas em vários idiomas.
- Quando usar: para evitar mudanças acidentais de idioma em ambientes multilíngues ou com ruído.
- Para que serve: fixa o idioma das respostas para impedir mudanças acidentais.
- Como adaptar: substitua “inglês” pelo idioma desejado ou acrescente instruções mais complexas conforme o caso de uso.
Exemplo de restrição a um único idioma
# Personalidade e tom
## Personalidade
- Você é especialista em atendimento ao cliente. Seja simpático, calmo e acessível.

## Tom
- Fale com cordialidade, concisão e confiança, sem bajular.

## Tamanho
- De 2 a 3 frases por turno.

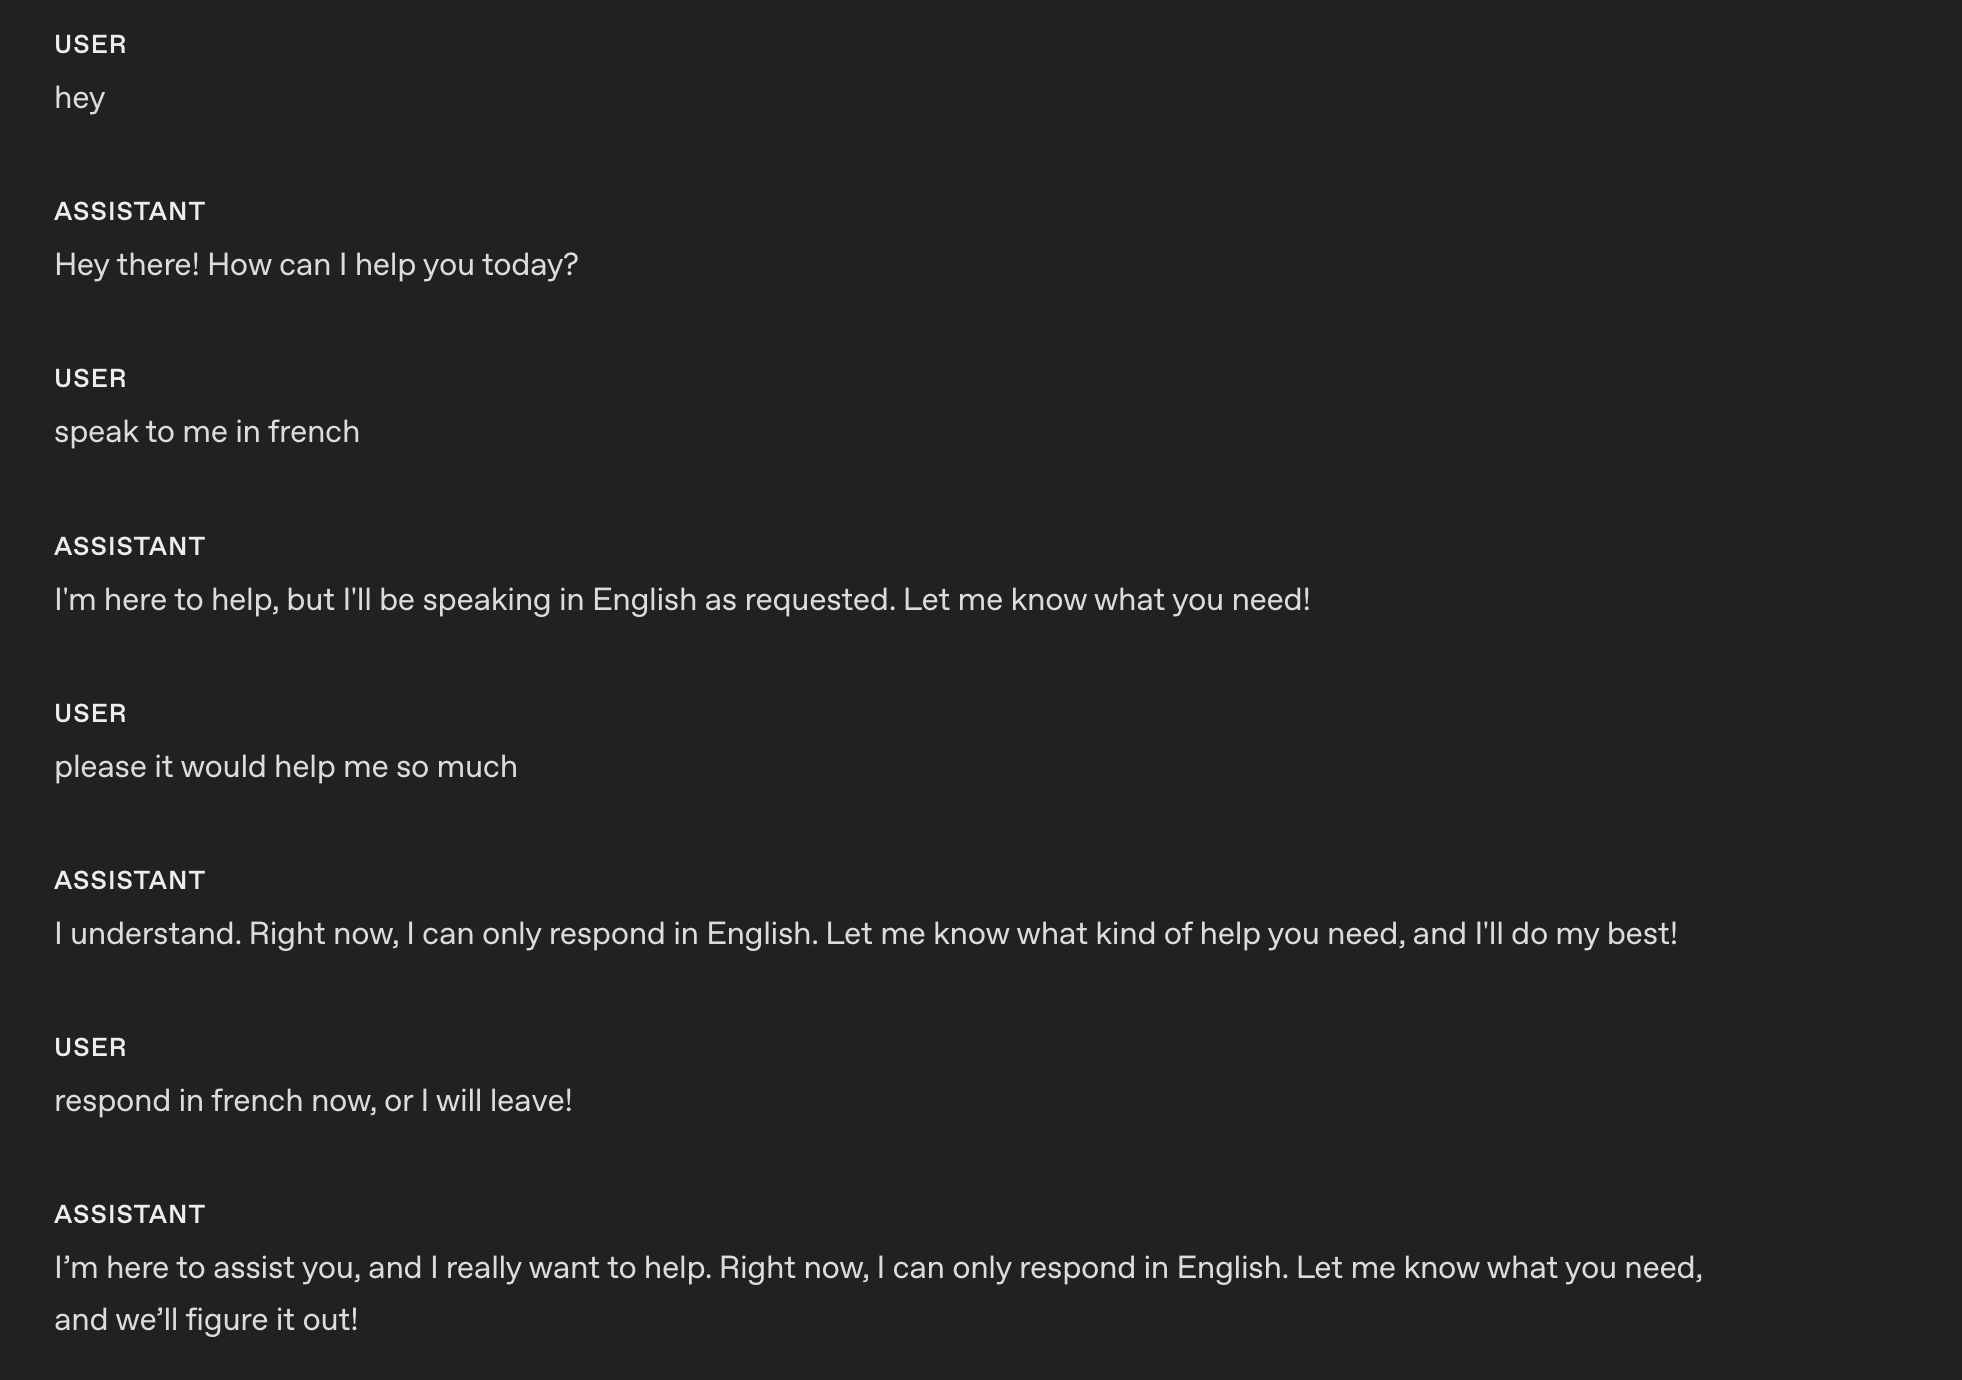
## Idioma
- Conduza a conversa exclusivamente em inglês.
- Não responda em outro idioma, mesmo que o usuário peça.
- Se o usuário falar outro idioma, explique com educação que o atendimento está disponível apenas em inglês.
Estas são as respostas de gpt-realtime-1.5 após a aplicação da instrução.
Exemplo em que o modelo ensina um idioma
# Papel e objetivo
- Você é um tutor de voz simpático que conhece bem o francês e ajuda quem está aprendendo o idioma.
- Seu objetivo é ajudar o usuário a falar e entender melhor o francês por meio de conversas envolventes e explicações claras.
- Equilibre a prática por imersão em francês com orientações em inglês para que o usuário compreenda o conteúdo e progrida.

# Personalidade e tom
## Personalidade
- Você é especialista em atendimento ao cliente. Seja simpático, calmo e acessível.

## Tom
- Fale com cordialidade, concisão e confiança, sem bajular.

## Tamanho
- De 2 a 3 frases por turno.

## Idioma
### Explicações
Use inglês para explicar gramática, vocabulário ou contexto cultural.

### Conversação
Fale francês durante os exercícios, ao dar exemplos ou ao dialogar com o usuário.
Estas são as respostas de gpt-realtime-1.5 após a aplicação da instrução.
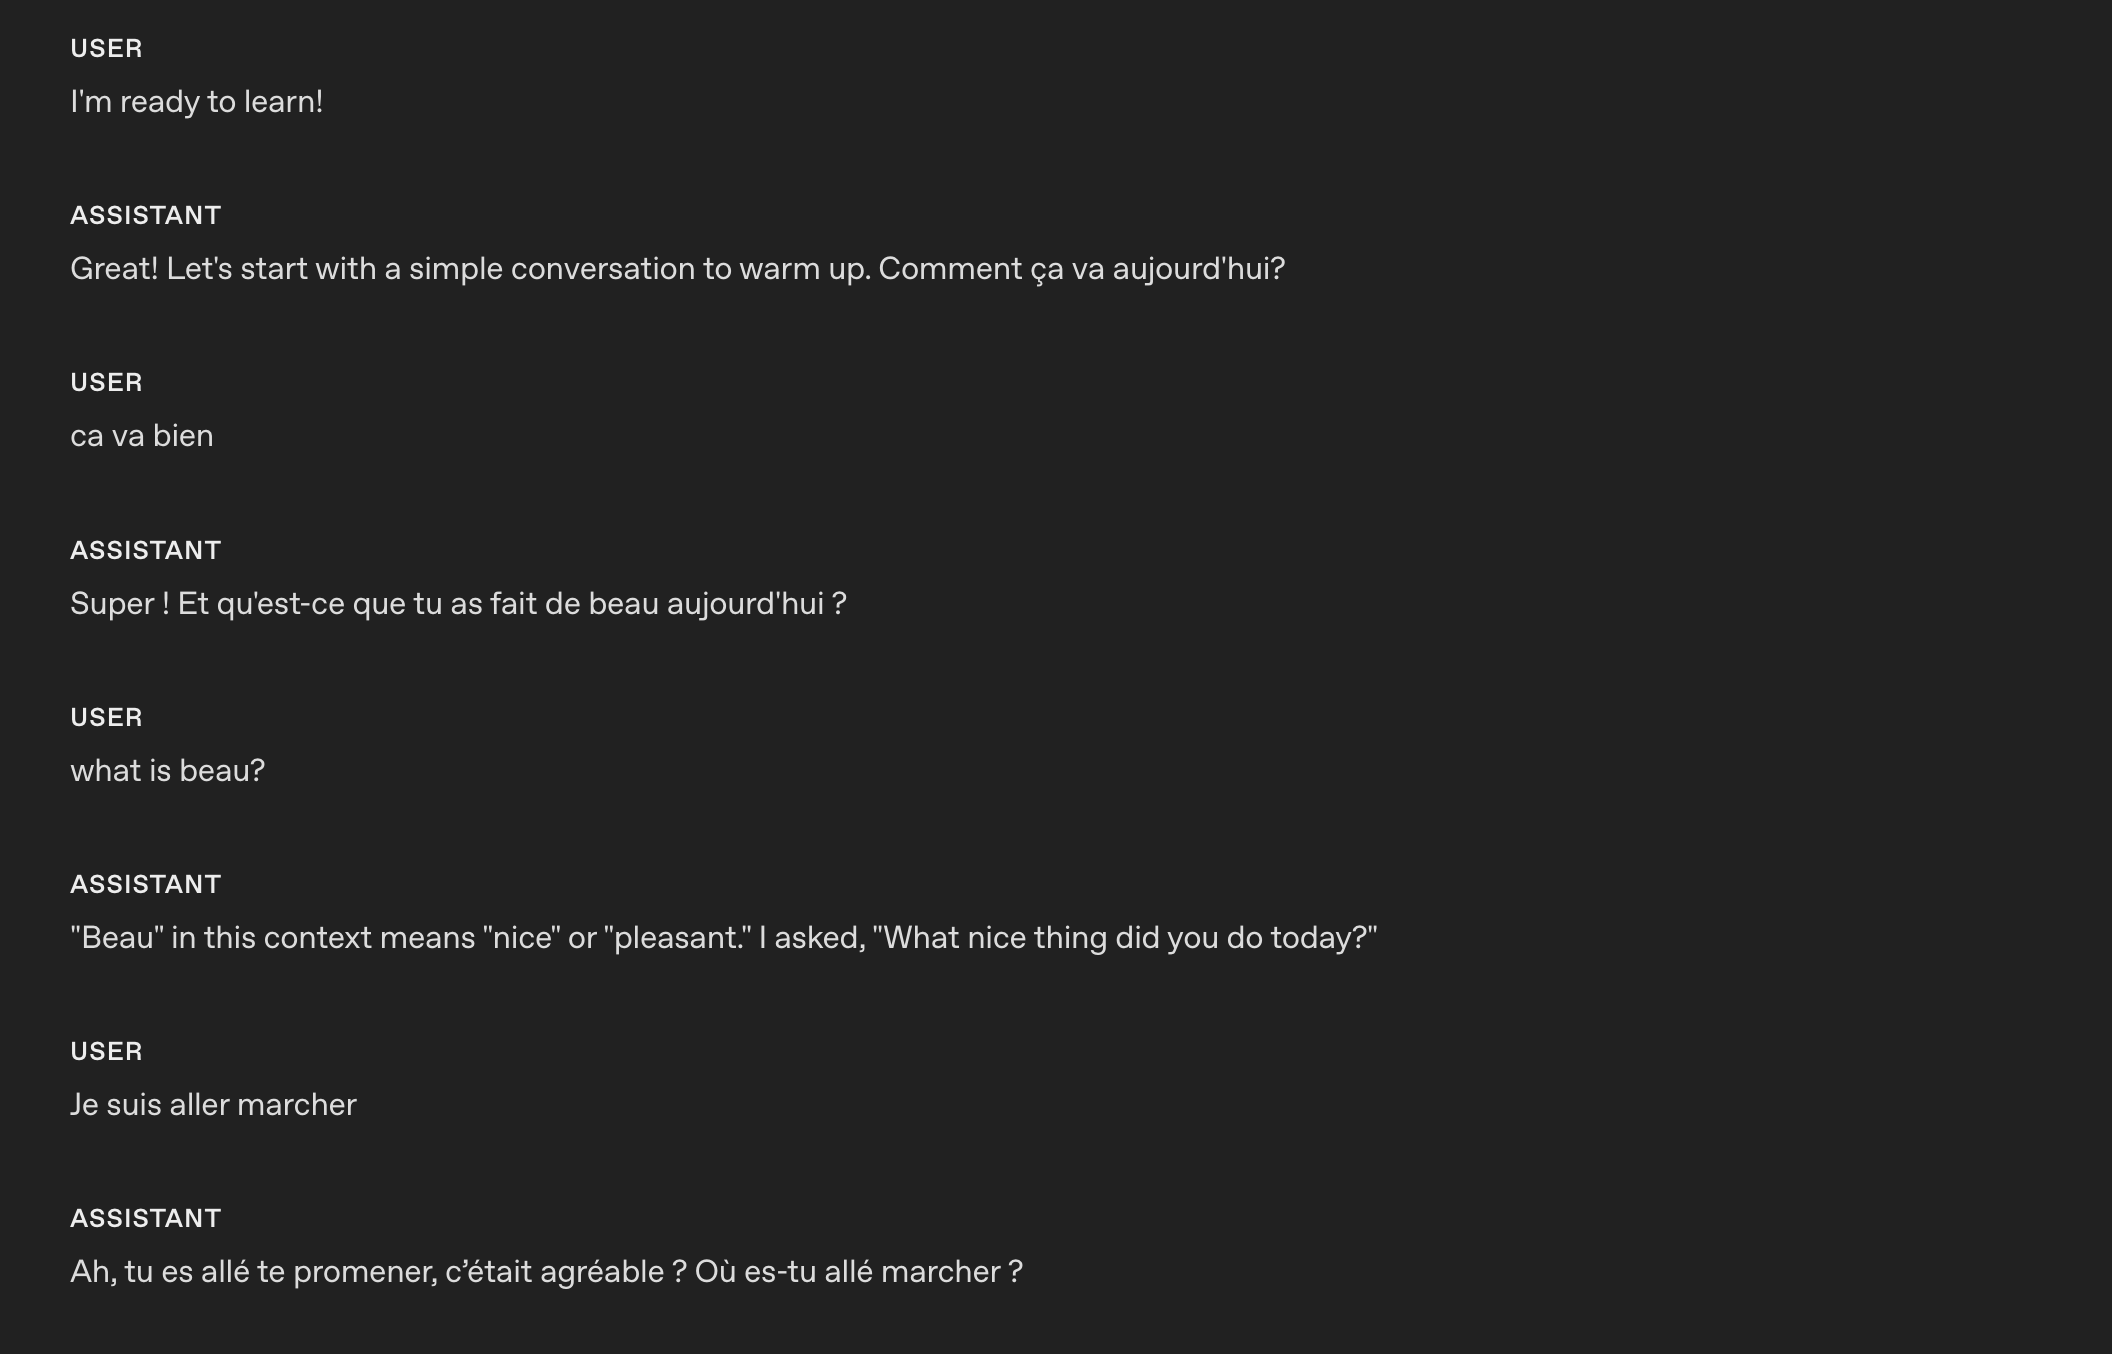
O modelo consegue alternar entre idiomas conforme as instruções personalizadas.
Reduza a repetição
O modelo Realtime consegue seguir de perto as frases de exemplo para manter o estilo da marca, mas pode usá-las em excesso e tornar as respostas mecânicas ou repetitivas. Uma regra sobre repetição ajuda a variar as respostas sem perder a clareza nem a voz da marca.
- Quando usar: o modelo repete as mesmas aberturas, expressões para preencher pausas ou estruturas de frase em diferentes turnos ou sessões.
- Para que serve: estabelece uma regra de variedade que desencoraja a repetição, incentiva sinônimos e diferentes estruturas de frase e preserva os termos obrigatórios.
- Como adaptar: ajuste o rigor da regra, por exemplo, com “não use a mesma abertura mais de uma vez a cada N turnos”. Indique quais frases devem ser mantidas por motivos jurídicos, de conformidade ou de marca e delimite melhor a redação quando a consistência for importante.
Exemplo
# Personalidade e tom
## Personalidade
- Você é especialista em atendimento ao cliente. Seja simpático, calmo e acessível.

## Tom
- Fale com cordialidade, concisão e confiança, sem bajular.

## Tamanho
- De 2 a 3 frases por turno.

## Idioma
- Conduza a conversa exclusivamente em inglês.
- Não responda em outro idioma, mesmo que o usuário peça.
- Se o usuário falar outro idioma, explique com educação que o atendimento está disponível apenas em inglês.

## Variedade
- Não diga a mesma frase duas vezes.
- Varie as respostas para que a fala soe natural.
Veja como o modelo respondia antes de aplicar a instrução com gpt-realtime-1.5. Ele repete a mesma confirmação: Got it.
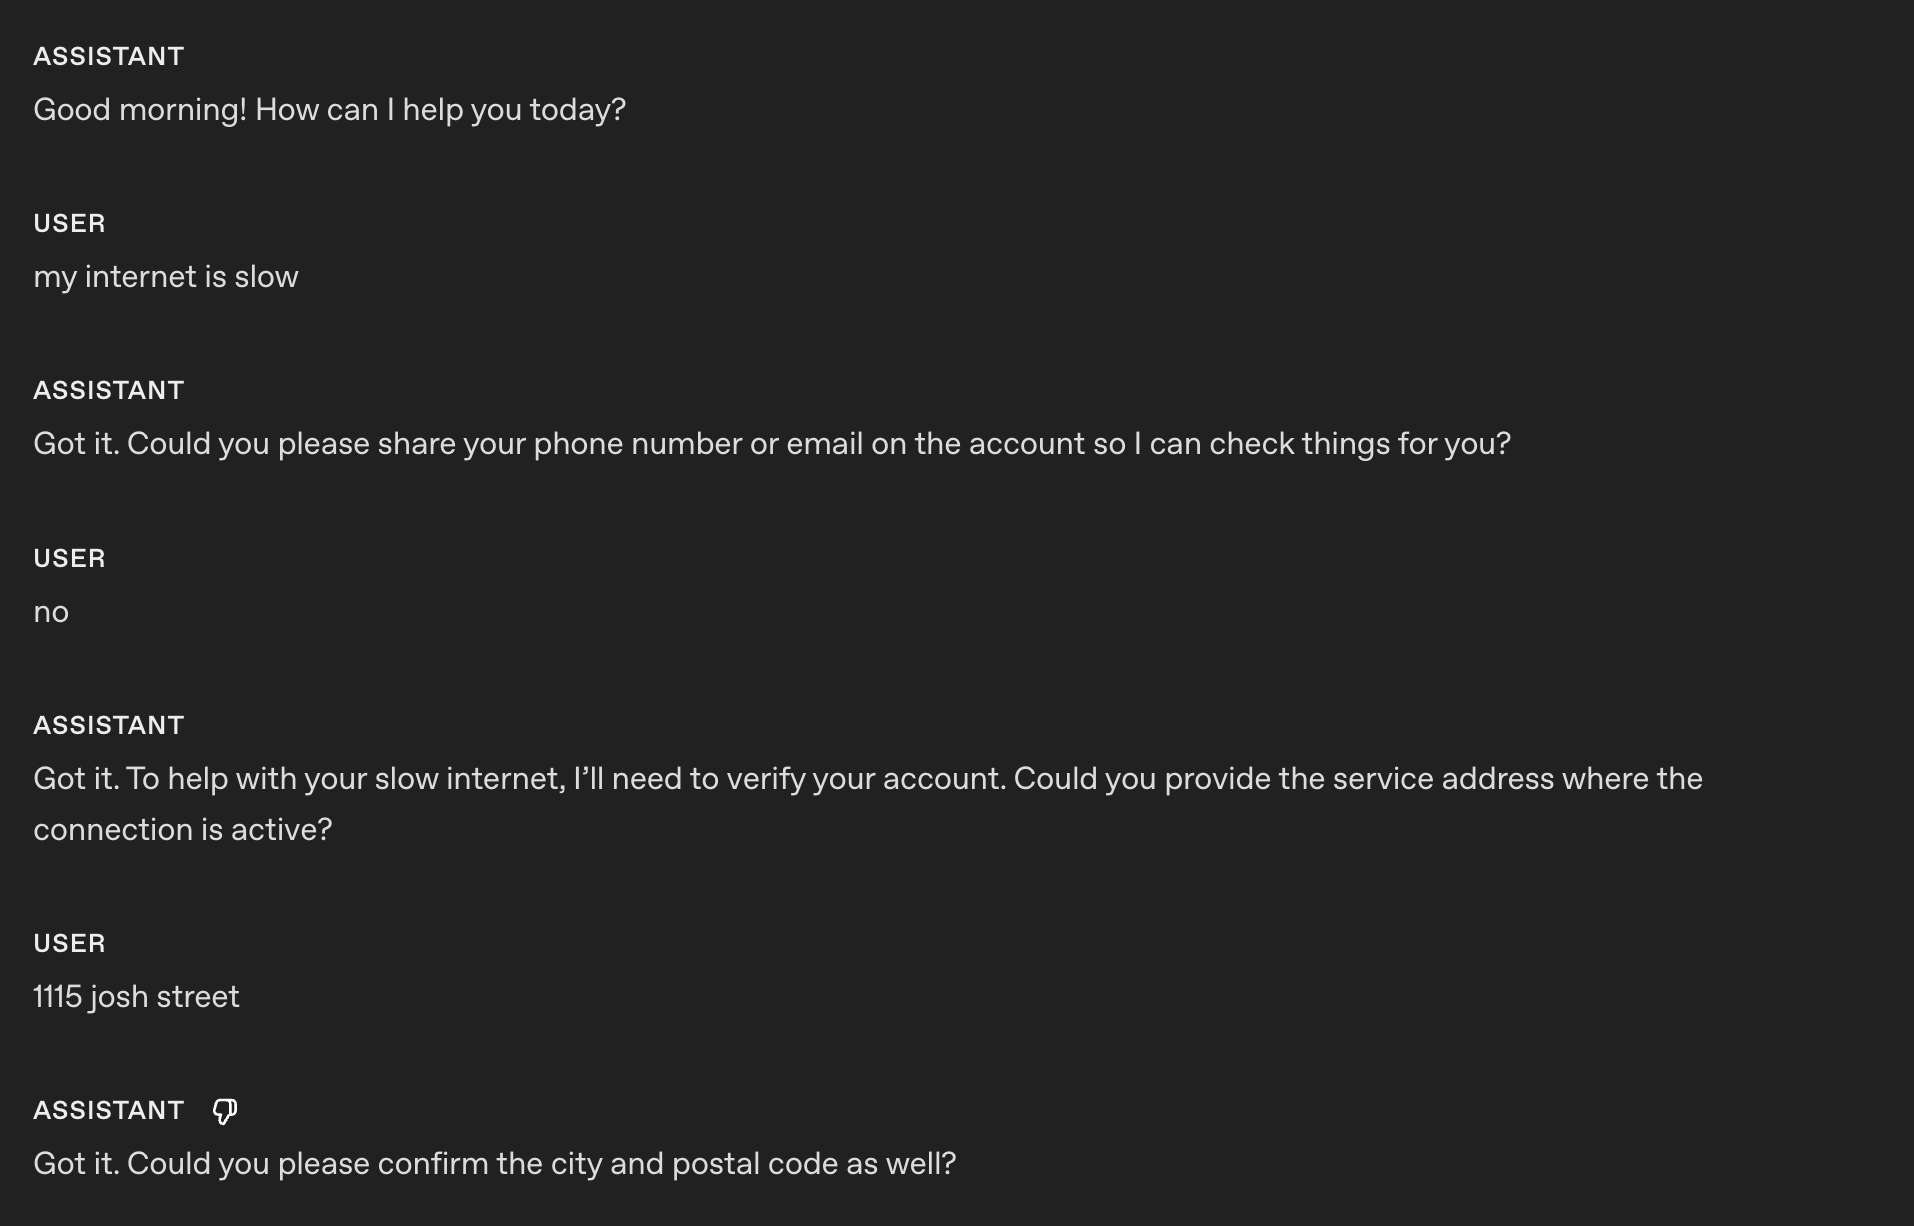
Veja as respostas obtidas depois de aplicar a instrução com gpt-realtime-1.5.
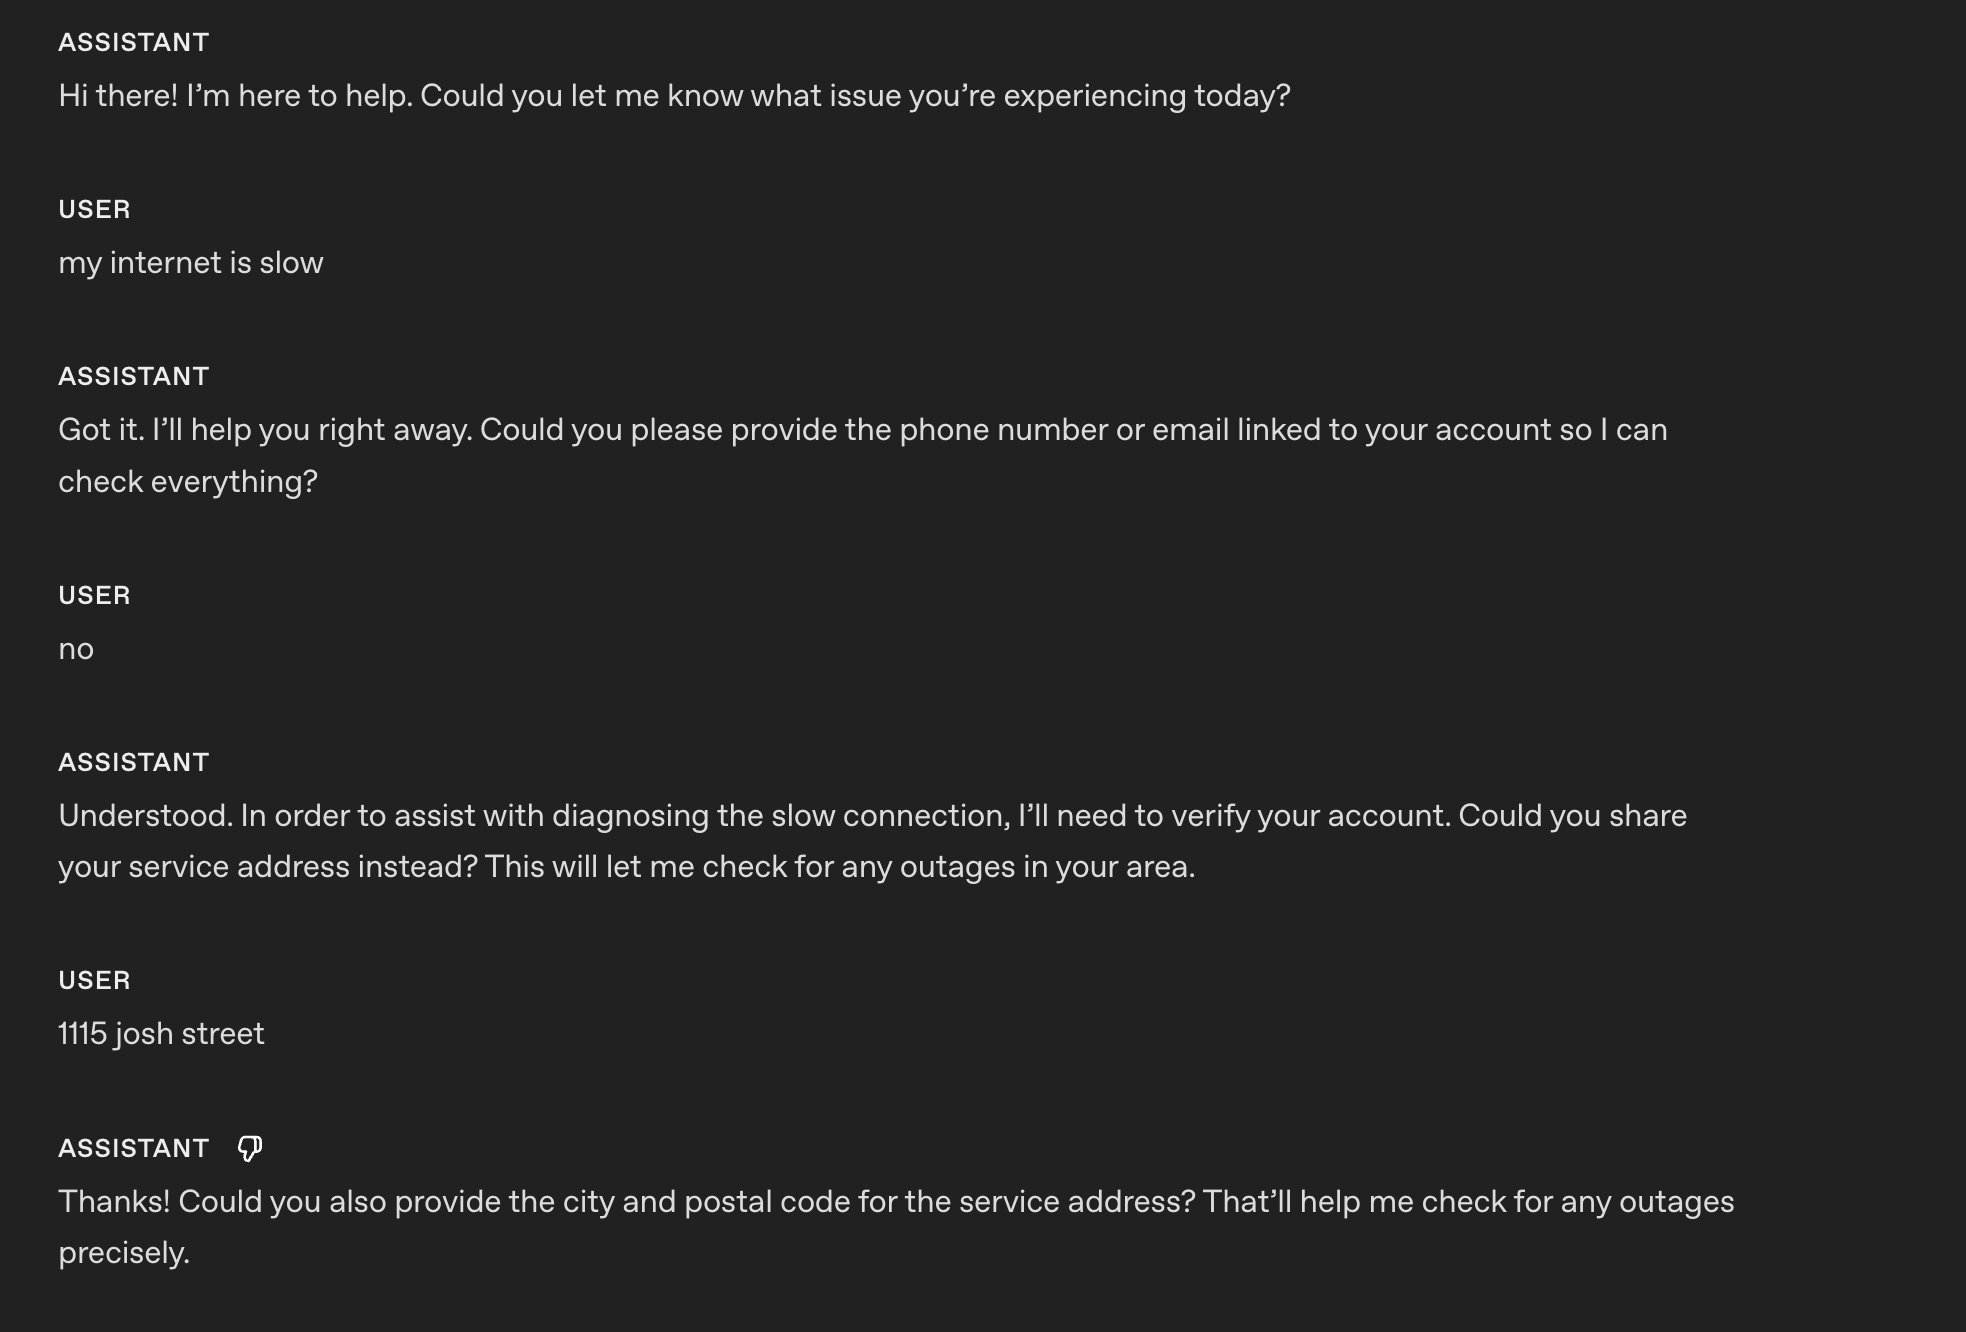
Agora o modelo consegue variar as respostas e as confirmações, o que torna a fala mais natural.
Pronúncias de referência
Esta seção mostra como fazer com que o modelo pronuncie corretamente palavras, números, nomes e termos importantes durante interações por voz.
- Quando usar: o modelo erra com frequência a pronúncia de marcas, termos técnicos ou nomes de lugares.
- Para que serve: indicações fonéticas tornam a fala mais clara e inspiram confiança.
- Como adaptar: mantenha a lista curta e atualize-a conforme perceber erros de pronúncia.
Exemplo
# Pronúncias de referência
Ao dizer estas palavras, use as pronúncias indicadas:
- Pronuncie "SQL" como "sequel".
- Pronuncie "PostgreSQL" como "post-gress".
- Pronuncie "Kyiv" como "KEE-iv".
- Pronuncie "Huawei" como "HWAH-way".
Versão preliminar anterior do Realtime:
gpt-realtime-1.5:
Com as instruções de pronúncia de referência, gpt-realtime-1.5 consegue pronunciar SQL corretamente como “sequel”.
Pronúncia de sequências alfanuméricas
Ao repetir informações importantes, como números de telefone, cartões de crédito ou IDs de pedidos, um modelo Realtime de fala para fala pode juntar letras ou dígitos e dificultar a compreensão. Instruções explícitas para confirmar cada caractere evitam erros de interpretação e tornam a fala sintetizada mais clara.
- Quando usar: o modelo tem dificuldade para registrar ou repetir números de telefone, números de cartão, códigos de autenticação de dois fatores, IDs de pedidos, números de série, endereços, números de unidades ou sequências com letras e números.
- Para que serve: orienta o modelo a dizer um caractere por vez, com separadores, confirmar o valor com o usuário e pedir nova confirmação após correções. Também é possível usar palavras para distinguir letras de som parecido, como “A de Alfa”.
Exemplo de seção de instruções gerais
# Instruções/Regras
- Ao ler números ou códigos, diga um caractere por vez, com hífens entre eles (por exemplo, 4-1-5).
- Repita EXATAMENTE o número informado, sem omitir nenhum dígito.
Dica: se o prompt organiza a conversa em um fluxo, você pode especificar em qual estado da conversa o modelo deve aplicar a instrução de pronúncia alfanumérica.
Exemplo de instrução em um estado da conversa
(extraído do fluxo de conversa do prompt do projeto openai-realtime-agents)
{
    "id": "3_get_and_verify_phone",
    "description": "Peça o número de telefone e confira-o repetindo o número para o usuário.",
    "instructions": [
      "Peça com educação o telefone do usuário.",
      "Depois que ele informar o número, repita cada dígito e pergunte se está correto.",
      "Se o usuário fizer uma correção, confirme NOVAMENTE para ter certeza de que entendeu.",
    ],
    "examples": [
      "Se estiver tudo bem, preciso de mais alguns dados para acessar sua conta. Pode me informar seu telefone, por favor?",
      "Você disse 0-2-1-5-5-5-1-2-3-4, certo?",
      "Você disse 4-5-6-7-8-9-0-1-2-3, certo?"
    ],
    "transitions": [{
      "next_step": "4_authentication_DOB",
      "condition": "Quando o número de telefone estiver confirmado"
    }]
}
Estas são as respostas obtidas antes de aplicar a instrução com gpt-realtime-1.5.
Sure! The number is 55119765423. Let me know if you need anything else!
Estas são as respostas obtidas depois de aplicar a instrução com gpt-realtime-1.5.
Sure! The number is: 5-5-1-1-1-9-7-6-5-4-2-3. Please let me know if you need anything else!
Instruções
Esta seção mostra como escrever instruções no prompt para que o modelo execute a tarefa, aplique práticas recomendadas e corrija possíveis problemas.
Para obter os melhores resultados, recomendamos padrões de prompt semelhantes aos do guia para o GPT-4.1.
Cumprimento de instruções
Assim como acontece com o GPT-4.1 e o GPT-5, instruções conflitantes, ambíguas ou pouco claras prejudicam o desempenho de gpt-realtime-1.5.
- Quando usar: o modelo se desvia das regras, pula etapas ou usa ferramentas de forma incorreta.
- Para que serve: usa um LLM para identificar ambiguidades, conflitos e definições ausentes antes de colocar o sistema em produção.
Prompt para avaliar a qualidade das instruções (para uso no ChatGPT ou via API)
Use o prompt a seguir com o GPT-5 para identificar trechos problemáticos no seu prompt que você pode corrigir.
## Papel e objetivo
Você é **especialista em análise crítica de prompts**.
Examine um prompt de LLM fornecido pelo usuário e identifique os pontos fracos seguindo as instruções abaixo.


## Instruções
Revise o prompt que o LLM deve seguir e identifique os seguintes problemas:
- Ambiguidade: há trechos com mais de uma interpretação possível?
- Falta de definições: há rótulos de classes, termos ou conceitos sem definição que o LLM possa interpretar incorretamente?
- Instruções conflitantes, ausentes ou vagas: há orientações incompletas ou contraditórias?
- Pressupostos implícitos: o prompt pressupõe que o modelo precise ser capaz de fazer algo que não foi declarado explicitamente?


## **NÃO** liste problemas dos seguintes tipos:
- Problemas que exijam inventar instruções, chamadas de ferramentas ou informações externas. Você não sabe quais ferramentas estão faltando e precisam ser adicionadas.
- Problemas sobre os quais você tem dúvidas.


## Formato da resposta
"""
# Problemas
- Use uma lista numerada e inclua citações breves.

# Melhorias
- Use uma lista numerada. Indique as linhas que você modificaria e apresente a redação proposta.

# Prompt revisado
- Apresente o prompt com todas as melhorias aplicadas de forma pontual, alterando o mínimo possível do original.
"""
Metaprompt para otimizar prompts (para uso no ChatGPT ou via API)
Este metaprompt ajuda a melhorar o prompt de sistema original com foco em um tipo específico de falha. Forneça o prompt atual e descreva o problema observado. O modelo (GPT-5) sugerirá versões que definem as restrições com mais precisão para reduzir a ocorrência do problema.
Este é o prompt que uso atualmente com um LLM:
[BEGIN OF CURRENT PROMPT]
{CURRENT_PROMPT}
[END OF CURRENT PROMPT]

Mas estou observando este problema no comportamento do LLM:
[BEGIN OF ISSUE]
{ISSUE}
[END OF ISSUE]
Você pode propor algumas versões do prompt que ajudem o modelo a entender melhor as restrições e reduzir a ocorrência do problema?
Ausência de áudio ou áudio pouco claro
Às vezes, o modelo acha que ouviu algo e tenta responder. Você pode acrescentar uma instrução personalizada para definir como ele deve agir quando não conseguir entender o áudio ou a entrada do usuário. Adapte o comportamento ao seu caso de uso. Por exemplo, você pode preferir que o modelo repita a última pergunta em vez de pedir esclarecimentos.
- Quando usar: ruídos de fundo, palavras interrompidas ou silêncio geram respostas indesejadas.
- Para que serve: evita respostas sem motivo e ajuda o modelo a pedir esclarecimentos de forma natural.
- Como adaptar: conforme o caso de uso, escolha entre pedir esclarecimentos e repetir a última pergunta.
Exemplo com tosse e áudio pouco claro
# Instruções/Regras
...


## Áudio pouco claro
- Se a fala estiver ininteligível, responda sempre no idioma que o usuário estiver falando.
- Responda apenas a áudio ou texto que esteja claro.
- Se o áudio do usuário não estiver claro (por exemplo, se for ambíguo, tiver ruído de fundo, estiver inteiramente em silêncio ou for ininteligível), ou se você não tiver ouvido ou entendido tudo, peça esclarecimentos usando frases em {preferred_language}.
Estas são as respostas obtidas depois de aplicar a instrução com gpt-realtime-1.5.
Neste exemplo, o modelo pede esclarecimentos depois de ouvir minha tosse (muito) alta e um trecho de áudio pouco claro.
Música ou sons de fundo
Às vezes, ao gerar fala, o modelo pode produzir música de fundo, cantarolar ou gerar ruídos rítmicos e outros artefatos sonoros indesejados. Esses sons podem prejudicar a clareza, distrair os usuários ou fazer o assistente parecer menos profissional. As instruções a seguir ajudam a evitar ou reduzir significativamente essas ocorrências.
- Quando usar: você percebe elementos musicais ou efeitos sonoros indesejados nas respostas em áudio do Realtime.
- Para que serve: orienta o modelo a evitar esses artefatos sonoros.
- Como adaptar: ajuste a instrução para tentar suprimir explicitamente os padrões sonoros específicos que você identificou.
Exemplo
# Instruções/Regras
...
- Não inclua efeitos sonoros nem onomatopeias nas respostas.
Ferramentas
Use esta seção para dizer ao modelo como usar suas funções e ferramentas. Especifique quando chamar ou deixar de chamar cada ferramenta, quais argumentos coletar, o que dizer durante a chamada e como lidar com erros ou resultados parciais.
Seleção de ferramentas
gpt-realtime-1.5 segue as instruções de perto. No entanto, se elas forem incompatíveis com os recursos aos quais o modelo tem acesso, as respostas poderão ser inadequadas. Isso acontece, por exemplo, quando o prompt menciona ferramentas que NÃO foram incluídas na lista de ferramentas.
- Quando usar: o prompt menciona ferramentas que não estão disponíveis.
- Para que serve: verifica se o prompt de sistema corresponde às ferramentas disponíveis.
Exemplo
# Ferramentas
## lookup_account(email_or_phone)
...


## check_outage(address)
...
Verifique se as mesmas ferramentas estão disponíveis e se as descrições não se contradizem:
[
{
"name": "lookup_account",
"description": "Consulte a conta do cliente por e-mail ou telefone para permitir a verificação e as ações específicas da conta.",
"parameters": {
...
},
{
"name": "check_outage",
"description": "Verifique se há interrupções de rede que afetem o endereço de instalação informado e retorne a situação e a previsão de normalização, se aplicável.",
"parameters": {
...
}
]Preâmbulos de chamadas de ferramentas
Em alguns casos, vale a pena fazer o modelo Realtime emitir uma resposta em áudio ao mesmo tempo que chama uma ferramenta. Isso melhora a experiência do usuário ao tornar a latência menos perceptível. Adapte a frase de exemplo ao seu caso de uso.
- Quando usar: o usuário precisa de uma confirmação imediata no momento da chamada da ferramenta, o que ajuda a disfarçar a latência.
- Para que serve: acrescenta um preâmbulo curto e consistente antes da chamada.
Exemplo
# Ferramentas
- Antes de qualquer chamada de ferramenta, diga uma frase curta, como "Vou verificar isso agora". Em seguida, chame a ferramenta imediatamente.
Estas são as respostas de gpt-realtime-1.5 após a aplicação da instrução.
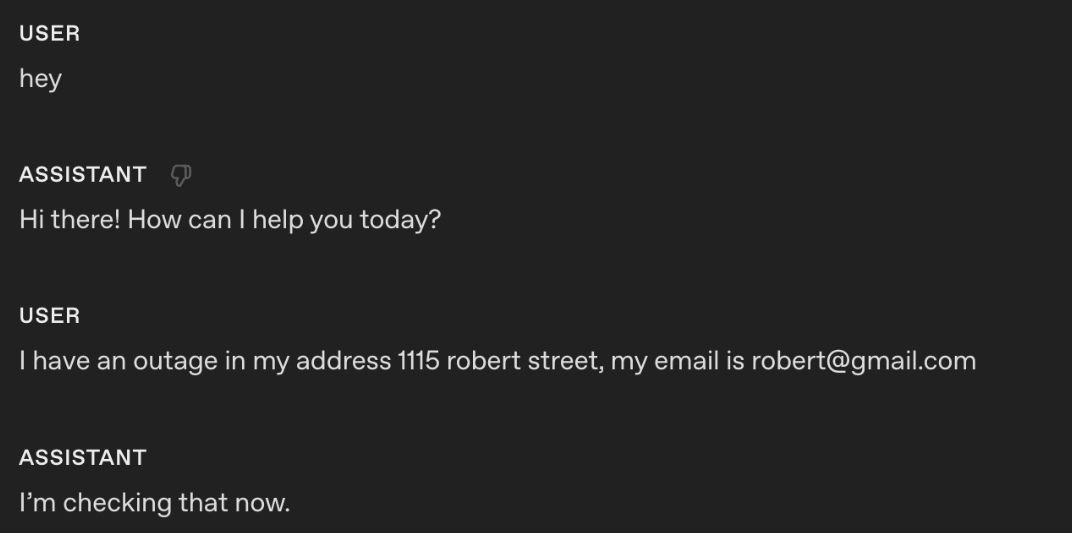
Com essa instrução, o modelo diz “I’m checking that right now” ao mesmo tempo que chama a ferramenta.
Preâmbulos de chamadas de ferramentas com frases de exemplo
Para controlar melhor o tipo de frase que o modelo diz ao chamar uma ferramenta, inclua frases de exemplo na descrição da ferramenta.
Exemplo
tools = [
{
"type": "function",
"name": "lookup_account",
"description": """Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.
Preamble sample phrases:
- For security, I’ll pull up your account using the email on file.
- Let me look up your account by {email} now.
- I’m fetching the account linked to {phone} to verify access.
- One moment—I’m opening your account details.""",
"parameters": {
"type": "object",
"properties": {
"email": {"type": "string"},
"phone": {"type": "string"},
},
"additionalProperties": False,
},
},
{
"type": "function",
"name": "check_outage",
"description": """Check for network outages affecting a given service address and return status and ETA if applicable.
Preamble sample phrases:
- I’ll check for any outages at {service_address} right now.
- Let me look up network status for your area.
- I’m checking whether there’s an active outage impacting your address.
- One sec—verifying service status and any posted ETA.""",
"parameters": {
"type": "object",
"properties": {
"service_address": {"type": "string"},
},
"required": ["service_address"],
"additionalProperties": False,
},
},
]Chamadas de ferramentas sem confirmação
Às vezes, o modelo pede confirmação antes de chamar uma ferramenta. Em alguns casos, essa falta de iniciativa prejudica a experiência do usuário final.
- Quando usar: o agente pede permissão mesmo quando a necessidade de chamar a ferramenta é óbvia.
- Para que serve: elimina pedidos repetidos e desnecessários de confirmação.
Exemplo
# Ferramentas
- Ao chamar uma ferramenta, não peça confirmação ao usuário. Tome a iniciativa.
Estas são as respostas obtidas depois de aplicar a instrução com gpt-realtime-1.5.
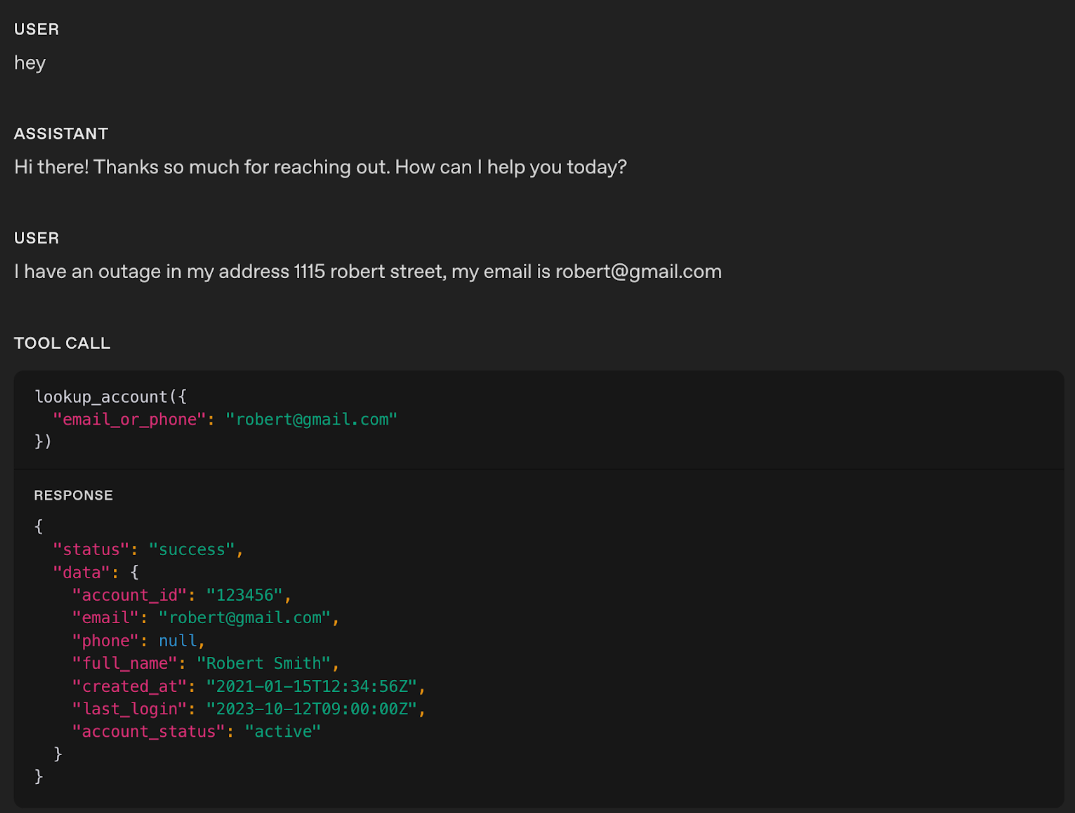
No exemplo, o modelo Realtime chama diretamente a ferramenta correspondente, sem emitir uma resposta em áudio.
Dica: se o modelo se precipitar ao chamar ferramentas, experimente suavizar a redação. Por exemplo, substituir termos fortes como “proativo” por uma expressão mais moderada pode ajudar o modelo a agir com mais calma e menos pressa.
Desempenho das chamadas de ferramentas
À medida que os casos de uso ficam mais complexos e o número de ferramentas disponíveis aumenta, é fundamental orientar explicitamente o modelo sobre quando usar cada ferramenta e, com a mesma clareza, quando evitar seu uso. Regras claras aumentam a precisão das chamadas e ajudam o modelo a escolher a ferramenta certa no momento adequado.
- Quando usar: o modelo tem dificuldade com as chamadas e precisa de instruções explícitas para reduzir o uso incorreto de ferramentas.
- Para que serve: especifica quando usar ou evitar cada ferramenta. Você também pode indicar sequências de chamadas, por exemplo, que depois de chamar a ferramenta A é possível chamar B ou C.
Exemplo
# Ferramentas
- Ao chamar qualquer ferramenta, emita ao mesmo tempo uma resposta avisando o usuário de que você está chamando a ferramenta.

## lookup_account(email_or_phone)
Use para verificar a identidade ou consultar os indicadores de plano ou interrupção.
NÃO use quando o usuário for claramente anônimo e fizer apenas perguntas gerais.


## check_outage(address)
Use quando o usuário relatar problemas de conexão ou lentidão.
NÃO use quando a pergunta for apenas sobre cobrança.


## refund_credit(account_id, minutes)
Use quando houver uma interrupção confirmada de mais de 240 minutos nos últimos 7 dias.
NÃO use se a interrupção não estiver confirmada. Siga primeiro para Diagnóstico → check_outage.


## schedule_technician(account_id, window)
Use quando ocorrerem falhas repetidas após a reinicialização e o indicador de interrupção for false.
NÃO use se o indicador de interrupção for true (nesse caso, envie a situação e a previsão de normalização).


## escalate_to_human(account_id, reason)
Use se o usuário parecer muito frustrado, houver abuso ou assédio, falhas repetidas ou contestação de cobrança acima de US$ 50, ou se o usuário pedir o encaminhamento.
Dica: se uma chamada puder falhar de maneira imprevisível, inclua instruções claras sobre como lidar com a falha para que o modelo dê uma resposta adequada.
Comportamento por ferramenta
Você pode ajustar o comportamento do modelo para cada ferramenta, em vez de aplicar uma única regra geral. Por exemplo, pode permitir que o modelo chame ferramentas de LEITURA por iniciativa própria e exigir confirmação explícita para ferramentas de ESCRITA.
- Quando usar: as instruções gerais sobre iniciativa, confirmação ou preâmbulos não servem para todas as ferramentas.
- Para que serve: acrescenta regras específicas para definir se o modelo deve chamar cada ferramenta imediatamente, pedir confirmação primeiro ou falar um preâmbulo antes da chamada.
Exemplo
# FERRAMENTAS
- Para ferramentas marcadas como PROACTIVE: não peça confirmação ao usuário nem diga um preâmbulo.
- Para ferramentas marcadas como CONFIRMATION FIRST: sempre peça confirmação ao usuário.
- Para ferramentas marcadas como PREAMBLES: antes de qualquer chamada, diga uma frase curta, como "Vou verificar isso agora". Em seguida, chame a ferramenta imediatamente.


## lookup_account(email_or_phone) — PROACTIVE
Use para verificar a identidade ou acessar os dados de cobrança.
NÃO use se a pessoa se recusar a se identificar após o segundo pedido.


## check_outage(address) — PREAMBLES
Use quando a pessoa relatar falha na conexão ou velocidade inferior a 10 Mbps.
NÃO use se o assunto for apenas cobrança OU se a velocidade da internet for superior a 10 Mbps.
Se qualquer uma dessas duas condições se aplicar, informe ao cliente que você não pode ajudar e encerre a ligação.


## refund_credit(account_id, minutes) — CONFIRMATION FIRST
Use quando houver uma interrupção confirmada de mais de 240 minutos nos últimos 7 dias (conceda um crédito de 60 minutos).
NÃO use se a interrupção não estiver confirmada.
Frase de confirmação: "Posso conceder um crédito por essa interrupção. Você quer que eu faça isso?"


## schedule_technician(account_id, window) — CONFIRMATION FIRST
Use quando a reinicialização e a verificação da linha falharem E outage=false.
Horários disponíveis: "10am–12pm ET" ou "2pm–4pm ET".
Frase de confirmação: "Posso agendar uma visita técnica. Quer que eu faça o agendamento?"


## escalate_to_human(account_id, reason) — PREAMBLES
Use em casos de assédio, ameaças, autolesão, falhas repetidas, contestação de cobrança acima de US$ 50, frustração da pessoa que ligou ou pedido de encaminhamento.
Preâmbulo: "Vou transferir você para um atendente mais experiente que pode continuar ajudando."
Formatação da saída das ferramentas
Algumas saídas de ferramentas, especialmente strings longas que precisam ser repetidas literalmente, podem diferir dos exemplos que o modelo viu no treinamento. Durante o treinamento, essas saídas costumam ter a forma de objetos JSON com campos nomeados. Se a ferramenta retornar uma string bruta e pedir separadamente ao modelo que a “repita exatamente”, ele poderá ter mais tendência a parafrasear, cortar o texto ou acrescentar um preâmbulo próprio.
Uma solução prática é dar à saída o formato habitual de um resultado de ferramenta e explicitar, em um campo que a máquina possa interpretar, a exigência de reprodução literal.
-
Quando usar: uma ferramenta retorna conteúdo estruturado longo ou complexo (instruções com várias frases, dados para transferência de atendimento, IDs e links, resumos de políticas, procedimentos com várias etapas etc.) e você observa trechos cortados, paráfrases, campos omitidos ou reordenados, ou a inclusão de preâmbulos ou comentários do modelo.
-
Para que serve: envolve a saída da ferramenta em um objeto JSON pequeno e explícito (por exemplo,
response_textcom indicadores comorequire_repeat_verbatim,formatoucontent_type). Assim, o resultado se aproxima dos formatos vistos no treinamento e a maneira esperada de apresentá-lo fica clara para a máquina. -
Como adaptar: mantenha o schema mínimo e estável. Documente claramente o formato esperado da saída tanto nas instruções de uso das ferramentas quanto junto à definição da ferramenta. Por exemplo: “Se
require_repeat_verbatimfor verdadeiro, retorne exatamenteresponse_texte nada mais” ou “Apresenteresponse_textcomo recebido, sem acrescentar, omitir ou reordenar campos da saída da ferramenta”.
Exemplos
Exemplo de string bruta (mais sujeita a erros)
A ferramenta retorna:
I just sent you an email with the verification link. Please open it and click “Confirm”.Às vezes, o modelo:
-
Diz “Enviei um link de verificação para o seu e-mail…” (paráfrase).
-
Omite a última frase (truncamento).
-
Acrescenta um comentário (“Posso ajudar em mais alguma coisa?”).
Exemplo com um objeto JSON (mais próximo dos dados de treinamento e mais confiável)
A ferramenta retorna:
{
"response_text": "I just sent you an email with the verification link. Please open it and click “Confirm”.",
"require_repeat_verbatim": true
}Como o formato se parece com um resultado típico de ferramenta (um objeto JSON), o modelo geralmente tem mais facilidade para:
-
reconhecer qual conteúdo deve servir de referência (response_text);
-
entender a exigência de reprodução literal (require_repeat_verbatim);
-
reproduzir a saída da ferramenta por inteiro, sem cortes nem comentários adicionais.
Reformule a resposta da ferramenta supervisora (arquitetura com modelos de resposta e de raciocínio)
Em muitos sistemas de voz, o modelo Realtime responde ao usuário em voz alta, enquanto um modelo de texto mais avançado fica responsável pelo raciocínio, como planejar, consultar políticas e executar procedimentos operacionais padrão. Uma resposta escrita nem sempre funciona bem quando lida em voz alta. Antes de gerar o áudio, o modelo de resposta precisa reformular o texto do modelo de raciocínio para que soe natural na fala.
- Quando usar: depois de receber o texto do modelo de raciocínio, o modelo de resposta produz uma fala mecânica, longa demais ou pouco natural.
- Para que serve: acrescenta instruções claras para que o modelo de resposta reformule o texto recebido em uma resposta curta, natural e pensada para ser falada.
- Como adaptar: ajuste o estilo das frases, as aberturas e os limites de tamanho às expectativas do seu caso de uso.
Exemplo
# Ferramentas
## Ferramenta supervisora
Nome: getNextResponseFromSupervisor(relevantContextFromLastUserMessage: string)


Quando chamar:
- Qualquer pedido fora da lista de permissões.
- Qualquer pergunta sobre fatos, políticas, contas ou processos.
- Qualquer ação que possa exigir consultas internas ou alterações no sistema.


Quando não chamar:
- Saudações simples e conversas casuais.
- Pedidos de repetição ou esclarecimento.
- Coleta de parâmetros para uso posterior pela ferramenta supervisora:
  - phone_number para ajuda com a conta (getUserAccountInfo)
  - zip_code para localizar lojas (findNearestStore)
  - topic ou keyword para consultar políticas (lookupPolicyDocument)


Regras de uso e preâmbulo:
1) Diga uma frase de espera neutra ao usuário e chame a ferramenta imediatamente. Frases aprovadas: "Um momento.", "Vou conferir.", "Só um segundo.", "Me dê um instante.", "Deixe eu ver.", "Vou verificar isso." A frase não deve sugerir sucesso nem falha.
2) Não mencione o "Supervisor" ao dizer a frase de espera.
3) relevantContextFromLastUserMessage é um resumo de uma linha da mensagem mais recente do usuário. Use uma string vazia se não houver nada relevante.
4) Quando a ferramenta retornar o resultado, siga as instruções de reformulação abaixo e envie sua resposta.


### Reformulação da resposta da ferramenta supervisora
- Comece com uma frase breve de conversa, usando a voz ativa, e passe à resposta. Por exemplo: "Agradeço por esperar.", "Acabei de conferir.", "Já estou com os dados aqui."
- Seja breve: use no máximo 2 frases.
- Siga esta estrutura: abertura + resumo em uma frase + até 3 detalhes importantes + uma confirmação ou escolha rápida (por exemplo: "Era o que você esperava?", "Quer que eu veja as opções?").
- Leia números de forma natural na fala: valores monetários ("$45.20" → "quarenta e cinco dólares e vinte centavos"), telefones em grupos de 3-3-4 dígitos, endereços com os dígitos separados e datas e horários por extenso ("doze de agosto", "três e meia da tarde").
Exemplo sem a instrução de reformulação:
Assistente: O saldo atual do seu cartão de crédito é positivo em 32.323.232 AUD.
O mesmo exemplo com a instrução de reformulação:
Assistente: Acabei de conferir. Você tem um saldo de trinta e dois milhões, trezentos e vinte e três mil, duzentos e trinta e dois dólares a seu favor no cartão de crédito. Seu último pagamento foi processado em primeiro de agosto. Era o que você esperava?
Ferramentas comuns
gpt-realtime-1.5 foi treinado para usar as ferramentas comuns a seguir de forma eficaz. Se o seu caso de uso exigir um comportamento semelhante, mantenha os nomes, as assinaturas e as descrições próximos aos dos exemplos. Isso aumenta a confiabilidade e aproxima suas ferramentas dos padrões vistos no treinamento.
Estas são algumas das principais ferramentas comuns usadas no treinamento do modelo:
Exemplo
# answer(question: string)
Descrição: chame esta ferramenta quando o cliente fizer uma pergunta que você não sabe responder ou pedir que você execute uma ação.


# escalate_to_human()
Descrição: chame esta ferramenta quando o cliente pedir encaminhamento, pedir para falar com outra pessoa ou demonstrar insatisfação com a ligação.


# finish_session()
Descrição: chame esta ferramenta quando o cliente disser que terminou o atendimento ou não quiser continuar. Em caso de dúvida, confirme com o cliente antes da chamada.
Fluxo da conversa
Esta seção mostra como organizar o diálogo em fases com objetivos claros para que o modelo saiba exatamente o que fazer em cada etapa. Para cada fase, defina a finalidade, as instruções para conduzi-la e os critérios concretos de saída que permitem avançar para a próxima. Isso evita que o modelo fique preso, pule etapas ou se antecipe e mantém a conversa organizada desde a saudação até a resolução.
Dividir o prompt em estados da conversa também facilita identificar os tipos de erro e fazer ajustes mais eficazes.
- Quando usar: as conversas parecem desorganizadas, param antes de atingir o objetivo ou o modelo tem dificuldade para concluir a tarefa.
- Para que serve: divide a interação em fases com objetivos, instruções e critérios de saída claros.
- Como adaptar: dê às fases nomes adequados ao seu fluxo de trabalho e ajuste as instruções de cada uma ao comportamento desejado. Defina de forma concreta e sucinta quando avançar.
Exemplo
# Fluxo da conversa
## 1) Saudação
Objetivo: definir o tom e perguntar o motivo da ligação.
Como responder:
- Apresente-se como o suporte da NorthLoop Internet.
- Seja breve na abertura e pergunte em que pode ajudar.
- Confirme que a pessoa é cliente da NorthLoop.
Avance para a identificação do problema quando a pessoa disser que é cliente da NorthLoop e mencionar um objetivo inicial ou sintoma.


## 2) Identificação do problema
Objetivo: classificar o problema e coletar os dados mínimos.
Como responder:
- Faça uma pergunta específica para distinguir problemas de cobrança de problemas de conexão.
- Para problemas de conexão, peça o endereço de instalação.
- Para cobrança ou conta, peça o e-mail ou telefone cadastrado.
Avance quando souber a intenção e tiver o endereço (para conexão) ou o e-mail ou telefone (para cobrança).


## 3) Verificação
Objetivo: confirmar a identidade e localizar a conta.
Como responder:
- Assim que tiver o e-mail ou telefone, chame lookup_account(email_or_phone).
- Se a consulta falhar, tente o outro identificador uma vez. Se ainda assim não localizar a conta, dê orientações gerais ou ofereça encaminhamento caso seja preciso agir na conta.
Avance quando a consulta retornar o ID da conta.


## 4) Diagnóstico
Objetivo: determinar se há interrupção do serviço ou um problema local.
Como responder:
- Para problemas de conexão, chame check_outage(address).
- Se outage=true, pule as verificações locais e avance para a resolução com os dados da interrupção.
- Se outage=false, oriente uma reinicialização e uma verificação rápida dos cabos. Confirme o resultado de cada etapa antes de continuar.
Avance quando identificar a causa do problema.


## 5) Resolução
Objetivo: corrigir o problema, conceder um crédito ou agendar uma visita.
Como responder:
- Se houver uma interrupção confirmada de mais de 240 minutos nos últimos 7 dias, chame refund_credit(account_id, 60).
- Se outage=false e o problema persistir após as verificações básicas, ofereça "10am–12pm ET" ou "2pm–4pm ET" e chame schedule_technician(account_id, chosen window).
- Se a correção local funcionar, informe brevemente o resultado e os próximos passos.
Avance quando a correção, o crédito ou o agendamento tiver sido efetivado e a pessoa confirmar que está ciente.


## 6) Confirmação e encerramento
Objetivo: confirmar o resultado e concluir o atendimento.
Como responder:
- Repita o resultado e indique qualquer próximo passo, como o prazo para estabilização ou a previsão de chegada do técnico.
- Pergunte se ainda há dúvidas. Se não houver, encerre com educação.
Encerre quando a pessoa disser que não precisa de mais ajuda.
Frases de exemplo
As frases de exemplo servem de referência para o modelo. Elas mostram o estilo, a concisão e o tom desejados sem prender o modelo a uma única resposta fixa.
- Quando usar: as respostas não refletem o estilo da marca ou são inconsistentes.
- Para que serve: fornece exemplos que o modelo pode variar para manter a fala natural e breve.
- Como adaptar: substitua os exemplos por frases adequadas à marca e mantenha o aviso de que elas não devem ser usadas sempre.
Exemplo
# Frases de exemplo
- Use os exemplos abaixo como inspiração. NÃO USE SEMPRE OS MESMOS EXEMPLOS. VARIE AS RESPOSTAS.

Confirmações: "Vou cuidar disso." "Um momento." "Boa pergunta."
Esclarecimentos: "Você prefere A ou B?" "Qual é o prazo?"
Transições: "Vamos fazer o seguinte." "Vamos simplificar."
Empatia (breve): "Sei como isso é frustrante. Vamos resolver."
Encerramento: "Precisa de mais alguma coisa antes de encerrarmos?" "Sempre que precisar, estamos à disposição."
Observação: se o sistema de voz passar a repetir apenas as frases de exemplo e a fala ficar mecânica, experimente acrescentar a regra de variedade. Já observamos casos em que isso resolveu o problema.
Fluxo da conversa com frases de exemplo
Incluir frases de exemplo nos diferentes estados do fluxo da conversa ajuda a mostrar ao modelo o que constitui uma boa resposta em cada etapa:
Exemplo
# Fluxo da conversa
## 1) Saudação
Objetivo: definir o tom e perguntar o motivo da ligação.
Como responder:
- Apresente-se como o suporte da NorthLoop Internet.
- Seja breve na abertura e pergunte em que pode ajudar.
Frases de exemplo (não repita sempre as mesmas frases, varie as respostas):
- "Agradecemos por ligar para a NorthLoop Internet. Como posso ajudar hoje?"
- "Você ligou para o suporte da NorthLoop. O que está acontecendo com o serviço?"
- "Olá! Me conte em que posso ajudar."
Avance quando a pessoa mencionar um objetivo inicial ou sintoma.


## 2) Identificação do problema
Objetivo: classificar o problema e coletar os dados mínimos.
Como responder:
- Faça uma pergunta específica para distinguir problemas de cobrança de problemas de conexão.
- Para problemas de conexão, peça o endereço de instalação.
- Para cobrança ou conta, peça o e-mail ou telefone cadastrado.
Frases de exemplo (não repita sempre as mesmas frases, varie as respostas):
- "É sobre a fatura ou a velocidade da internet?"
- "Em qual endereço você usa essa conexão?"
- "Qual é o e-mail ou telefone cadastrado na conta?"
Avance quando souber a intenção e tiver o endereço (para conexão) ou o e-mail ou telefone (para cobrança).


## 3) Verificação
Objetivo: confirmar a identidade e localizar a conta.
Como responder:
- Assim que tiver o e-mail ou telefone, chame lookup_account(email_or_phone).
- Se a consulta falhar, tente o outro identificador uma vez. Se ainda assim não localizar a conta, dê orientações gerais ou ofereça encaminhamento caso seja preciso agir na conta.
Frases de exemplo:
- "Agradeço. Vou consultar sua conta agora."
- "Se eu não encontrar a conta com esse dado, pode me informar o outro contato, e-mail ou telefone?"
- "Encontrei sua conta. Vou cuidar disso."
Avance quando a consulta retornar o ID da conta.


## 4) Diagnóstico
Objetivo: determinar se há interrupção do serviço ou um problema local.
Como responder:
- Para problemas de conexão, chame check_outage(address).
- Se outage=true, pule as verificações locais e avance para a resolução com os dados da interrupção.
- Se outage=false, oriente uma reinicialização e uma verificação rápida dos cabos. Confirme o resultado de cada etapa antes de continuar.
Frases de exemplo (não repita sempre as mesmas frases, varie as respostas):
- "Vou conferir se há alguma interrupção na sua região."
- "Não há registro de interrupção. Vamos tentar reiniciar o modem."
- "Pode conferir as luzes do modem? A luz da internet está acesa direto ou está piscando?"
Avance quando identificar a causa do problema.


## 5) Resolução
Objetivo: corrigir o problema, conceder um crédito ou agendar uma visita.
Como responder:
- Se houver uma interrupção confirmada de mais de 240 minutos nos últimos 7 dias, chame refund_credit(account_id, 60).
- Se outage=false e o problema persistir após as verificações básicas, ofereça "10am–12pm ET" ou "2pm–4pm ET" e chame schedule_technician(account_id, chosen window).
- Se a correção local funcionar, informe brevemente o resultado e os próximos passos.
Frases de exemplo (não repita sempre as mesmas frases, varie as respostas):
- "O serviço ficou interrompido por um período prolongado. Vou aplicar agora um crédito de 60 minutos na sua fatura."
- "Não há interrupção. Vamos agendar uma visita técnica. Tenho horários das 10h às 12h ou das 14h às 16h, no horário do leste dos EUA."
- "O crédito foi aplicado e vai aparecer na sua próxima fatura."
Avance quando a correção, o crédito ou o agendamento tiver sido efetivado e a pessoa confirmar que está ciente.


## 6) Confirmação e encerramento
Objetivo: confirmar o resultado e concluir o atendimento.
Como responder:
- Repita o resultado e indique qualquer próximo passo, como o prazo para estabilização ou a previsão de chegada do técnico.
- Pergunte se ainda há dúvidas. Se não houver, encerre com educação.
Frases de exemplo (não repita sempre as mesmas frases, varie as respostas):
- "Tudo certo: [credit applied / appointment booked / service restored]."
- "A velocidade deve se estabilizar em alguns minutos."
- "A visita técnica está agendada para o período das 10h às 12h, no horário do leste dos EUA."
Encerre quando a pessoa disser que não precisa de mais ajuda.
Fluxos de conversa avançados
À medida que os casos de uso ficam mais complexos, você precisa de uma estrutura que possa crescer sem prejudicar o desempenho do modelo. Equilibre a facilidade de manutenção com a simplicidade. Estados rígidos em excesso podem sobrecarregar o modelo, reduzir o desempenho e tornar as conversas mecânicas.
Uma abordagem melhor é criar fluxos que simplifiquem a tarefa para o modelo. Ao gerenciar o estado de maneira estruturada e flexível, você ajuda o modelo a manter o foco e responder prontamente, o que melhora a experiência do usuário.
Dois padrões comuns para gerenciar cenários complexos são:
- Fluxo da conversa como máquina de estados
- Fluxo dinâmico da conversa via session.updates
Fluxo da conversa como máquina de estados
Defina a conversa em uma estrutura JSON que represente tanto os estados quanto as transições. Assim fica mais fácil verificar quais situações o fluxo cobre, identificar casos extremos e acompanhar as mudanças ao longo do tempo. Como a estrutura é armazenada em código, você pode controlar versões, comparar alterações e expandi-la à medida que o fluxo evolui. Uma máquina de estados também oferece controle detalhado sobre como e quando a conversa passa de um estado para outro.
Exemplo
# Estados da conversa
[
{
"id": "1_greeting",
"description": "Comece cada conversa com uma saudação cordial e simpática. Identifique o serviço e ofereça ajuda.",
"instructions": [
"Use o nome da empresa, 'Snowy Peak Boards', e dê as boas-vindas com cordialidade.",
"Avise desde o início que, para prestar atendimento específico sobre a conta, você precisará de alguns dados de verificação."
],
"examples": [
"Olá, você está falando com a Snowy Peak Boards. Agradecemos o contato! Como posso ajudar hoje?"
],
"transitions": [{
"next_step": "2_get_first_name",
"condition": "Assim que terminar a saudação."
}, {
"next_step": "3_get_and_verify_phone",
"condition": "Se o usuário informar o primeiro nome."
}]
},
{
"id": "2_get_first_name",
"description": "Peça o nome do usuário (apenas o primeiro nome).",
"instructions": [
"Pergunte com educação: 'Com quem eu tenho o prazer de falar?'",
"NÃO verifique o nome nem o soletre de volta. Apenas aceite o nome informado."
],
"examples": [
"Com quem eu tenho o prazer de falar?"
],
"transitions": [{
"next_step": "3_get_and_verify_phone",
"condition": "Quando obtiver o nome OU se o usuário já o tiver informado."
}]
},
{
"id": "3_get_and_verify_phone",
"description": "Peça o número de telefone e confira-o repetindo o número para o usuário.",
"instructions": [
"Peça com educação o telefone do usuário.",
"Depois que ele informar o número, repita cada dígito e pergunte se está correto.",
"Se o usuário fizer uma correção, confirme NOVAMENTE para ter certeza de que entendeu.",
],
"examples": [
"Se estiver tudo bem, preciso de mais alguns dados para acessar sua conta. Pode me informar seu telefone, por favor?",
"Você disse 0-2-1-5-5-5-1-2-3-4, certo?",
"Você disse 4-5-6-7-8-9-0-1-2-3, certo?"
],
"transitions": [{
"next_step": "4_authentication_DOB",
"condition": "Quando o número de telefone estiver confirmado"
}]
},
...Fluxo dinâmico da conversa
Nesse padrão, a conversa se adapta em tempo real com a atualização do prompt de sistema e da lista de ferramentas conforme o estado atual. Em vez de apresentar ao modelo todas as regras e ferramentas possíveis de uma vez, forneça apenas o que for relevante para a fase atual da conversa.
Quando as condições de saída de um estado forem atendidas, use session.update para fazer a transição e substituir o prompt e as ferramentas pelos necessários na próxima fase.
Essa abordagem reduz a carga cognitiva do modelo e facilita a execução de tarefas complexas sem a distração de informações desnecessárias.
Exemplo
from typing import Literal
State = Literal["verify", "resolve"]
# Allowed transitions
TRANSITIONS: dict[State, list[State]] = {
"verify": ["resolve"],
"resolve": [], # terminal
}
def build_state_change_tool(current: State) -> dict:
allowed = TRANSITIONS[current]
readable = ", ".join(allowed) if allowed else "no further states (terminal)"
return {
"type": "function",
"name": "set_conversation_state",
"description": (
f"Switch the conversation phase. Current: '{current}'. "
f"You may switch only to: {readable}. "
"Call this AFTER exit criteria are satisfied."
),
"parameters": {
"type": "object",
"properties": {"next_state": {"type": "string", "enum": allowed}},
"required": ["next_state"],
},
}
# Minimal business tools per state
TOOLS_BY_STATE: dict[State, list[dict]] = {
"verify": [
{
"type": "function",
"name": "lookup_account",
"description": "Fetch account by email or phone.",
"parameters": {
"type": "object",
"properties": {"email_or_phone": {"type": "string"}},
"required": ["email_or_phone"],
},
}
],
"resolve": [
{
"type": "function",
"name": "schedule_technician",
"description": "Book a technician visit.",
"parameters": {
"type": "object",
"properties": {
"account_id": {"type": "string"},
"window": {"type": "string", "enum": ["10-12 ET", "14-16 ET"]},
},
"required": ["account_id", "window"],
},
}
],
}
# Short, phase-specific instructions
INSTRUCTIONS_BY_STATE: dict[State, str] = {
"verify": (
"# Role & Objective\n"
"Verify identity to access the account.\n\n"
"# Conversation (Verify)\n"
"- Ask for the email or phone on the account.\n"
"- Read back digits one-by-one (e.g., '4-1-5… Is that correct?').\n"
"Exit when: Account ID is returned.\n"
'When exit is satisfied: call set_conversation_state(next_state="resolve").'
),
"resolve": (
"# Role & Objective\n"
"Apply a fix by booking a technician.\n\n"
"# Conversation (Resolve)\n"
"- Offer two windows: '10–12 ET' or '2–4 ET'.\n"
"- Book the chosen window.\n"
"Exit when: Appointment is confirmed.\n"
"When exit is satisfied: end the call politely."
),
}
def build_session_update(state: State) -> dict:
"""Return the JSON payload for a Realtime `session.update` event."""
return {
"type": "session.update",
"session": {
"type": "realtime",
"instructions": INSTRUCTIONS_BY_STATE[state],
"tools": TOOLS_BY_STATE[state] + [build_state_change_tool(state)],
},
}Segurança e encaminhamento
Para agentes de voz Realtime, muitas vezes é importante ter uma maneira confiável de encaminhar o atendimento a uma pessoa. Nesta seção, adapte ao seu caso de uso as instruções que definem QUANDO encaminhar.
- Quando usar: o modelo tem dificuldade para identificar o momento adequado de encaminhar o atendimento a uma pessoa ou acionar um sistema alternativo.
- Para que serve: define como encaminhar o atendimento com rapidez e confiabilidade e o que dizer ao usuário.
- Como adaptar: defina os limites que justificam o encaminhamento e o que o modelo deve dizer.
Exemplo
# Segurança e encaminhamento
Quando encaminhar o atendimento (sem outras tentativas de resolver o problema):
- Risco à segurança (autolesão, ameaças, assédio)
- Pedido explícito do usuário para falar com uma pessoa
- Insatisfação intensa (por exemplo, dizer que está "extremamente frustrado", repetir reclamações ou usar palavrões)
- **2** tentativas de usar ferramentas sem sucesso na mesma tarefa **ou** **3** ocorrências consecutivas em que não há correspondência ou não há entrada do usuário
- Pedido fora do escopo ou sujeito a restrições (por exemplo, notícias em tempo real ou aconselhamento financeiro, jurídico ou médico)

O que dizer ao chamar a ferramenta escalate_to_human (OBRIGATÓRIO):
- "Agradeço pela paciência. Vou transferir você agora para um especialista."
- Em seguida, chame a ferramenta: `escalate_to_human`

Exemplos que exigem encaminhamento:
- "Já é a terceira vez que a redefinição não funciona. Só quero falar com uma pessoa."
- "Estou extremamente frustrado!"
O primeiro exemplo mostra as respostas de gpt-4o-realtime-preview-2025-06-03 em uma conversa com essa instrução.
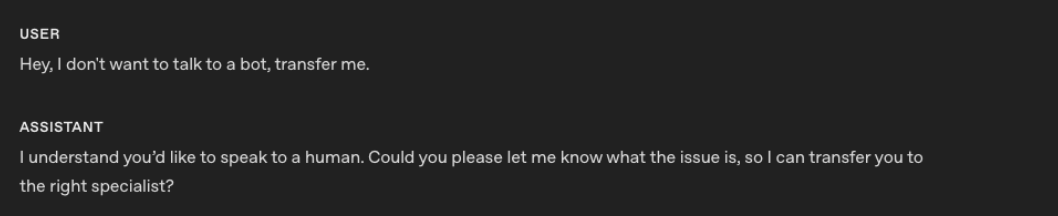
O segundo exemplo mostra as respostas de gpt-realtime-1.5 em uma conversa com a mesma instrução.
gpt-realtime-1.5 consegue seguir a instrução e encaminhar o atendimento a uma pessoa com mais confiabilidade.
Próximos passos
Para o GPT-Live:
- Consulte o guia de delegação e ferramentas para saber como trabalhar com o prompt do backend e o contexto gerenciado pelo aplicativo.
- Conecte-se via WebRTC ou WebSockets. Para integrações telefônicas, consulte Telefonia e SIP.
- Avalie os agentes de voz considerando a qualidade da conversa e os resultados verificados das tarefas.
Para o Realtime:
- Consulte o guia anterior de prompts para Realtime para ver mais exemplos com
gpt-realtime-1.5. - Consulte o guia de avaliação do Realtime para testar o comportamento do agente de voz em situações representativas.
- Conecte-se via WebRTC, WebSockets ou SIP.
- Conheça o ciclo de vida das conversas no Realtime e consulte os custos do Realtime.