
Os recursos de áudio com IA abrem novas possibilidades de interação para os usuários. No início deste ano, lançamos vários modelos de áudio, entre eles o gpt-realtime, além de novos recursos de API para que os desenvolvedores possam criar essas experiências.
Na semana passada, lançamos novas versões dos modelos de áudio para resolver alguns dos desafios mais comuns de quem desenvolve agentes de áudio confiáveis. Elas melhoram a confiabilidade e a qualidade dos fluxos de voz em produção, da transcrição e da síntese de voz aos agentes que operam nativamente de fala para fala em tempo real.
As atualizações incluem:
gpt-4o-mini-transcribe-2025-12-15para converter fala em texto com a API de transcrição ou a Realtime APIgpt-4o-mini-tts-2025-12-15para converter texto em fala com a API de síntese de vozgpt-realtime-mini-2025-12-15para interações nativas de fala para fala em tempo real com a Realtime APIgpt-audio-mini-2025-12-15para interações nativas de fala para fala com a API chat completions
As novas versões têm algumas melhorias em comum:
Na entrada de áudio:
- Taxas de erro de palavras mais baixas em gravações de situações reais e em áudios com ruído
- Menos alucinações em momentos de silêncio ou na presença de ruído de fundo
Na saída de áudio:
- Voz mais natural e estável, inclusive com vozes personalizadas
Os preços continuam os mesmos das versões anteriores. Recomendamos migrar para as novas versões para obter um desempenho melhor pelo mesmo preço.
Se você desenvolve agentes de voz, sistemas de atendimento ao cliente ou experiências de voz para marcas, essas atualizações vão ajudar a tornar suas implantações em produção mais confiáveis. A seguir, detalhamos as novidades e como essas melhorias se manifestam na prática.
Fala para fala
Estamos disponibilizando novos modelos Realtime mini e Audio mini, otimizados para chamar ferramentas e seguir instruções com mais precisão. Com isso, diminui a diferença de capacidade entre os modelos mini e os de tamanho completo, o que permite reduzir custos em alguns aplicativos ao migrar para o modelo mini.
gpt-realtime-mini-2025-12-15
O modelo gpt-realtime-mini foi projetado para uso com a Realtime API, nossa API para interações multimodais nativas de baixa latência. Ele permite transmitir áudio continuamente na entrada e na saída, lidar com interrupções (com detecção opcional de atividade de voz) e fazer chamadas de função em segundo plano enquanto continua falando.
A nova versão do Realtime mini é mais adequada para agentes em tempo real e apresenta ganhos claros ao seguir instruções e chamar ferramentas. Nas nossas avaliações internas de fala para fala, a precisão aumentou 18,6 pontos percentuais ao seguir instruções e 12,9 pontos percentuais ao chamar ferramentas, em comparação com a versão anterior. Também houve melhora no benchmark Big Bench Audio.
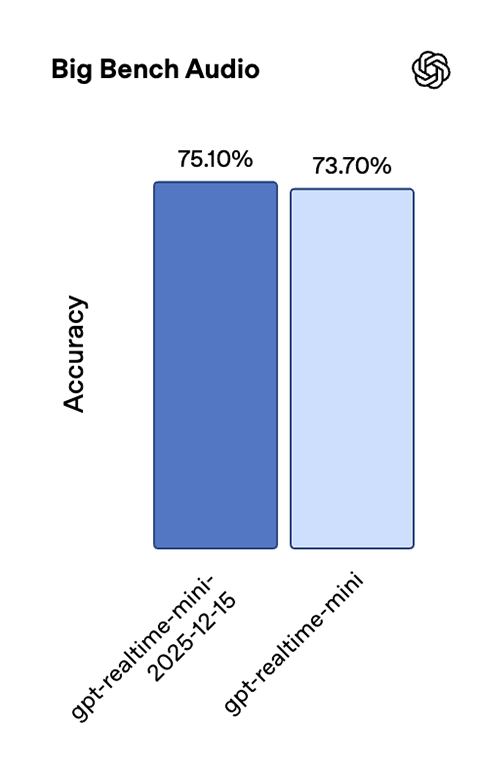
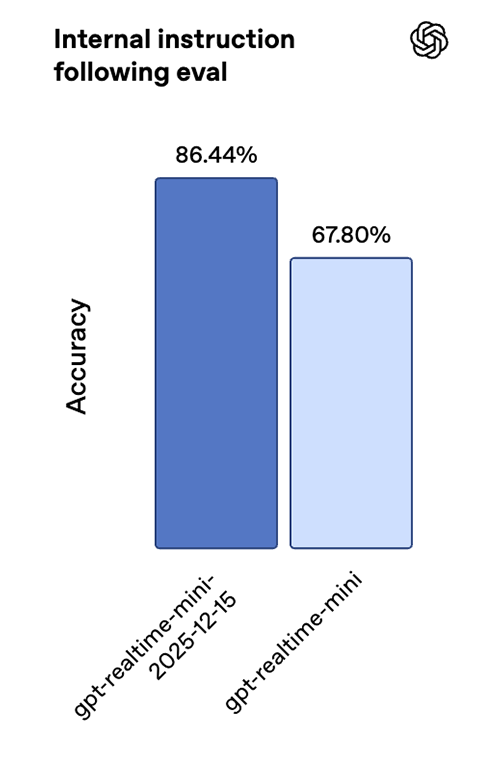
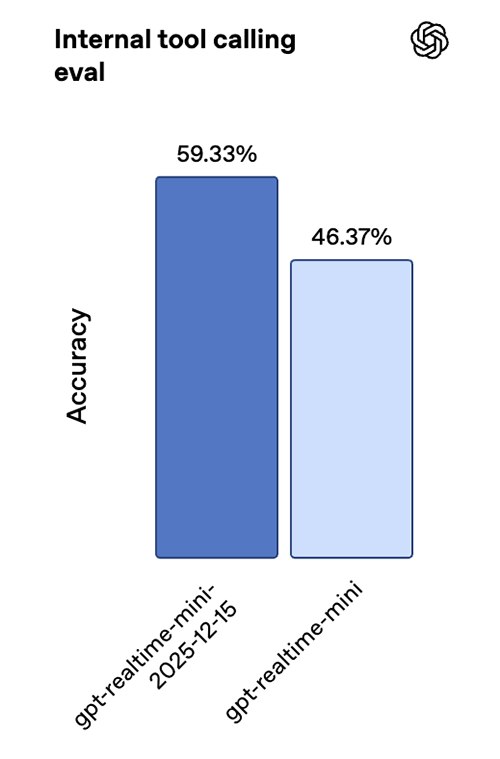
Com esses ganhos, as interações com várias etapas ficam mais confiáveis e as funções são executadas de maneira mais consistente em situações ao vivo que exigem baixa latência.
Quando a precisão do agente justifica um custo mais alto, o gpt-realtime continua sendo nosso modelo de melhor desempenho. Quando o custo e a latência são as prioridades, o gpt-realtime-mini é uma ótima opção e tem bom desempenho em situações reais.
A Genspark, por exemplo, submeteu o modelo a testes de estresse em tarefas de tradução bilíngue e de roteamento inteligente por intenção. Além da melhora na qualidade da voz, a equipe observou que as respostas eram quase instantâneas e que o modelo reconhecia corretamente a intenção mesmo quando os interlocutores alternavam rapidamente entre as falas.
gpt-audio-mini-2025-12-15
O modelo gpt-audio-mini pode ser usado com a API chat completions em aplicações de fala para fala que dispensam a interação em tempo real.
As duas novas versões também contam com um decodificador aprimorado que produz vozes mais naturais. Ao usar vozes personalizadas, ambas preservam melhor a consistência da voz.
Texto para fala
Nosso modelo mais recente de síntese de voz, o gpt-4o-mini-tts-2025-12-15, ganhou precisão de forma significativa. Nos principais benchmarks de fala, as taxas de erro de palavras ficaram bem abaixo das registradas pela geração anterior. No Common Voice e no FLEURS, a taxa de erro de palavras (WER) caiu cerca de 35%. Também observamos ganhos consistentes no Multilingual LibriSpeech.
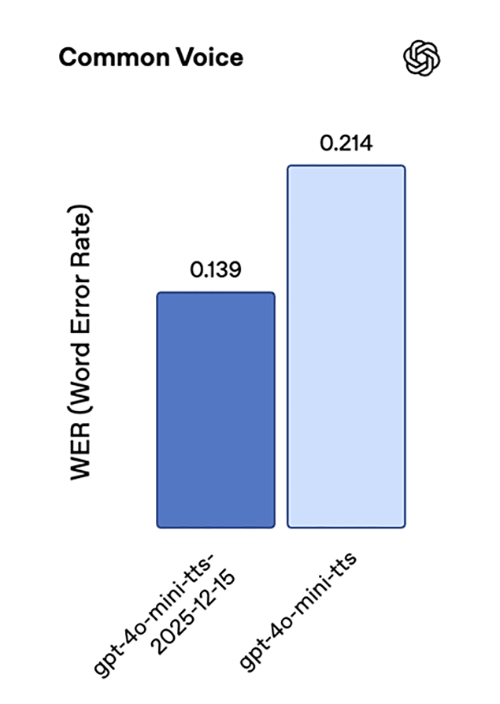
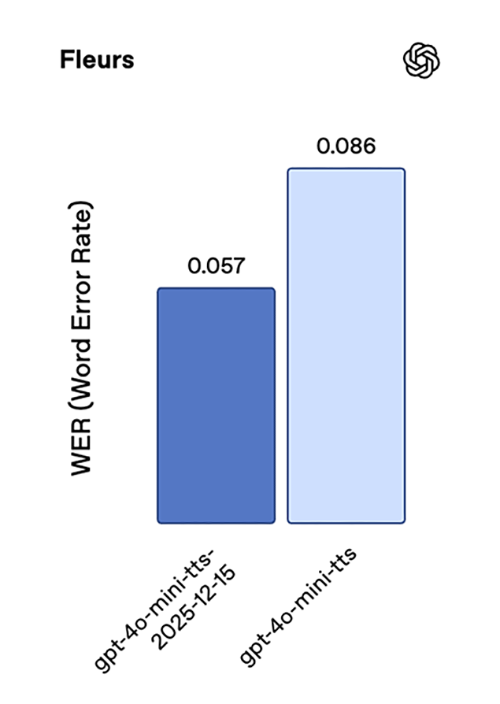
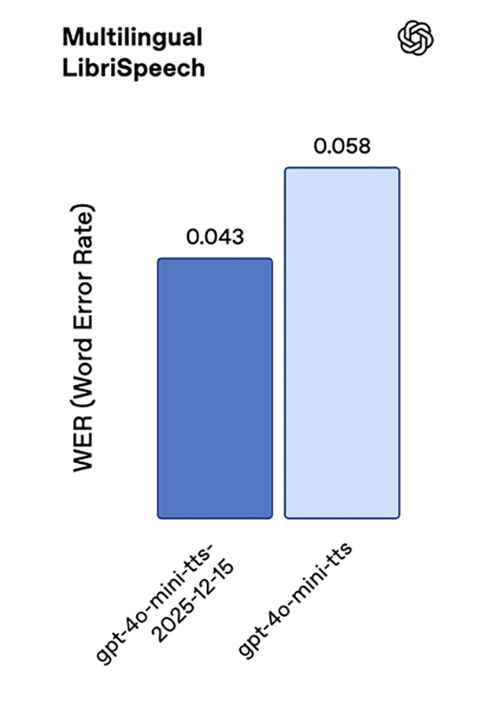
Em conjunto, esses resultados mostram que o modelo pronuncia as palavras com mais precisão e é mais robusto em uma ampla variedade de idiomas.
Assim como a nova versão do gpt-realtime-mini, este modelo produz uma fala muito mais natural e tem melhor desempenho com vozes personalizadas.
Fala para texto
Nosso modelo de transcrição mais recente, o gpt-4o-mini-transcribe-2025-12-15, apresenta ganhos expressivos tanto de precisão quanto de confiabilidade. Em benchmarks de referência de reconhecimento automático de fala (ASR), como Common Voice e FLEURS, ele registra taxas de erro de palavras menores que as dos modelos anteriores, sem receber indicação do idioma. Otimizamos o modelo para situações comuns em conversas reais, como falas curtas dos usuários e ambientes com ruído de fundo. Em uma avaliação interna de alucinações na presença de ruído, reproduzimos trechos de ruído de fundo gravados em situações reais e áudios com intervalos variados de fala, incluindo períodos de silêncio. O modelo produziu cerca de 90% menos alucinações que o Whisper v2 e cerca de 70% menos que os modelos GPT-4o-transcribe anteriores.
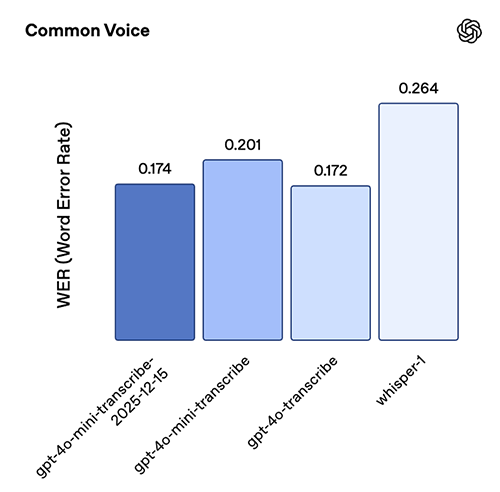
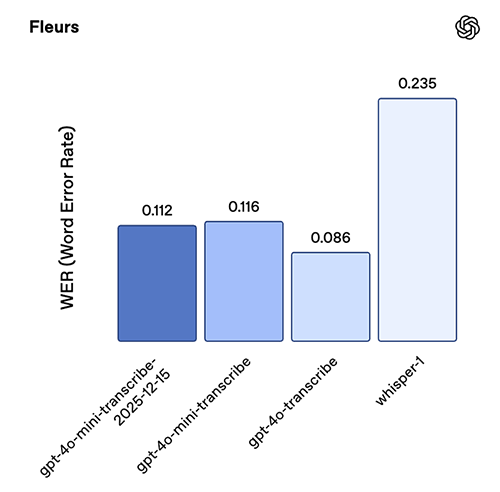
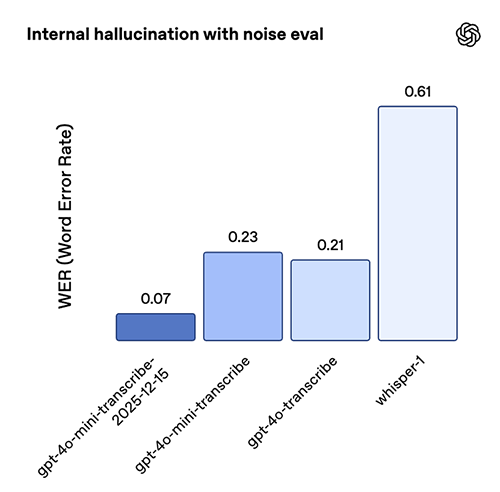
Esta versão do modelo se destaca em chinês (mandarim), hindi, bengali, japonês, indonésio e italiano.
Vozes personalizadas
Com as vozes personalizadas, as organizações podem falar com os clientes usando uma voz própria da marca. Seja para criar um agente de atendimento ao cliente ou um avatar da marca, a tecnologia de voz personalizada da OpenAI facilita a criação de vozes distintas e realistas.
Os novos modelos de fala para fala e de texto para fala trazem melhorias para as vozes personalizadas, com tons mais naturais, maior fidelidade à amostra original e mais precisão em diferentes dialetos.
Para garantir o uso seguro dessa tecnologia, as vozes personalizadas estão disponíveis apenas para clientes elegíveis. Para saber mais, fale com o diretor responsável pela sua conta ou entre em contato com nossa equipe de vendas.
Do protótipo à produção
Os aplicativos de voz tendem a falhar em situações semelhantes, principalmente em conversas longas, em casos extremos como períodos de silêncio e em fluxos que dependem de ferramentas e exigem precisão do agente de voz. As atualizações abordam essas falhas ao reduzir as taxas de erro e as alucinações, tornar o uso de ferramentas mais consistente e melhorar a capacidade de seguir instruções. Também melhoramos a estabilidade do áudio gerado para que a voz soe mais natural nos seus aplicativos.
Se você já disponibiliza experiências de voz aos usuários, recomendamos migrar para as novas versões de 2025-12-15 e executar novamente seus principais casos de teste de produção.
Quem testou os modelos antecipadamente observou melhorias perceptíveis só de mudar para as novas versões, sem alterar as instruções. Ainda assim, recomendamos testar seus próprios casos de uso e ajustar os prompts conforme necessário.