La API te permite generar y editar imágenes a partir de prompts de texto con gpt-image-2.5-sunburst y gpt-image-2.5-flare. Elige Sunburst para flujos de trabajo en los que la precisión al editar sea la prioridad, y Flare para generar imágenes de alta calidad con rapidez en el día a día. Puedes acceder a las funciones de generación de imágenes mediante dos API:
API de imágenes
La API de imágenes ofrece dos puntos de acceso con funciones distintas:
Generación: genera imágenes desde cero a partir de un prompt de texto.
La API de respuestas te permite generar imágenes como parte de una conversación o de un flujo de varios pasos. Ofrece la generación de imágenes como herramienta integrada y admite imágenes de entrada y de salida dentro del contexto.
Además de las funciones de la API de imágenes, ofrece las siguientes:
Edición en varios turnos: edita imágenes con alta fidelidad mediante prompts sucesivos.
Entradas flexibles: además de bytes, acepta identificadores de archivos de imagen como entradas.
Para saber qué modelos principales pueden llamar a la herramienta de generación de imágenes, consulta los modelos compatibles.
Elegir la API adecuada
Si solo necesitas generar o editar una imagen a partir de un único prompt, la API de imágenes es la mejor opción.
Si quieres crear experiencias conversacionales en las que se puedan editar imágenes con GPT Image, elige la API de respuestas.
Con la API de imágenes, establece model directamente en gpt-image-2.5-sunburst o gpt-image-2.5-flare. Con la API de respuestas, selecciona un modelo principal compatible en el nivel superior y especifica gpt-image-2.5-sunburst o gpt-image-2.5-flare en el campo model de la herramienta de generación de imágenes.
Ambas API te permiten personalizar la salida ajustando la calidad, el tamaño, el formato y la compresión.
GPT-Image-2.6 incluye Sunburst para trabajos visuales que requieren mucho detalle y Flare para probar variaciones rápidamente. Con ambos modelos, la API de imágenes te permite ajustar la complejidad, guiar la edición con anotaciones y generar archivos SVG o GIF animados. Los ejemplos que aparecen más adelante usan GPT-Image-2.5.
Ajustar la complejidad de la imagen
Usa el campo complexity de la solicitud para controlar cuánto planifica el modelo antes de renderizar la imagen. Un nivel bajo de complejidad puede ser adecuado para cambios puntuales, como modificar un fondo o un letrero. Un nivel más alto puede ayudar cuando hay mucho texto, la composición es compleja o importa la relación entre los objetos. Una mayor complejidad también puede aumentar la latencia e introducir cambios no deseados, así que compara los resultados para tu tarea.
Sunburst y Flare admiten los niveles de complejidad low, medium y high. Si omites complexity, ambos modelos usan high. El ajuste quality controla por separado la calidad del renderizado.
Ajustar la complejidad no tiene un cargo adicional.
Sunburst generó estas escenas de fútbol con estilo de papel recortado a partir del mismo prompt y con calidad media. Compara el trofeo, los uniformes y la ubicación del letrero “CHAMPIONS” en los distintos niveles de complejidad.
Complejidad baja
Complejidad media
Complejidad alta
Identificadores de seguridad
Si tu aplicación tiene usuarios finales individuales, incluye un identificador estable que proteja su privacidad en el campo safety_identifier de cada solicitud de generación de imágenes o de edición de imágenes. En lugar de enviar datos que identifiquen al usuario, calcula el hash de su nombre de usuario o dirección de correo electrónico. El identificador debe tener como máximo 128 caracteres. Se recomienda usar identificadores de seguridad, aunque son opcionales.
El parámetro user de la API de imágenes está obsoleto. Envía el mismo identificador en safety_identifier. Las solicitudes existentes que usan user siguen siendo compatibles. Si safety_identifier tiene un valor no vacío, tiene prioridad sobre user. Si omites safety_identifier, le asignas null o envías una cadena vacía, la API usa user cuando está disponible.
Para obtener más información sobre cómo personalizar el tamaño, la calidad, el formato y la compresión, consulta la sección Personalizar la imagen de salida más adelante.
Puedes configurar el parámetro n para generar varias imágenes a la vez en una sola solicitud. De forma predeterminada, la API devuelve una sola imagen.
API de imágenes
Generar una imagen
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";import fs from "fs";const openai = new OpenAI();const prompt = `A children's book drawing of a veterinarian using a stethoscope tolisten to the heartbeat of a baby otter.`;const result = await openai.images.generate({ model: "gpt-image-2.5-sunburst", prompt,});// Save the image to a fileconst image_base64 = result.data[0].b64_json;const image_bytes = Buffer.from(image_base64, "base64");fs.writeFileSync("otter.png", image_bytes);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18from openai import OpenAIimport base64client = OpenAI()prompt ="""A children's book drawing of a veterinarian using a stethoscope tolisten to the heartbeat of a baby otter."""result = client.images.generate(model="gpt-image-2.5-sunburst", prompt=prompt)image_base64 = result.data[0].b64_jsonimage_bytes = base64.b64decode(image_base64)# Save the image to a filewithopen("otter.png", "wb") as f: f.write(image_bytes)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "encoding/base64" "os" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() result, err := client.Images.Generate(context.Background(), openai.ImageGenerateParams{ Model: openai.ImageModel("gpt-image-2.5-sunburst"), Prompt: "A children's book drawing of a veterinarian using a stethoscope to " + "listen to the heartbeat of a baby otter.", }) if err != nil { panic(err) } image, err := base64.StdEncoding.DecodeString(result.Data[0].B64JSON) if err != nil { panic(err) } if err := os.WriteFile("otter.png", image, 0o600); err != nil { panic(err) }}
1
2
3
4
5
6
7
8
9
10
11
12using OpenAI.Images;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-image-2.5-sunburst";ImageClient client = new(model, key);GeneratedImage image = await client.GenerateImageAsync( "A children's book drawing of a veterinarian using a stethoscope to " + "listen to the heartbeat of a baby otter.");await File.WriteAllBytesAsync("otter.png", image.ImageBytes.ToArray());
1
2
3
4
5
6
7
8
9
10
11
12
13require "base64"require "openai"client = OpenAI::Client.newresult = client.images.generate( model: "gpt-image-2.5-sunburst", prompt: "A watercolor robot reading in a library")generated_image = result.data&.first or raise "No image returned"File.binwrite( "generated-image.png", Base64.strict_decode64(generated_image.b64_json))
1
2
3
4
5
6
7curl -X POST "https://api.openai.com/v1/images/generations" \
    -H "Authorization: Bearer $OPENAI_API_KEY" \
    -H "Content-type: application/json" \
    -d '{
        "model": "gpt-image-2.5-sunburst",
        "prompt": "A children'\''s book drawing of a veterinarian using a stethoscope to listen to the heartbeat of a baby otter."
    }' | jq -r '.data[0].b64_json' | base64 --decode > otter.png
1
2
3
4
5openai images generate \
  --model gpt-image-2.5-sunburst \
  --prompt "A children's book drawing of a veterinarian using a stethoscope to listen to the heartbeat of a baby otter." \
  --raw-output \
  --transform 'data.0.b64_json' | base64 --decode > otter.png
API de respuestas
Generar una imagen
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "Generate an image of gray tabby cat hugging an otter with an orange scarf", tools: [{ type: "image_generation", model: "gpt-image-2.5-sunburst" }],});// Save the image to a fileconst imageData = response.output .filter((output) => output.type === "image_generation_call") .map((output) => output.result);if (imageData.length > 0) { const imageBase64 = imageData[0]; const fs = await import("fs"); fs.writeFileSync("otter.png", Buffer.from(imageBase64, "base64"));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22from openai import OpenAIimport base64client = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Generate an image of gray tabby cat hugging an otter with an orange scarf",tools=[{"type": "image_generation", "model": "gpt-image-2.5-sunburst"}],)# Save the image to a fileimage_data = [ output.resultfor output in response.outputif output.type =="image_generation_call"]if image_data: image_base64 = image_data[0]withopen("otter.png", "wb") as f: f.write(base64.b64decode(image_base64))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42package mainimport ( "context" "encoding/base64" "os" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("Generate an image of gray tabby cat hugging an otter with an orange scarf"), }, Tools: []responses.ToolUnionParam{{OfImageGeneration: &responses.ToolImageGenerationParam{Model: "gpt-image-2.5-sunburst"}}}, }) if err != nil { panic(err) } saveFirstGeneratedImage(response, "otter.png")}func saveFirstGeneratedImage(response *responses.Response, filename string) { for _, output := range response.Output { if output.Type != "image_generation_call" { continue } image, err := base64.StdEncoding.DecodeString(output.AsImageGenerationCall().Result) if err != nil { panic(err) } if err := os.WriteFile(filename, image, 0o600); err != nil { panic(err) } return } panic("response did not include an image generation call")}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new() { Model = "gpt-6-astra" };options.InputItems.Add( ResponseItem.CreateUserMessageItem( "Generate an image of a gray tabby cat hugging an otter with an orange scarf." ));options.Tools.Add(ResponseTool.CreateImageGenerationTool(model: "gpt-image-2.5-sunburst"));ResponseResult response = await client.CreateResponseAsync(options);ImageGenerationCallResponseItem image = response .OutputItems.OfType<ImageGenerationCallResponseItem>() .FirstOrDefault() ?? throw new InvalidOperationException("No generated image was returned.");await File.WriteAllBytesAsync("otter.png", image.ImageResultBytes.ToArray());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24require "base64"require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: "Generate an image of a gray tabby cat hugging an otter with an orange scarf.", tools: [ { type: :image_generation, model: "gpt-image-2.5-sunburst" } ])image_call = response.output.find do |item| item.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall)endunless image_call.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall) raise "No image generation call returned"endencoded_image = image_call.result or raise "No image returned"File.binwrite("otter.png", Base64.strict_decode64(encoded_image))
Generación de imágenes en varios turnos
Con la API de respuestas, puedes crear conversaciones de varios turnos que incluyan generación de imágenes. Para hacerlo, incluye en el contexto los resultados de las llamadas de generación de imágenes (también basta con el ID de la imagen) o usa previous_response_id para indicar la respuesta anterior.
Así puedes trabajar sobre una imagen en varios turnos, ajustar los prompts y aplicar nuevas instrucciones para modificar el resultado visual a medida que avanza la conversación.
Con la herramienta de generación de imágenes de la API de respuestas, los modelos compatibles con la herramienta pueden decidir si generan una imagen nueva o editan una que ya está en la conversación. El parámetro opcional action controla este comportamiento. Usa action: "auto" para que el modelo decida, action: "generate" para crear siempre una imagen nueva o action: "edit" para forzar la edición cuando el contexto incluya una imagen.
Forzar la creación de una imagen con action
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "Generate an image of gray tabby cat hugging an otter with an orange scarf", tools: [ { type: "image_generation", model: "gpt-image-2.5-sunburst", action: "generate" }, ],});// Save the image to a fileconst imageData = response.output .filter((output) => output.type === "image_generation_call") .map((output) => output.result);if (imageData.length > 0) { const imageBase64 = imageData[0]; const fs = await import("fs"); fs.writeFileSync("otter.png", Buffer.from(imageBase64, "base64"));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24from openai import OpenAIimport base64client = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Generate an image of gray tabby cat hugging an otter with an orange scarf",tools=[ {"type": "image_generation", "model": "gpt-image-2.5-sunburst", "action": "generate"} ],)# Save the image to a fileimage_data = [ output.resultfor output in response.outputif output.type =="image_generation_call"]if image_data: image_base64 = image_data[0]withopen("otter.png", "wb") as f: f.write(base64.b64decode(image_base64))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38package mainimport ( "context" "encoding/base64" "os" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("Generate an image of gray tabby cat hugging an otter with an orange scarf"), }, Tools: []responses.ToolUnionParam{{OfImageGeneration: &responses.ToolImageGenerationParam{Model: "gpt-image-2.5-sunburst", Action: "generate"}}}, }) if err != nil { panic(err) } for _, output := range response.Output { if output.Type != "image_generation_call" { continue } image, err := base64.StdEncoding.DecodeString(output.AsImageGenerationCall().Result) if err != nil { panic(err) } if err := os.WriteFile("otter.png", image, 0o600); err != nil { panic(err) } return } panic("response did not include an image generation call")}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new() { Model = "gpt-6-astra" };options.InputItems.Add( ResponseItem.CreateUserMessageItem( "Generate an image of a gray tabby cat hugging an otter with an orange scarf." ));options.Tools.Add( ResponseTool.CreateImageGenerationTool( model: "gpt-image-2.5-sunburst", action: ImageGenerationToolAction.Generate ));ResponseResult response = await client.CreateResponseAsync(options);ImageGenerationCallResponseItem image = response .OutputItems.OfType<ImageGenerationCallResponseItem>() .FirstOrDefault() ?? throw new InvalidOperationException("No generated image was returned.");await File.WriteAllBytesAsync("otter.png", image.ImageResultBytes.ToArray());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "base64"require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: "Generate an image of a gray tabby cat hugging an otter with an orange scarf.", tools: [ { type: :image_generation, model: "gpt-image-2.5-sunburst", action: :generate } ])image_call = response.output.find do |item| item.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall)endunless image_call.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall) raise "No image generation call returned"endencoded_image = image_call.result or raise "No image returned"output_path = ENV.fetch("OPENAI_EXAMPLE_OUTPUT_PATH", "otter.png")File.binwrite(output_path, Base64.decode64(encoded_image))puts(output_path)
Si fuerzas edit sin incluir una imagen en el contexto, la llamada devolverá un error. Deja action en auto para que el modelo decida cuándo generar una imagen y cuándo editarla.
“Genera una imagen de un gato gris atigrado que abraza a una nutria con una bufanda naranja”
“Ahora haz que se vea realista”
Transmisión en tiempo real
La API de respuestas y la API de imágenes admiten la transmisión en tiempo real durante la generación de imágenes. Puedes recibir imágenes parciales a medida que las API las generan para ofrecer una experiencia más interactiva.
Puedes ajustar el parámetro partial_images para recibir entre 0 y 3 imágenes parciales.
Si estableces partial_images en 0, solo recibirás la imagen final.
Si el valor es mayor que cero y la imagen final se genera antes, es posible que recibas menos imágenes parciales de las que solicitaste.
API de respuestas
Transmitir una imagen en tiempo real
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import OpenAI from "openai";import fs from "fs";const openai = new OpenAI();function saveBase64Image(filename, imageBase64) { const imageBuffer = Buffer.from(imageBase64, "base64"); fs.writeFileSync(filename, imageBuffer);}const stream = await openai.responses.create({ model: "gpt-6-astra", input: "Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape", stream: true, tools: [ { type: "image_generation", model: "gpt-image-2.5-sunburst", partial_images: 2 }, ],});for await (const event of stream) { if (event.type === "response.image_generation_call.partial_image") { const idx = event.partial_image_index; saveBase64Image(`river-partial-${idx}.png`, event.partial_image_b64); } else if (event.type === "response.completed") { const imageData = event.response.output .filter((output) => output.type === "image_generation_call") .map((output) => output.result); if (imageData.length > 0) { saveBase64Image("river-final.png", imageData[0]); } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34from openai import OpenAIimport base64client = OpenAI()defsave_base64_image(filename, image_base64): image_bytes = base64.b64decode(image_base64)withopen(filename, "wb") as f: f.write(image_bytes)stream = client.responses.create(model="gpt-6-astra",input="Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape",stream=True,tools=[ {"type": "image_generation", "model": "gpt-image-2.5-sunburst", "partial_images": 2} ],)for event in stream:if event.type =="response.image_generation_call.partial_image": idx = event.partial_image_index save_base64_image(f"river-partial-{idx}.png", event.partial_image_b64)elif event.type =="response.completed": image_data = [ output.resultfor output in event.response.outputif output.type =="image_generation_call" ]if image_data: save_base64_image("river-final.png", image_data[0])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49package mainimport ( "context" "encoding/base64" "fmt" "os" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() stream := client.Responses.NewStreaming(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape"), }, Tools: []responses.ToolUnionParam{{OfImageGeneration: &responses.ToolImageGenerationParam{Model: "gpt-image-2.5-sunburst", PartialImages: openai.Int(2)}}}, }) for stream.Next() { event := stream.Current() if event.Type == "response.image_generation_call.partial_image" { partial := event.AsResponseImageGenerationCallPartialImage() saveImage(fmt.Sprintf("river-partial-%d.png", partial.PartialImageIndex), partial.PartialImageB64) } if event.Type == "response.completed" { for _, output := range event.AsResponseCompleted().Response.Output { if output.Type == "image_generation_call" { saveImage("river-final.png", output.AsImageGenerationCall().Result) } } } } if err := stream.Err(); err != nil { panic(err) }}func saveImage(filename, encoded string) { image, err := base64.StdEncoding.DecodeString(encoded) if err != nil { panic(err) } if err := os.WriteFile(filename, image, 0o600); err != nil { panic(err) }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33require "base64"require "openai"client = OpenAI::Client.newstream = client.responses.stream( model: "gpt-6-astra", input: "Generate an image of a river made of white owl feathers.", tools: [ { type: :image_generation, model: "gpt-image-2.5-sunburst", partial_images: 2 } ])stream.each do |event| case event when OpenAI::Models::Responses::ResponseImageGenCallPartialImageEvent image = Base64.strict_decode64(event.partial_image_b64) File.binwrite("river-partial-#{event.partial_image_index}.png", image) when OpenAI::Models::Responses::ResponseCompletedEvent image_call = event.response.output.find do |item| item.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall) end next unless image_call.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall) File.binwrite( "river-final.png", Base64.strict_decode64(image_call.result) ) endend
API de imágenes
Transmitir una imagen en tiempo real
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import fs from "fs";import OpenAI from "openai";const openai = new OpenAI();const prompt = "Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape";const stream = await openai.images.generate({ prompt: prompt, model: "gpt-image-2.5-sunburst", stream: true, partial_images: 2,});for await (const event of stream) { if (event.type === "image_generation.partial_image") { const idx = event.partial_image_index; const imageBase64 = event.b64_json; const imageBuffer = Buffer.from(imageBase64, "base64"); fs.writeFileSync(`river${idx}.png`, imageBuffer); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIimport base64client = OpenAI()stream = client.images.generate(prompt="Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape",model="gpt-image-2.5-sunburst",stream=True,partial_images=2,)for event in stream:if event.type =="image_generation.partial_image": idx = event.partial_image_index image_base64 = event.b64_json image_bytes = base64.b64decode(image_base64)withopen(f"river{idx}.png", "wb") as f: f.write(image_bytes)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40package mainimport ( "context" "encoding/base64" "fmt" "os" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() stream := client.Images.GenerateStreaming(context.Background(), openai.ImageGenerateParams{ Model: openai.ImageModel("gpt-image-2.5-sunburst"), Prompt: "Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape", PartialImages: openai.Int(2), }) for stream.Next() { event := stream.Current() if event.Type != "image_generation.partial_image" { continue } partial := event.AsImageGenerationPartialImage() saveImage(fmt.Sprintf("river%d.png", partial.PartialImageIndex), partial.B64JSON) } if err := stream.Err(); err != nil { panic(err) }}func saveImage(filename, encoded string) { image, err := base64.StdEncoding.DecodeString(encoded) if err != nil { panic(err) } if err := os.WriteFile(filename, image, 0o600); err != nil { panic(err) }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.images.ImageGenerateParams;import java.nio.file.Files;import java.nio.file.Path;import java.util.Base64;var params = ImageGenerateParams.builder() .prompt( "Draw a gorgeous image of a river made of white owl feathers, snaking its way through a serene winter landscape") .model("gpt-image-2.5-sunburst") .partialImages(2) .build();try (var stream = client.images().generateStreaming(params)) { var events = stream.stream().iterator(); while (events.hasNext()) { var event = events.next(); if (event.generationPartialImage().isPresent()) { var partial = event.generationPartialImage().orElseThrow(); Files.write( Path.of("river" + partial.partialImageIndex() + ".png"), Base64.getDecoder().decode(partial.b64Json())); } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "base64"require "openai"client = OpenAI::Client.newstream = client.images.generate_stream_raw( model: "gpt-image-2.5-sunburst", prompt: "A river made of white owl feathers in a winter landscape", partial_images: 2)stream.each do |event| next unless event.is_a?(OpenAI::Models::ImageGenPartialImageEvent) image = Base64.strict_decode64(event.b64_json) File.binwrite("river#{event.partial_image_index}.png", image)end
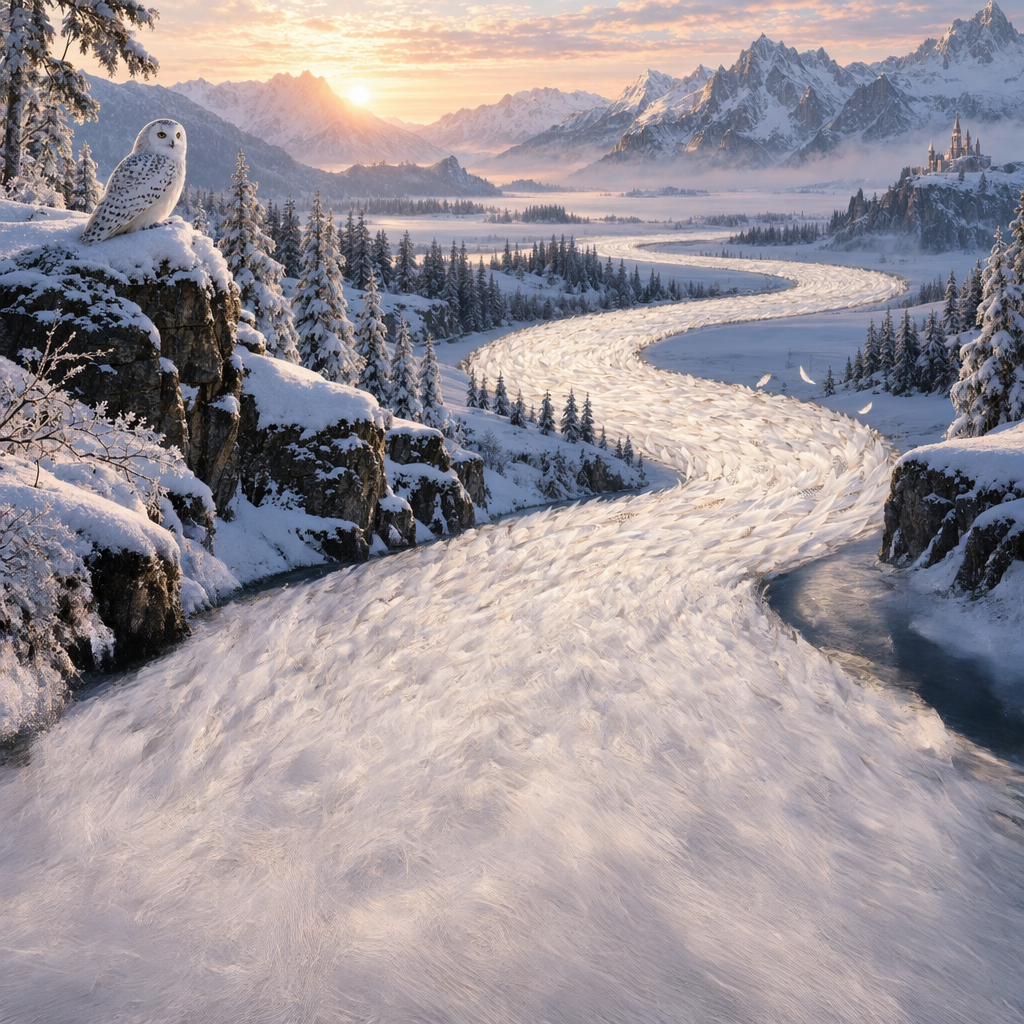
Resultado
Imagen parcial 1
Imagen parcial 2
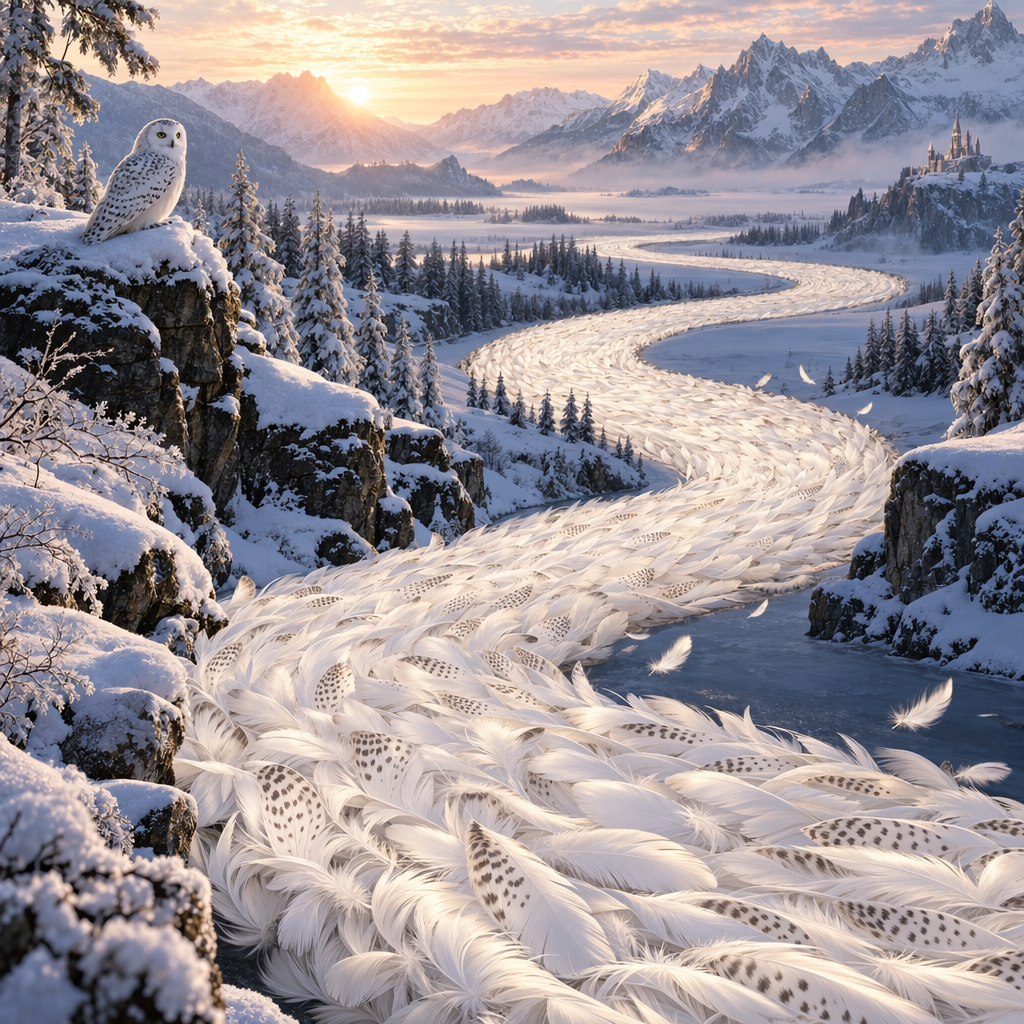
Imagen final
Prompt: dibuja una hermosa imagen de un río de plumas blancas de búho que serpentea por un apacible paisaje invernal.
Prompt revisado
Cuando usas la herramienta de generación de imágenes de la API de respuestas, el modelo principal (por ejemplo, gpt-5.5) revisa automáticamente tu prompt para mejorar los resultados.
Puedes consultar el prompt revisado en el campo revised_prompt de la llamada de generación de imágenes:
Respuesta con el prompt revisado
1
2
3
4
5
6
7{"id": "ig_123","type": "image_generation_call","status": "completed","revised_prompt": "A gray tabby cat hugging an otter. The otter is wearing an orange scarf. Both animals are cute and friendly, depicted in a warm, heartwarming style.","result": "..."}
Generar imágenes nuevas usando otras imágenes como referencia.
Editar partes de una imagen. Para hacerlo, sube la imagen junto con una máscara que indique las áreas que se deben reemplazar.
Crear una imagen a partir de imágenes de referencia
Puedes usar una o más imágenes como referencia para generar una imagen nueva.
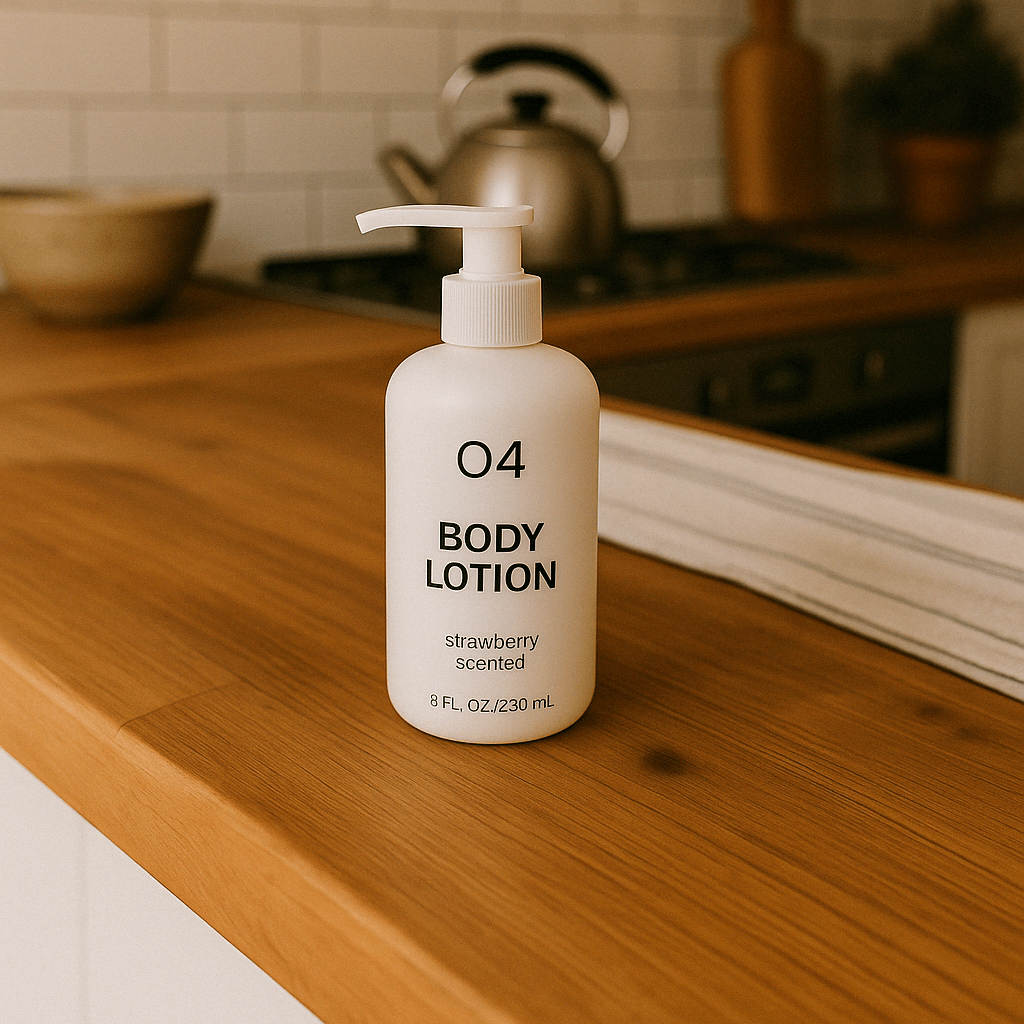
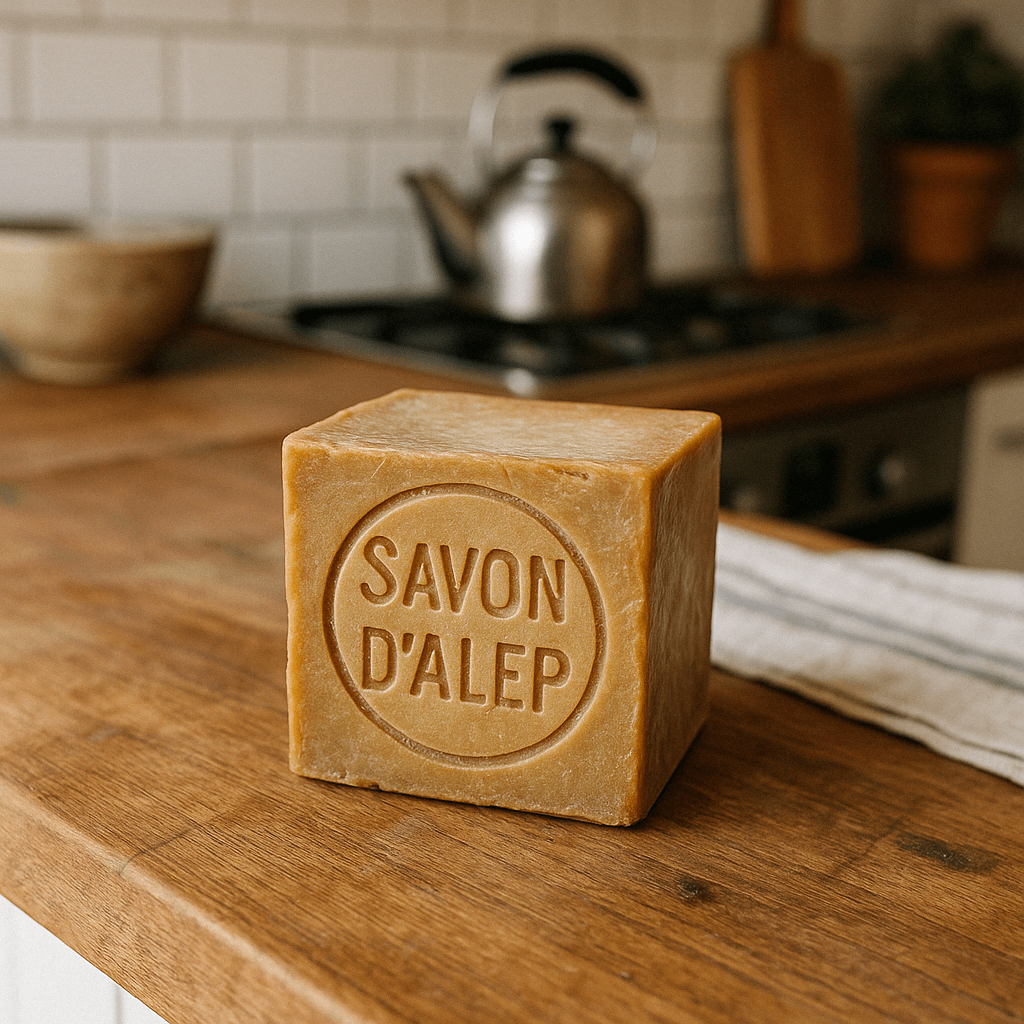
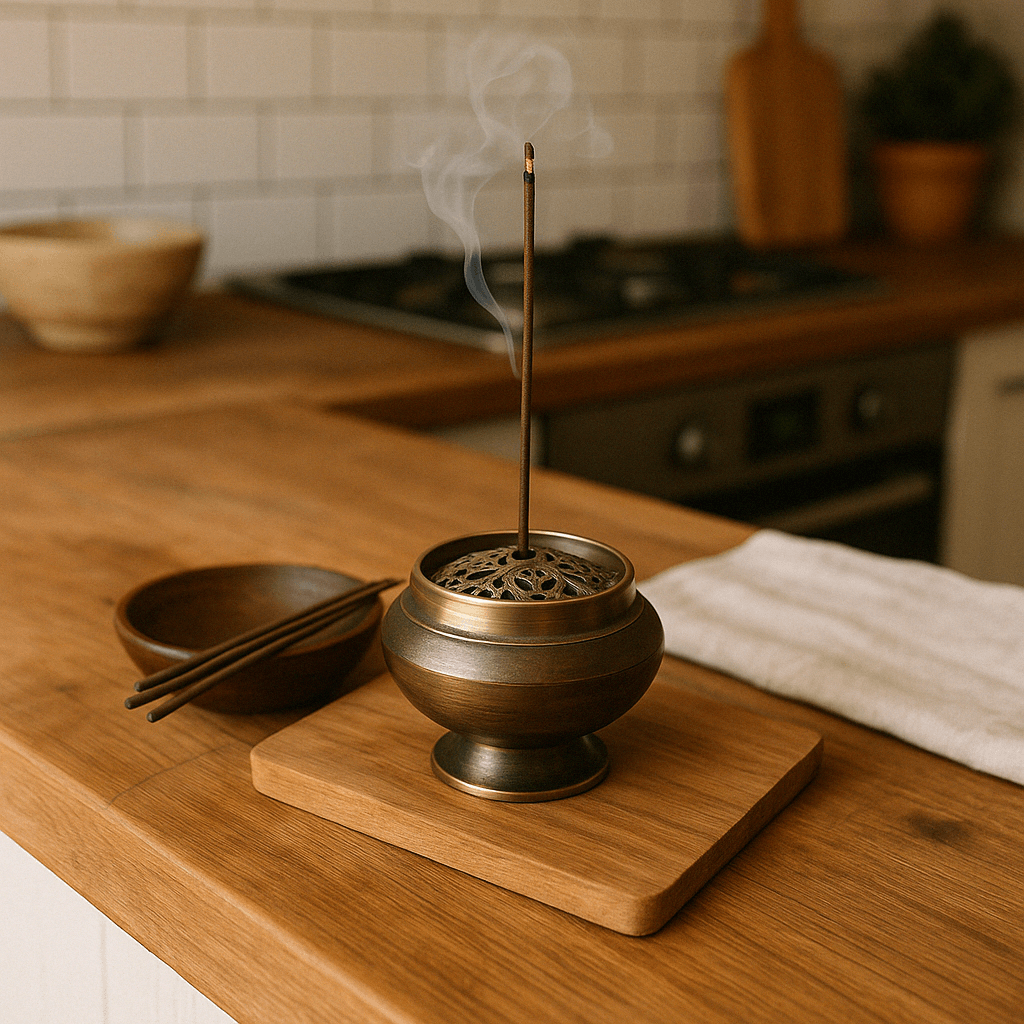
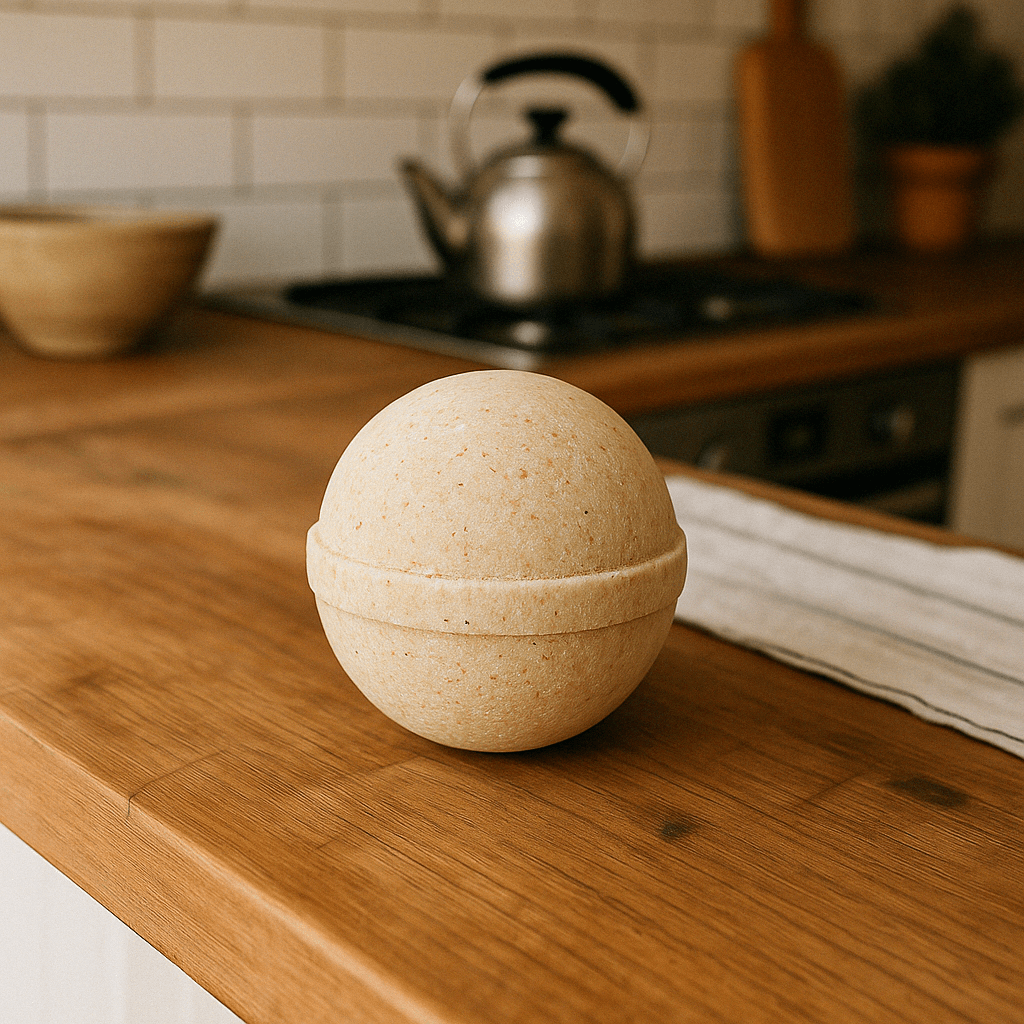
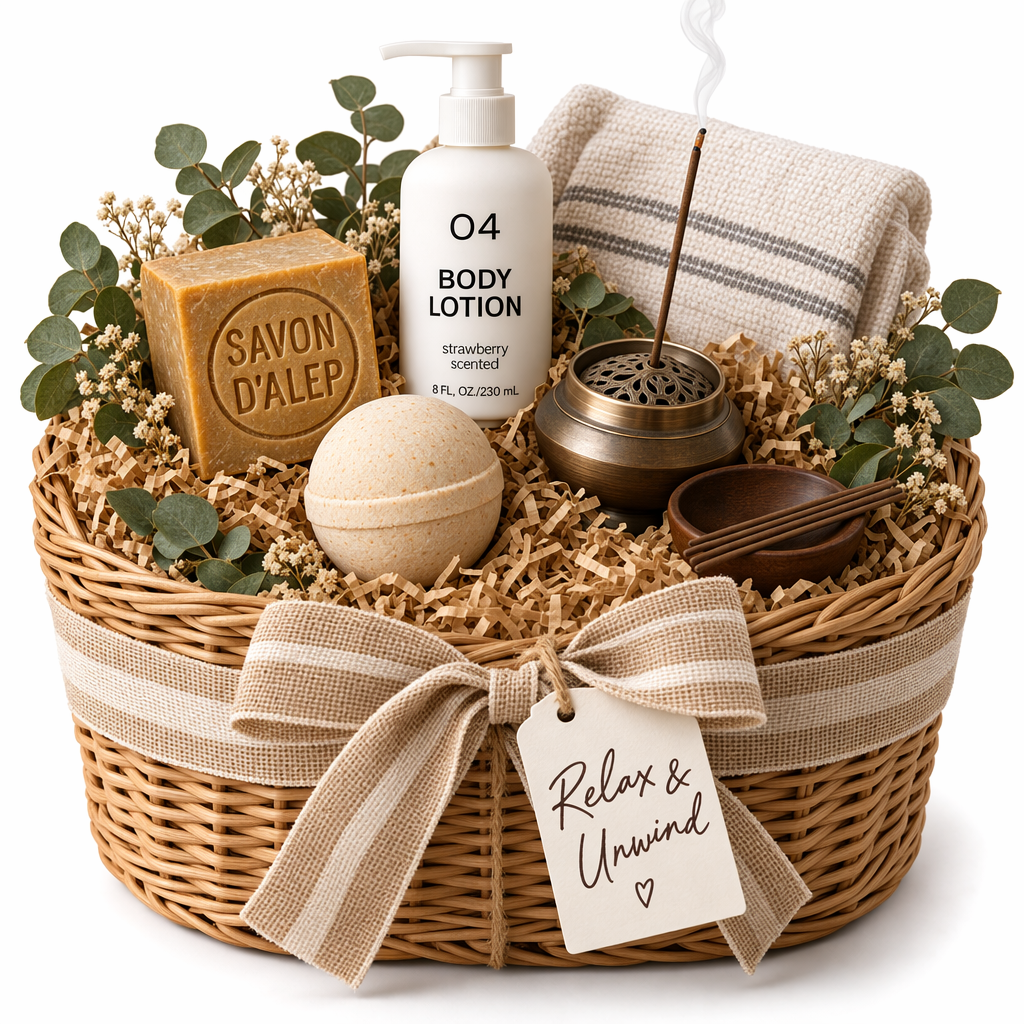
En este ejemplo, usaremos cuatro imágenes de entrada para generar una imagen de una canasta de regalo que contenga los artículos que aparecen en las imágenes de referencia.
API de respuestas
Con la API de respuestas, puedes enviar imágenes de entrada de tres maneras:
mediante una URL completa
mediante una URL de datos que contiene la imagen codificada en Base64
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58require "base64"require "openai"require "pathname"client = OpenAI::Client.newbase64_images = ["body-lotion.png", "soap.png"].map do |path| Base64.strict_encode64(File.binread(path))endfile_ids = [ client.files.create(file: Pathname("bath-bomb.png"), purpose: :vision).id, client.files.create(file: Pathname("incense-kit.png"), purpose: :vision).id]prompt = <<~PROMPT Generate a photorealistic image of a gift basket on a white background labeled 'Relax & Unwind' with a ribbon and handwriting-like font, containing all the items in the reference pictures.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :user, content: [ { type: :input_text, text: prompt }, *base64_images.map do |image| { type: :input_image, image_url: "data:image/png;base64,#{image}" } end, *file_ids.map do |file_id| { type: :input_image, file_id: file_id } end ] } ], tools: [ { type: :image_generation, model: "gpt-image-2.5-sunburst" } ])image_call = response.output.find do |item| item.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall)endunless image_call.is_a?(OpenAI::Models::Responses::ResponseOutputItem::ImageGenerationCall) raise "No image generation call returned"endFile.binwrite("gift-basket.png", Base64.strict_decode64(image_call.result))
API de imágenes
Editar una imagen
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37import fs from "fs";import OpenAI, { toFile } from "openai";const client = new OpenAI();const prompt = `Generate a photorealistic image of a gift basket on a white backgroundlabeled 'Relax & Unwind' with a ribbon and handwriting-like font,containing all the items in the reference pictures.`;const imageFiles = [ "fixtures/bath-bomb.png", "fixtures/body-lotion.png", "fixtures/incense-kit.png", "fixtures/soap.png",];const images = await Promise.all( imageFiles.map( async (file) => await toFile(fs.createReadStream(file), null, { type: "image/png", }) ));const response = await client.images.edit({ model: "gpt-image-2.5-sunburst", image: images, prompt,});// Save the image to a fileconst image_base64 = response.data[0].b64_json;const image_bytes = Buffer.from(image_base64, "base64");fs.writeFileSync("basket.png", image_bytes);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import base64from openai import OpenAIclient = OpenAI()prompt ="""Generate a photorealistic image of a gift basket on a white backgroundlabeled 'Relax & Unwind' with a ribbon and handwriting-like font,containing all the items in the reference pictures."""result = client.images.edit(model="gpt-image-2.5-sunburst",image=[open("body-lotion.png", "rb"),open("bath-bomb.png", "rb"),open("incense-kit.png", "rb"),open("soap.png", "rb"), ],prompt=prompt,)image_base64 = result.data[0].b64_jsonimage_bytes = base64.b64decode(image_base64)# Save the image to a filewithopen("gift-basket.png", "wb") as f: f.write(image_bytes)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65package mainimport ( "context" "encoding/base64" "io" "os" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() files, closeFiles := openImages( "bath-bomb.png", "body-lotion.png", "incense-kit.png", "soap.png", ) defer closeFiles() response, err := client.Images.Edit(context.Background(), openai.ImageEditParams{ Model: openai.ImageModel("gpt-image-2.5-sunburst"), Image: openai.ImageEditParamsImageUnion{OfFileArray: files}, Prompt: "Generate a photorealistic image of a gift basket on a white background " + "labeled 'Relax & Unwind' with a ribbon and handwriting-like font, containing all the items in the reference pictures.", }) if err != nil { panic(err) } saveImage("basket.png", response.Data[0].B64JSON)}func openImages(names ...string) ([]io.Reader, func()) { images := make([]io.Reader, 0, len(names)) files := make([]*os.File, 0, len(names)) for _, name := range names { file, err := os.Open(name) if err != nil { closeFiles(files) panic(err) } images = append(images, openai.File(file, name, "image/png")) files = append(files, file) } return images, func() { closeFiles(files) }}func closeFiles(files []*os.File) { for _, file := range files { if err := file.Close(); err != nil { panic(err) } }}func saveImage(filename, encoded string) { image, err := base64.StdEncoding.DecodeString(encoded) if err != nil { panic(err) } if err := os.WriteFile(filename, image, 0o600); err != nil { panic(err) }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.core.MultipartField;import com.openai.models.images.ImageEditParams;import java.io.IOException;import java.io.InputStream;import java.nio.file.Files;import java.nio.file.Path;import java.util.Base64;import java.util.List;Path lotion = Path.of(System.getenv("OPENAI_EXAMPLE_IMAGE_PATH"));Path soap = Path.of(System.getenv("OPENAI_EXAMPLE_IMAGE_PATH_2"));Path bathBomb = Path.of(System.getenv("OPENAI_EXAMPLE_IMAGE_PATH_3"));Path incense = Path.of(System.getenv("OPENAI_EXAMPLE_IMAGE_PATH_4"));try (InputStream lotionImage = Files.newInputStream(lotion); InputStream bathBombImage = Files.newInputStream(bathBomb); InputStream incenseImage = Files.newInputStream(incense); InputStream soapImage = Files.newInputStream(soap)) { var images = client .images() .edit( ImageEditParams.builder() .model("gpt-image-2.5-sunburst") .image( MultipartField.<ImageEditParams.Image>builder() .value( ImageEditParams.Image.ofInputStreams( List.of(lotionImage, bathBombImage, incenseImage, soapImage))) .contentType("image/png") .filename("gift-basket-reference.png") .build()) .prompt( """ Generate a photorealistic image of a gift basket on a white background labeled 'Relax & Unwind' with a ribbon and handwriting-like font, containing all the items in the reference pictures. """) .build()); Files.write( Path.of("gift-basket.png"), Base64.getDecoder().decode(images.data().orElseThrow().get(0).b64Json().orElseThrow()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "base64"require "openai"require "pathname"client = OpenAI::Client.newimages = %w[body-lotion.png bath-bomb.png incense-kit.png soap.png].map do |path| OpenAI::FilePart.new(Pathname(path), content_type: "image/png")endresult = client.images.edit( image: images, model: "gpt-image-2.5-sunburst", prompt: <<~PROMPT Generate a photorealistic image of a gift basket on a white background labeled 'Relax & Unwind' with a ribbon and handwriting-like font, containing all the items in the reference pictures. PROMPT)generated_image = result.data&.first or raise "No image returned"File.binwrite("gift-basket.png", Base64.strict_decode64(generated_image.b64_json))
1
2
3
4
5
6
7
8
9
10curl -s -D >(grep -i x-request-id >&2) \
  -o >(jq -r '.data[0].b64_json' | base64 --decode > gift-basket.png) \
  -X POST "https://api.openai.com/v1/images/edits" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F "model=gpt-image-2.5-sunburst" \
  -F "image[]=@body-lotion.png" \
  -F "image[]=@bath-bomb.png" \
  -F "image[]=@incense-kit.png" \
  -F "image[]=@soap.png" \
  -F 'prompt=Generate a photorealistic image of a gift basket on a white background labeled "Relax & Unwind" with a ribbon and handwriting-like font, containing all the items in the reference pictures'
1
2
3
4
5
6
7
8
9openai images edit \
  --model gpt-image-2.5-sunburst \
  --image body-lotion.png \
  --image bath-bomb.png \
  --image incense-kit.png \
  --image soap.png \
  --prompt 'Generate a photorealistic image of a gift basket on a white background labeled "Relax & Unwind" with a ribbon and handwriting-like font, containing all the items in the reference pictures' \
  --raw-output \
  --transform 'data.0.b64_json' | base64 --decode > gift-basket.png
Guiar la edición con anotaciones
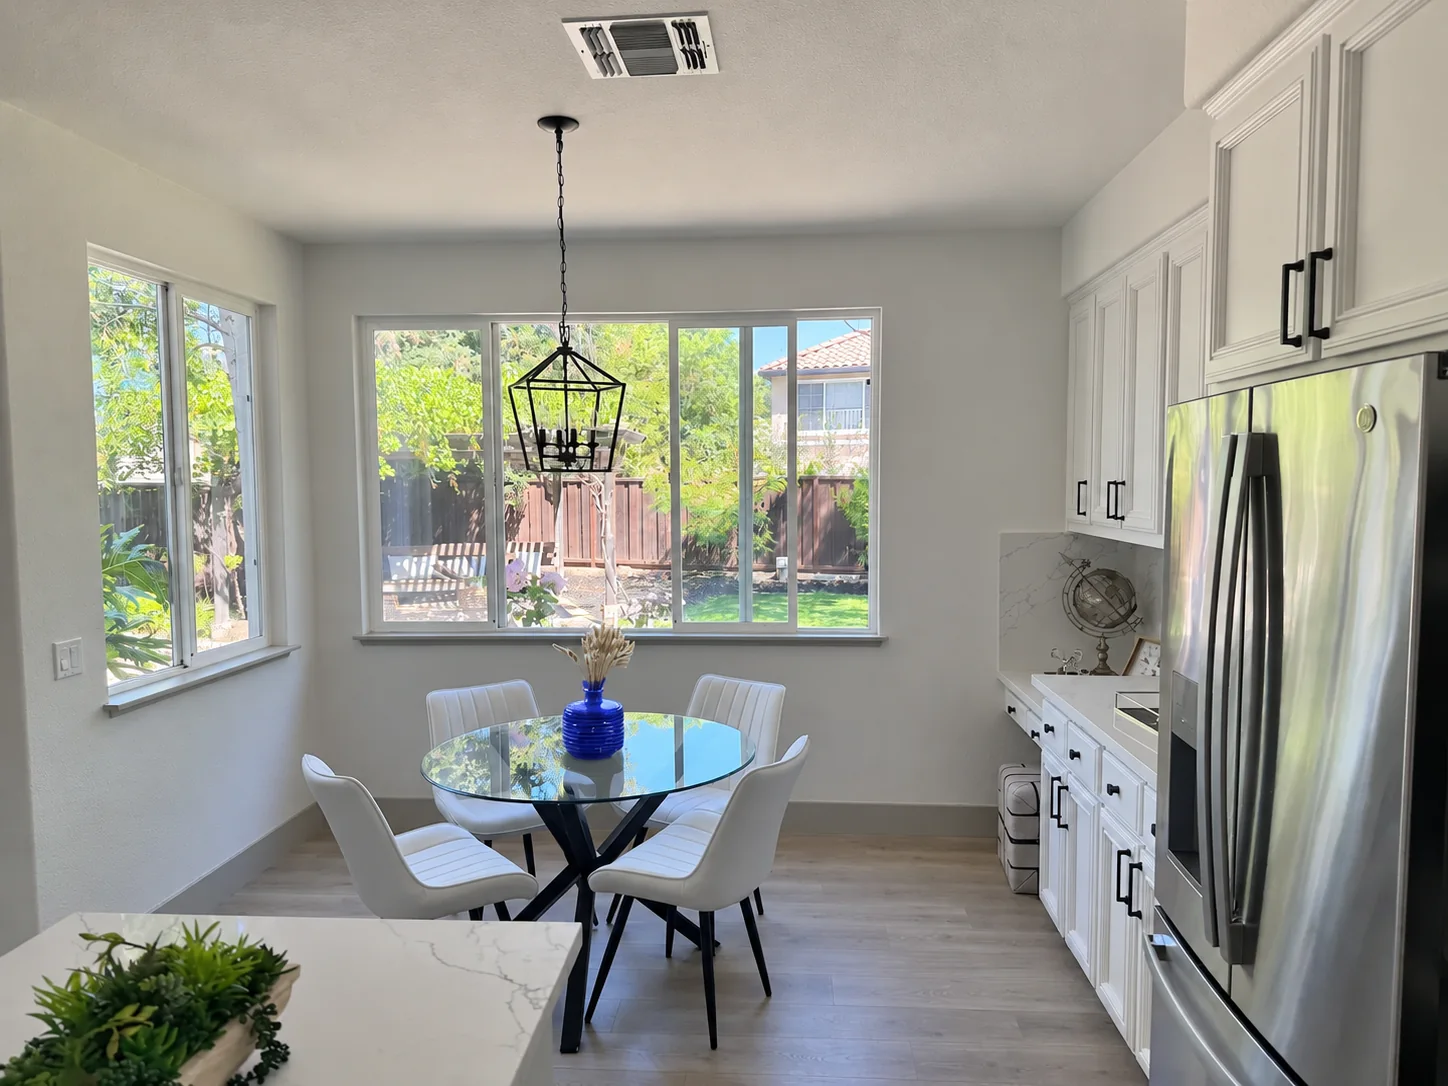
Usa el punto de acceso POST /v1/images/edits de la API de imágenes para guiar la edición con anotaciones en los modelos compatibles de GPT-Image-2.5 y GPT-Image-2.6. Para editar una zona específica con la API de respuestas, usa una máscara. Indica en una capa de anotaciones dónde quieres hacer el cambio y describe el cambio en prompt.
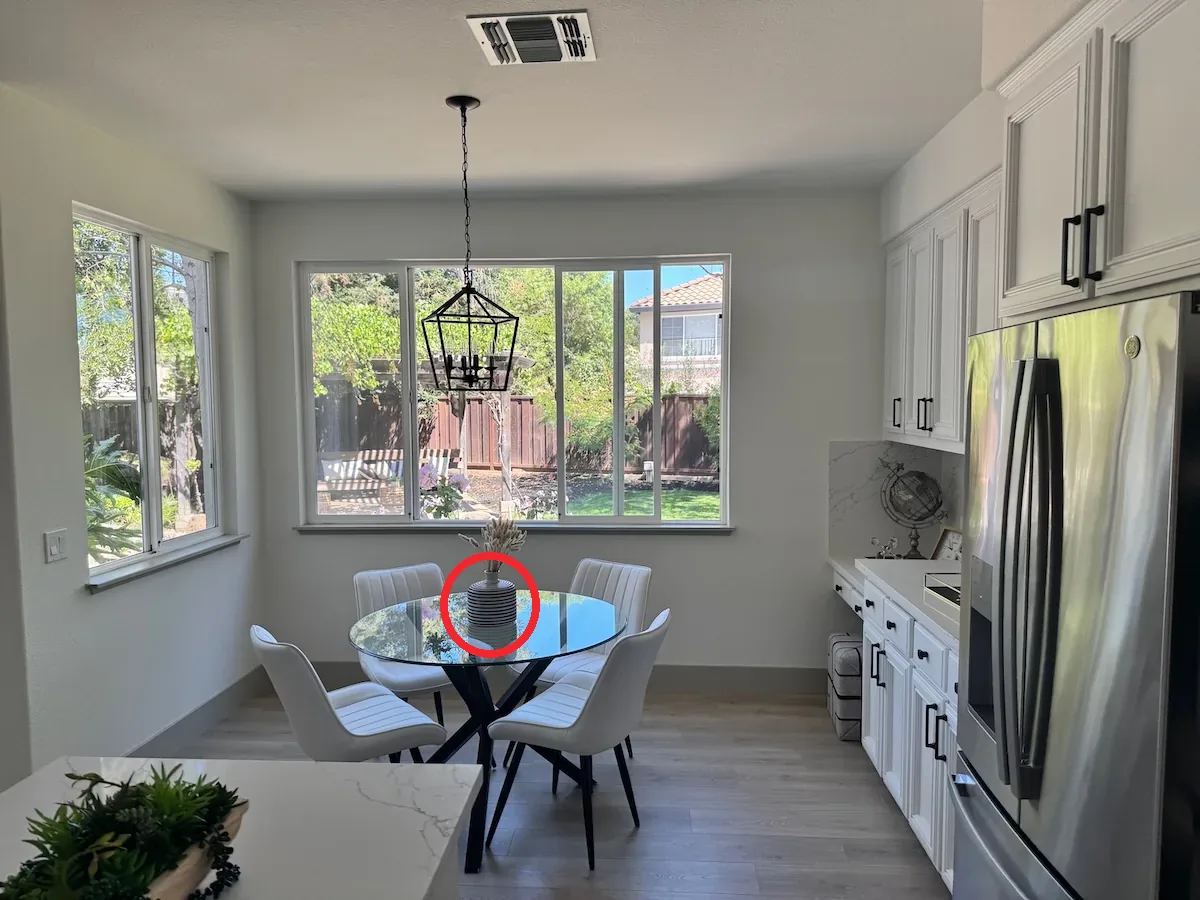
Por ejemplo, descarga la foto de la cocina y la capa transparente en el mismo directorio. En la capa transparente, un círculo señala el florero que se va a cambiar de color.
Editar el florero marcado con un círculo con la API de imágenes
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import base64from pathlib import Pathfrom openai import OpenAIclient = OpenAI()overlay = Path("markup-vase-overlay-gpt-image-2-6.png")withopen("kitchen.webp", "rb") as image, overlay.open("rb") as markup: result = client.images.edit(model="gpt-image-2.6-flare",image=("kitchen.webp", image, "image/webp"),markup=(overlay.name, markup, "image/png"),quality="medium",prompt=("Recolor the striped vase inside the red circle to solid cobalt blue ceramic. ""Keep its shape, the dried stems, and the rest of the kitchen unchanged. ""Remove the red circle from the finished photo." ), )Path("vase.png").write_bytes(base64.b64decode(result.data[0].b64_json))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31client := openai.NewClient()image, err := os.Open("kitchen.webp")if err != nil { panic(err)}defer image.Close()markup, err := os.Open("markup-vase-overlay-gpt-image-2-6.png")if err != nil { panic(err)}defer markup.Close()response, err := client.Images.Edit(context.Background(), openai.ImageEditParams{ Model: openai.ImageModel("gpt-image-2.6-flare"), Image: openai.ImageEditParamsImageUnion{OfFile: openai.File(image, "kitchen.webp", "image/webp")}, Markup: openai.File(markup, "markup-vase-overlay-gpt-image-2-6.png", "image/png"), Quality: "medium", Prompt: "Recolor the striped vase inside the red circle to solid cobalt blue ceramic. " + "Keep its shape, the dried stems, and the rest of the kitchen unchanged. " + "Remove the red circle from the finished photo.",})if err != nil { panic(err)}result, err := base64.StdEncoding.DecodeString(response.Data[0].B64JSON)if err != nil { panic(err)}if err := os.WriteFile("vase.png", result, 0o600); err != nil { panic(err)}
1
2
3
4
5
6
7
8
9
10set -euo pipefailcurl --fail --silent --show-error https://api.openai.com/v1/images/edits \ -H "Authorization: Bearer $OPENAI_API_KEY" \ -F model=gpt-image-2.6-flare \ -F quality=medium \ -F 'image=@kitchen.webp;type=image/webp' \ -F 'markup=@markup-vase-overlay-gpt-image-2-6.png;type=image/png' \ -F 'prompt=Recolor the striped vase inside the red circle to solid cobalt blue ceramic. Keep its shape, the dried stems, and the rest of the kitchen unchanged. Remove the red circle from the finished photo.' | jq -er '.data[0].b64_json' | base64 --decode > vase.png
Foto con la capa superpuesta
Resultado de Flare
Usa la imagen original como primera imagen de entrada.
Crea un archivo PNG transparente por separado con tus círculos, bocetos u otras anotaciones. Una vez aplicada la orientación, la capa de anotaciones y la primera imagen deben tener el mismo ancho y la misma altura. El PNG debe contener píxeles transparentes. No fusiones la capa con la imagen original.
Envía la capa de anotaciones en markup. Las solicitudes multiparte permiten subir un archivo. Las solicitudes JSON aceptan un objeto que debe contener exactamente uno de estos dos campos: image_url o file_id. El campo image_url admite una URL HTTPS o una URL de datos en base64. Las solicitudes de edición en JSON usan images para el arreglo de imágenes de entrada.
Describe el cambio que quieres hacer y los detalles que quieres conservar. Revisa el resultado antes de usarlo.
Las anotaciones se aplican a la primera imagen de entrada. Las imágenes adicionales sirven como referencia. Tanto la primera imagen de entrada como la capa de anotaciones pueden contener hasta 16 777 216 píxeles cada una. Además, el archivo de anotaciones no puede superar los 50 MB. No combines markup con mask.
Editar una imagen con una máscara
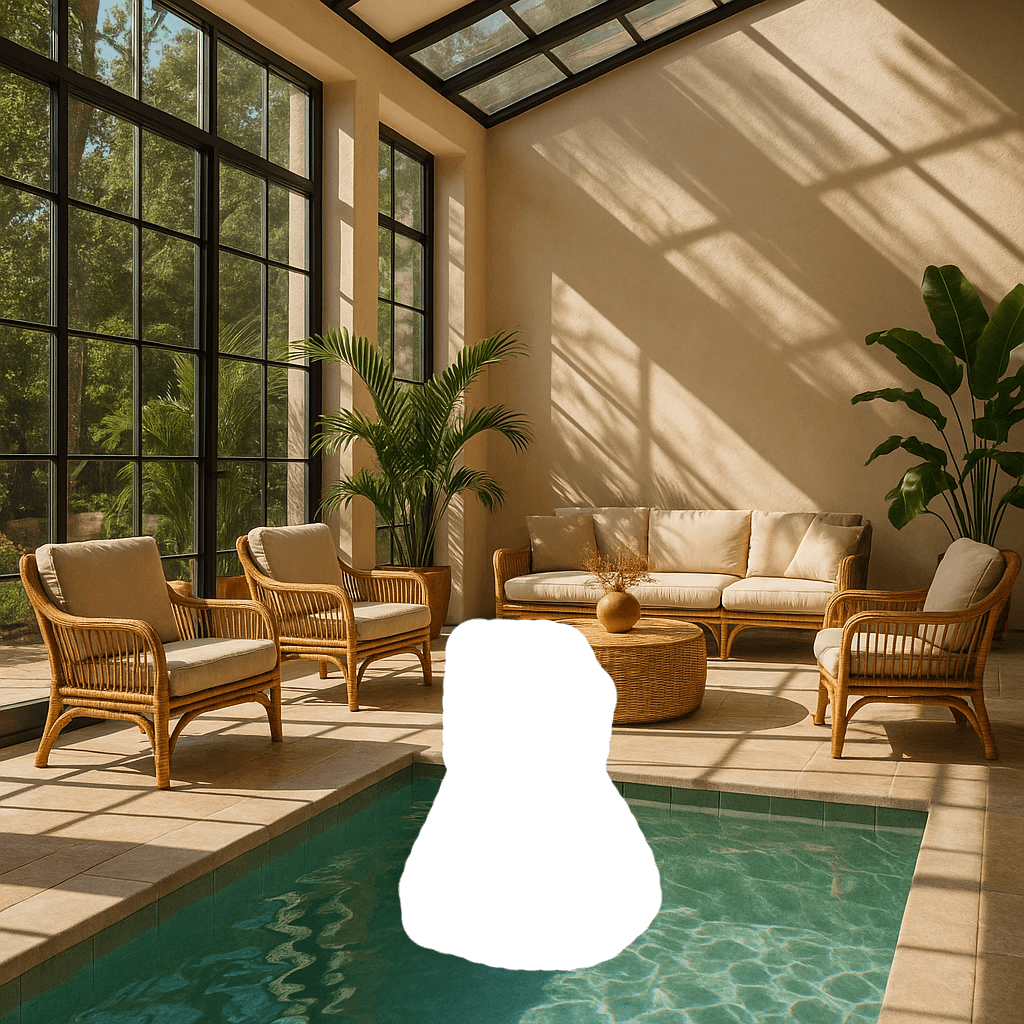
Puedes usar una máscara para indicar qué parte de la imagen quieres editar.
Cuando usas una máscara con GPT Image, el modelo recibe instrucciones adicionales que lo orientan durante la edición.
En GPT Image, la edición con máscara se basa por completo en prompts. El modelo usa la máscara como guía, pero es posible que no siga su contorno con total precisión.
Si proporcionas varias imágenes de entrada, la máscara se aplica a la primera.
API de respuestas
Editar una imagen con una máscara
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54import fs from "fs";import OpenAI from "openai";const openai = new OpenAI();async function createFile(filePath) { const result = await openai.files.create({ file: fs.createReadStream(filePath), purpose: "vision", }); return result.id;}const fileId = await createFile("fixtures/sunlit_lounge.png");const maskId = await createFile("fixtures/mask.png");const response = await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: [ { type: "input_text", text: "generate an image of the same sunlit indoor lounge area with a pool but the pool should contain a flamingo", }, { type: "input_image", file_id: fileId, detail: "auto", }, ], }, ], tools: [ { type: "image_generation", model: "gpt-image-2.5-sunburst", quality: "high", input_image_mask: { file_id: maskId, }, }, ],});const imageData = response.output .filter((output) => output.type === "image_generation_call") .map((output) => output.result);if (imageData.length > 0) { const imageBase64 = imageData[0]; fs.writeFileSync("lounge.png", Buffer.from(imageBase64, "base64"));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54from openai import OpenAIimport base64client = OpenAI()defcreate_file(file_path):withopen(file_path, "rb") as file_content: result = client.files.create(file=file_content, purpose="vision")return result.idfileId = create_file("sunlit_lounge.png")maskId = create_file("mask.png")response = client.responses.create(model="gpt-6-astra",input=[ {"role": "user","content": [ {"type": "input_text","text": "generate an image of the same sunlit indoor lounge area with a pool but the pool should contain a flamingo", }, {"type": "input_image","file_id": fileId, }, ], }, ],tools=[ {"type": "image_generation","model": "gpt-image-2.5-sunburst","quality": "high","input_image_mask": {"file_id": maskId, }, }, ],)image_data = [ output.resultfor output in response.outputif output.type =="image_generation_call"]if image_data: image_base64 = image_data[0]withopen("lounge.png", "wb") as f: f.write(base64.b64decode(image_base64))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67package mainimport ( "context" "encoding/base64" "os" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() imageID := uploadImage(client, "sunlit_lounge.png") maskID := uploadImage(client, "mask.png") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{ responses.ResponseInputItemParamOfMessage( responses.ResponseInputMessageContentListParam{ responses.ResponseInputContentParamOfInputText("Generate an image of the same sunlit indoor lounge area with a pool, but the pool should contain a flamingo."), {OfInputImage: &responses.ResponseInputImageParam{FileID: openai.String(imageID), Detail: responses.ResponseInputImageDetailAuto}}, }, responses.EasyInputMessageRoleUser, ), }}, Tools: []responses.ToolUnionParam{{OfImageGeneration: &responses.ToolImageGenerationParam{ Model: "gpt-image-2.5-sunburst", Quality: "high", InputImageMask: responses.ToolImageGenerationInputImageMaskParam{FileID: openai.String(maskID)}, }}}, }) if err != nil { panic(err) } saveFirstGeneratedImage(response, "lounge.png")}func uploadImage(client openai.Client, filename string) string { file, err := os.Open(filename) if err != nil { panic(err) } defer file.Close() uploaded, err := client.Files.New(context.Background(), openai.FileNewParams{File: file, Purpose: openai.FilePurposeVision}) if err != nil { panic(err) } return uploaded.ID}func saveFirstGeneratedImage(response *responses.Response, filename string) { for _, output := range response.Output { if output.Type != "image_generation_call" { continue } image, err := base64.StdEncoding.DecodeString(output.AsImageGenerationCall().Result) if err != nil { panic(err) } if err := os.WriteFile(filename, image, 0o600); err != nil { panic(err) } return } panic("response did not include an image generation call")}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"require "pathname"require "base64"client = OpenAI::Client.newimage = OpenAI::FilePart.new(Pathname("sunlit_lounge.png"), content_type: "image/png")mask = OpenAI::FilePart.new(Pathname("mask.png"), content_type: "image/png")result = client.images.edit( image: image, mask: mask, model: "gpt-image-2.5-sunburst", prompt: "A sunlit indoor lounge area with a pool containing a flamingo")generated_image = result.data&.first or raise "No image returned"File.binwrite("lounge.png", Base64.strict_decode64(generated_image.b64_json))
1
2
3
4
5
6
7
8curl -s -D >(grep -i x-request-id >&2) \
  -o >(jq -r '.data[0].b64_json' | base64 --decode > lounge.png) \
  -X POST "https://api.openai.com/v1/images/edits" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F "model=gpt-image-2.5-sunburst" \
  -F "mask=@mask.png" \
  -F "image[]=@sunlit_lounge.png" \
  -F 'prompt=A sunlit indoor lounge area with a pool containing a flamingo'
1
2
3
4
5
6
7openai images edit \
  --model gpt-image-2.5-sunburst \
  --image sunlit_lounge.png \
  --mask mask.png \
  --prompt "A sunlit indoor lounge area with a pool containing a flamingo" \
  --raw-output \
  --transform 'data.0.b64_json' | base64 --decode > out.png
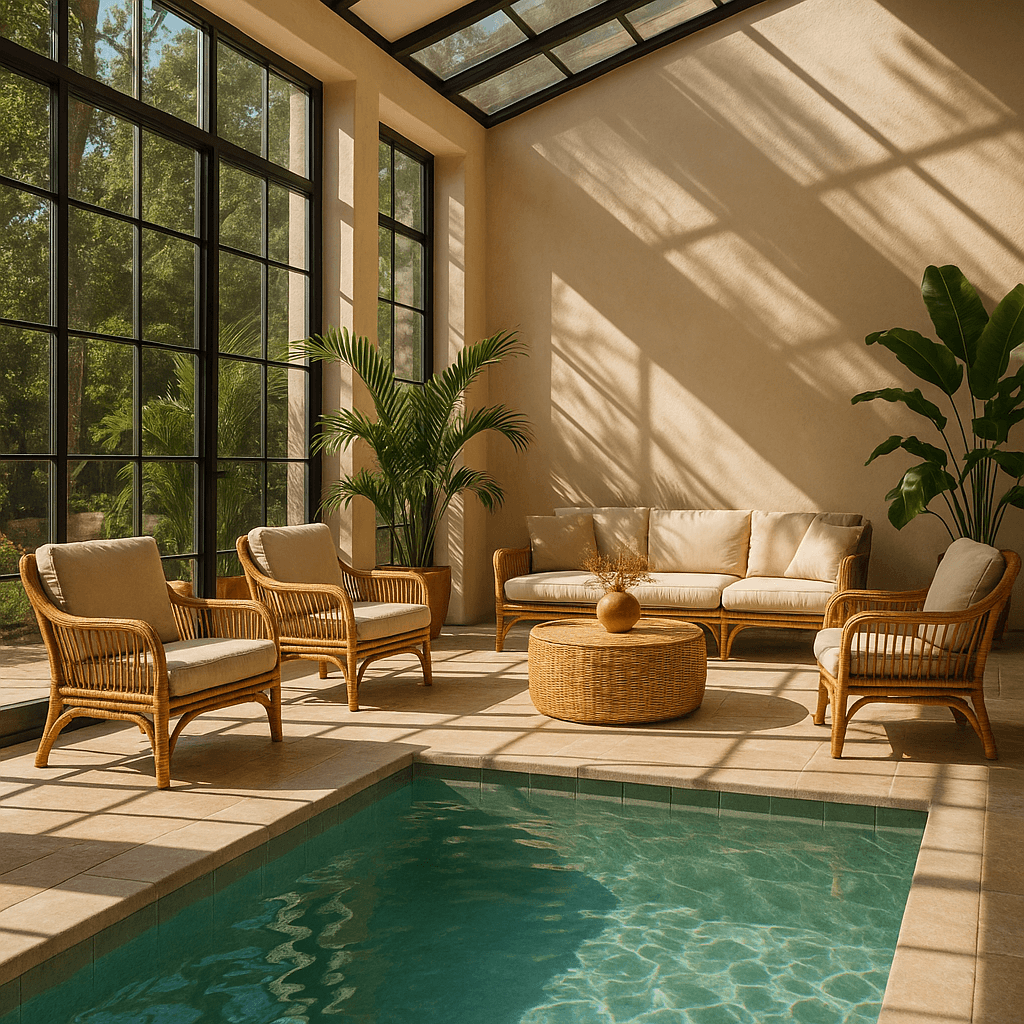
Imagen
Máscara
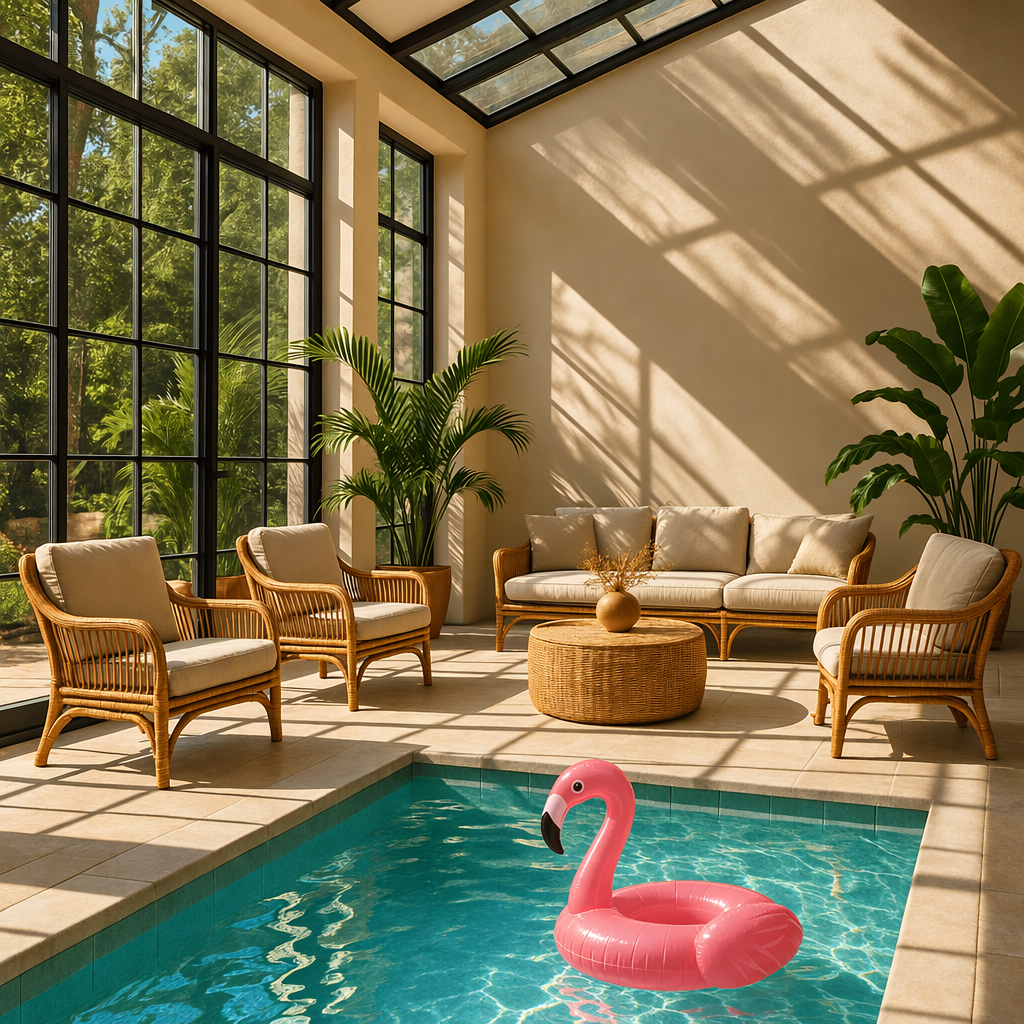
Resultado
Prompt: una sala de descanso interior iluminada por el sol, con un flamenco en la piscina.
Requisitos de la máscara
La imagen que quieres editar y la máscara deben tener el mismo formato y las mismas dimensiones. Cada archivo debe ocupar menos de 50 MB.
La imagen de la máscara también debe tener un canal alfa. Si creas la máscara con una herramienta de edición de imágenes, asegúrate de guardarla con un canal alfa.
Puedes agregar un canal alfa a una imagen en blanco y negro mediante código.
Agregar un canal alfa a una máscara en blanco y negro
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21fromPILimport Imagefrom io import BytesIO# 1. Load your black & white mask as a grayscale imagemask = Image.open("mask.png").convert("L")# 2. Convert it to RGBA so it has space for an alpha channelmask_rgba = mask.convert("RGBA")# 3. Then use the mask itself to fill that alpha channelmask_rgba.putalpha(mask)# 4. Convert the mask into bytesbuf = BytesIO()mask_rgba.save(buf, format="PNG")mask_bytes = buf.getvalue()# 5. Save the resulting fileimg_path_mask_alpha ="mask_alpha.png"withopen(img_path_mask_alpha, "wb") as f: f.write(mask_bytes)
Puedes configurar las siguientes opciones de salida:
Tamaño: dimensiones de la imagen (por ejemplo, 1024x1024, 1024x1536).
Calidad: calidad de renderizado (por ejemplo, low, medium, high).
Formato: formato del archivo de salida.
Compresión: nivel de compresión (del 0 al 100 %) para los formatos JPEG y WebP.
Fondo: transparente, opaco o automático.
size, quality y background admiten la opción auto, que permite al modelo seleccionar automáticamente el valor más adecuado según el prompt.
Opciones de tamaño y calidad
gpt-image-2.5-sunburst y gpt-image-2.5-flare incorporan los niveles de calidad xhigh y max. Ambos modelos usan auto de forma predeterminada. Los modelos GPT Image anteriores admiten niveles de calidad de hasta high.
Ambos modelos también admiten dimensiones personalizadas expresadas como cadenas con el formato WIDTHxHEIGHT, por ejemplo, 1536x864. El ancho y la altura deben ser múltiplos de 16, la relación de aspecto debe estar entre 1:3 y 3:1, y ningún lado puede superar los 3840 píxeles. El total de píxeles debe estar entre 655 360 y 8 294 400 (4K). Las resoluciones superiores a 2560x1440 son experimentales.
Para obtener un fondo transparente con cualquiera de los dos modelos, configura background: "transparent" y usa output_format: "png" o "webp".
Usa quality: "low" para generar borradores rápidamente. Para las imágenes finales, compara niveles de calidad más altos hasta encontrar el equilibrio adecuado entre detalle, latencia y costo.
Formato de salida
La API de imágenes devuelve los datos de imagen codificados en base64.
El formato predeterminado es png, pero también puedes solicitar jpeg o webp.
Si usas jpeg o webp, también puedes especificar el parámetro output_compression para controlar el nivel de compresión (del 0 al 100 %). Por ejemplo, output_compression=50 comprime la imagen en un 50 %.
El formato jpeg es más rápido que png, así que dale prioridad si necesitas reducir la latencia.
Generar imágenes en formato SVG
Configura output_format: "svg" en POST /v1/images/generations. Usa SVG para gráficos cuyos trazados, formas y colores debas poder editar, como íconos e ilustraciones.
Establece n en 1. La salida SVG no admite la transmisión en tiempo real, las imágenes parciales ni output_compression. El punto de acceso de edición de imágenes no admite el formato SVG como salida ni acepta archivos SVG como imágenes de mapa de bits de entrada.
La API crea una imagen de referencia y la usa para generar el SVG. El ajuste quality controla la calidad de esa imagen de referencia. Decodifica data[0].b64_json en base64 y guarda los bytes resultantes en un archivo XML con codificación UTF-8 y extensión .svg. El documento que devuelve la API contiene gráficos vectoriales estáticos. No admite scripts, recursos externos ni imágenes de mapa de bits incrustadas.
Flare y Sunburst generaron estos logotipos en formato SVG a partir del mismo prompt para diseñar el logotipo de la panadería Field & Flour.
GPT-Image-2.6 Flare
GPT-Image-2.6 Sunburst
Generar GIF animados
Configura output_format: "gif" en POST /v1/images/generations o POST /v1/images/edits. Describe en el prompt qué quieres animar, cómo debe moverse y cómo debe repetirse la animación. Si quieres guiar la animación con imágenes de referencia estáticas, envíalas al punto de acceso de edición de imágenes.
Usa estos campos de la solicitud para configurar la salida GIF en cualquiera de los dos puntos de acceso:
Campo
Valores
Valor predeterminado
frame_count
De 2 a 16 fotogramas
9
frame_duration_ms
De 20 a 2000 milisegundos por fotograma, redondeados al múltiplo de 10 ms más cercano
200
size
auto o WIDTHxHEIGHT con dimensiones positivas y múltiplos de 16 tanto para el ancho como para la altura
auto
size indica las dimensiones finales de cada fotograma. La cantidad de fotogramas, sus dimensiones y la cantidad de animaciones deben ajustarse a los límites de tamaño del modelo y al total de píxeles permitido por solicitud. Si la solicitud supera estos límites, reduce frame_count, las dimensiones de los fotogramas o n. Usa auto para que la API elija un tamaño de fotograma dentro de los límites del modelo.
La respuesta contiene la animación terminada. Decodifica el valor b64_json de cada resultado en base64 y guarda los bytes en un archivo con extensión .gif. La salida GIF no admite la transmisión en tiempo real, las imágenes parciales ni un valor personalizado de output_compression. Usa frame_count y frame_duration_ms solo con la salida GIF.
Sunburst generó esta animación del farol con frame_count=9 y frame_duration_ms=200. El mono vuelve a su postura inicial al cabo de 1,8 segundos.
Limitaciones
Los modelos GPT Image ofrecen funciones potentes y versátiles de generación de imágenes, aunque todavía tienen algunas limitaciones que debes tener en cuenta:
Latencia: los prompts complejos pueden tardar hasta 2 minutos en procesarse.
Renderizado de texto: aunque el modelo ha mejorado considerablemente, todavía puede tener dificultades para colocar el texto con precisión y lograr que sea legible.
Coherencia visual: el modelo puede producir imágenes coherentes entre sí, pero a veces le cuesta mantener la apariencia de personajes recurrentes o elementos de marca en imágenes generadas en distintas ocasiones.
Control de la composición: aunque el modelo sigue mejor las instrucciones, puede tener dificultades para colocar elementos con precisión en composiciones estructuradas o que requieren una distribución específica.
Moderación de contenido
Todos los prompts y las imágenes generadas se filtran de acuerdo con nuestra política de contenido.
Al generar imágenes con los modelos GPT Image, puedes ajustar el rigor de la moderación con el parámetro moderation. Este parámetro admite dos valores:
auto (predeterminado): filtrado estándar que busca limitar la creación de ciertas categorías de contenido que podría ser inapropiado para algunas edades.
low: filtrado menos restrictivo.
Manejar solicitudes bloqueadas y otros errores
Maneja los errores de generación de imágenes como cualquier otro error de la API. Comprueba el código de estado HTTP o el tipo de excepción del SDK, registra el ID de la solicitud y consulta la guía de códigos de error para errores de autenticación, de cuota, de límite de solicitudes y del servidor. Si el error es temporal y se debe al límite de solicitudes o al servidor, vuelve a enviar la solicitud con intervalos de espera cada vez mayores. No reintentes automáticamente las solicitudes que fallan por errores de cuota o por errores del usuario en la generación de imágenes que requieren modificar la solicitud.
El usuario puede corregir algunos errores de generación de imágenes. En esos casos, la API puede devolver error.type = "image_generation_user_error". No reintentes la solicitud automáticamente sin modificar el prompt o las imágenes de entrada. Para manejar los errores mediante código, usa error.code como criterio estable para distinguirlos.
Cuando error.code = "moderation_blocked", el error también puede incluir el objeto opcional error.moderation_details:
El objeto moderation_details proporciona información general para la depuración sin revelar las etiquetas ni las puntuaciones internas del clasificador.
moderation_stage puede tener los siguientes valores:
input: el bloqueo se originó en el prompt o en los datos de entrada de la solicitud.
output: el bloqueo se originó en una imagen generada o en una etapa posterior de moderación de la salida.
unknown: valor de respaldo que se usa en los pocos casos en que es difícil determinar el origen del bloqueo.
categories contiene etiquetas públicas que indican categorías generales. Por ejemplo, puedes encontrar valores como harassment, self-harm, sexual o violence.
En la mayoría de las aplicaciones, conviene que el mensaje principal para el usuario final sea genérico. Usa moderation_details en los registros para desarrolladores, en los flujos de trabajo de soporte y en los análisis, así como para ofrecer sugerencias breves sobre cómo corregir el problema.
Manejar errores de generación de imágenes por bloqueos de moderación
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42import OpenAI from"openai";constopenai=newOpenAI();try {// The same error handling pattern applies to image generation requests,// image edits, and Responses API tool calls that generate images.await openai.images.generate({ model: "gpt-image-2.5-sunburst", prompt: "Create a poster humiliating my coworker with insulting captions", });} catch (error) {if (error?.code !=="moderation_blocked") {throw error; }constmoderationDetails= error.error?.moderation_details;constcategories= moderationDetails?.categories ?? [];conststage= moderationDetails?.moderation_stage;let hint ="This request could not be completed because it did not meet safety requirements.";if (categories.includes("harassment")) { hint ="Try removing abusive or targeting language and focus on neutral visual details instead."; } elseif (stage ==="input") { hint ="Try revising the prompt or input images and submit the request again."; } elseif (stage ==="output") { hint ="The generated result was blocked by a safety check. Try changing the prompt and generating again."; } console.error("Image generation blocked", { request_id: error?.requestID, code: error?.code, moderation_details: moderationDetails, }); console.log(hint);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40import openaifrom openai import OpenAIclient = OpenAI()try: # The same error handling pattern applies to image generation requests, # image edits, and Responses API tool calls that generate images. client.images.generate( model="gpt-image-2.5-sunburst", prompt="Create a poster humiliating my coworker with insulting captions", )except openai.BadRequestError as error: if error.code != "moderation_blocked": raise error_body = error.body if isinstance(error.body, dict) else {} moderation_details = error_body.get("moderation_details") or {} categories = moderation_details.get("categories") or [] stage = moderation_details.get("moderation_stage") hint = "This request could not be completed because it did not meet safety requirements." if "harassment" in categories: hint = "Try removing abusive or targeting language and focus on neutral visual details instead." elif stage == "input": hint = "Try revising the prompt or input images and submit the request again." elif stage == "output": hint = "The generated result was blocked by a safety check. Try changing the prompt and generating again." print( "Image generation blocked", { "request_id": error.request_id, "code": error.code, "moderation_details": moderation_details, }, ) print(hint)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48package mainimport ( "context" "encoding/json" "errors" "fmt" "slices" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() _, err := client.Images.Generate(context.Background(), openai.ImageGenerateParams{ Model: openai.ImageModel("gpt-image-2.5-sunburst"), Prompt: "Create a poster humiliating my coworker with insulting captions", }) if err == nil { return } var apiError *openai.Error if !errors.As(err, &apiError) || apiError.Code != "moderation_blocked" { panic(err) } var body struct { ModerationDetails struct { Categories []string `json:"categories"` ModerationStage string `json:"moderation_stage"` } `json:"moderation_details"` } if err := json.Unmarshal([]byte(apiError.RawJSON()), &body); err != nil { panic(err) } hint := "This request could not be completed because it did not meet safety requirements." if slices.Contains(body.ModerationDetails.Categories, "harassment") { hint = "Try removing abusive or targeting language and focus on neutral visual details instead." } else if body.ModerationDetails.ModerationStage == "input" { hint = "Try revising the prompt or input images and submit the request again." } else if body.ModerationDetails.ModerationStage == "output" { hint = "The generated result was blocked by a safety check. Try changing the prompt and generating again." } fmt.Printf("Image generation blocked (%s): %s\n", apiError.Code, hint)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.errors.BadRequestException;import com.openai.models.images.ImageGenerateParams;import java.util.List;import java.util.Map;try { var images = client .images() .generate( ImageGenerateParams.builder() .model("gpt-image-2.5-sunburst") .prompt("Create a poster humiliating my coworker with insulting captions") .build()); System.out.println(images.data().orElseThrow().get(0).b64Json().orElseThrow());} catch (BadRequestException error) { if (!error.code().orElse("").equals("moderation_blocked")) { throw error; } Map<?, ?> body = error.body().convert(Map.class); Object detailsValue = body.get("moderation_details"); Map<?, ?> details = detailsValue instanceof Map<?, ?> values ? values : Map.of(); Object categories = details.get("categories"); Object stage = details.get("moderation_stage"); String hint = "This request did not meet safety requirements."; if (categories instanceof List<?> values && values.contains("harassment")) { hint = "Remove abusive or targeting language and focus on neutral visual details."; } else if ("input".equals(stage)) { hint = "Revise the prompt or input images, then submit the request again."; } else if ("output".equals(stage)) { hint = "Change the prompt and generate again; the generated result was blocked."; } System.err.println("Image generation blocked (" + error.code().orElseThrow() + "): " + hint);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28require "openai"client = OpenAI::Client.newbegin client.images.generate( model: "gpt-image-2.5-sunburst", prompt: "Create a poster humiliating my coworker with insulting captions" )rescue OpenAI::Errors::BadRequestError => error raise unless error.code == "moderation_blocked" body = Hash.try_convert(error.body) || {} body = Hash.try_convert(body[:error] || body["error"]) || body moderation_details = body[:moderation_details] || body["moderation_details"] || {} categories = moderation_details[:categories] || moderation_details["categories"] || [] stage = moderation_details[:moderation_stage] || moderation_details["moderation_stage"] hint = "This request did not meet safety requirements." if categories.include?("harassment") hint = "Remove abusive or targeting language and focus on neutral visual details." elsif stage == "input" hint = "Revise the prompt or input images, then submit the request again." elsif stage == "output" hint = "Change the prompt and generate again; the generated result was blocked." end warn("Image generation blocked (#{error.code}): #{hint}")end
Modelos compatibles
En la API de respuestas, gpt-5 y los modelos posteriores deberían admitir la herramienta de generación de imágenes. Consulta la página de detalles de tu modelo para confirmar si el modelo que quieres usar admite esta herramienta.
Costo y latencia
Costos de GPT-Image-2.6
La tarifa de salida de imágenes es de $30 por millón de tokens facturables. Usa la calculadora para estimar el costo de salida de una imagen.
Las ediciones guiadas por anotaciones tienen las mismas tarifas por token que las demás ediciones, sin cargos adicionales. Para la salida SVG, pagas la tarifa del modelo de imágenes por la imagen de referencia y la tarifa del modelo que escribe el SVG por los tokens que usa para producirlo. El total depende de la cantidad de tokens que use cada modelo.
Costos de GPT-Image-2.5
Las solicitudes a la API de respuestas incluyen el consumo de tokens del modelo principal, además del costo de generar las imágenes.
Los dos modelos GPT-Image-2.5 tienen las mismas tarifas por millón de tokens: $8 por tokens de imagen de entrada, $2 por tokens de imagen de entrada en caché, $30 por tokens de imagen de salida, $5 por tokens de texto de entrada y $1,25 por tokens de texto de entrada en caché. Consulta los precios.
Usa el campo usage de la respuesta para medir el consumo de tokens con tus prompts, tamaños y niveles de calidad. Aunque las tarifas por token sean iguales, el costo por imagen puede variar porque el consumo de tokens depende del modelo y del nivel de calidad. Para ver ejemplos de precios de modelos anteriores, consulta Modelos GPT Image anteriores.
Precios de las entradas en caché
En GPT-Image-2 y GPT-Image-2.5, las tarifas de entradas en caché solo se aplican a la herramienta de generación de imágenes de la API de respuestas. Las solicitudes directas a la API de imágenes, incluidas las que se envían a /v1/images/edits, quedan fuera de estas tarifas.
Las entradas en caché para la generación de imágenes se reflejan en la facturación, pero la API de respuestas no incluye en su salida el recuento de esos tokens. El campo usage de la respuesta no permite verificar estos aciertos de caché.
Calcular los costos
Selecciona un modelo, un nivel de calidad y un tamaño para estimar la cantidad de tokens de salida y el costo de la imagen de salida.
Para los modelos Sunburst y Flare, tanto en GPT-Image-2.6 como en GPT-Image-2.5, las opciones de calidad son low, medium, high, xhigh y max.
Para gpt-image-2, las opciones son low, medium y high.
Los modelos pueden usar distintas cantidades de tokens con el mismo nivel de calidad, y el precio por token de imagen de salida es el mismo.
Para esta estimación, especifica los valores de calidad y tamaño. Con auto, los valores dependen de la imagen generada.
ModeloModeloGPT-Image-2.6 (Sunburst and Flare)
Calidad
Tokens de salida
823
Costo estimado por imagen generada
USD 0.02469
El costo por imagen se calcula con una tarifa de 30 USD por millón de tokens de salida de imagen. No incluye los tokens de entrada de texto e imagen ni la transmisión de imágenes parciales.
Los detalles que siguen corresponden a modelos anteriores y no se aplican a Sunburst ni a Flare. Para integraciones nuevas, usa GPT-Image-2.6 Sunburst o Flare.
Configuración de GPT-Image-2 y fidelidad de las imágenes de entrada
gpt-image-2 acepta en el parámetro size cualquier resolución que cumpla las condiciones que se indican a continuación. Por lo general, las imágenes cuadradas se generan más rápido.
Tamaños habituales
1024x1024 (cuadrado)
1536x1024 (horizontal)
1024x1536 (vertical)
2048x2048 (cuadrado, 2K)
2048x1152 (horizontal, 2K)
3840x2160 (horizontal, 4K)
2160x3840 (vertical, 4K)
auto (predeterminado)
Restricciones de tamaño
La longitud de cada lado debe ser menor o igual que
3840px
Ambos lados deben medir un múltiplo de 16px
La relación entre el lado largo y el corto no debe superar 3:1
El total de píxeles debe ser de al menos 655,360 y como máximo
8,294,400
Opciones de calidad
low
medium
high
auto (predeterminado)
Fidelidad de las imágenes de entrada
El parámetro input_fidelity controla en qué medida el modelo conserva los detalles de las imágenes de entrada al editarlas o al usar imágenes de referencia. Con gpt-image-2, omite este parámetro. La API no permite cambiarlo porque el modelo procesa automáticamente todas las imágenes de entrada con alta fidelidad.
Como gpt-image-2 siempre procesa las imágenes de entrada con alta fidelidad, las solicitudes de edición que incluyen imágenes de referencia pueden consumir más tokens de imagen de entrada. Para saber cómo influye esto en el costo, consulta la sección sobre costos de visión.
Ejemplos de precios de modelos anteriores
Modelos anteriores a gpt-image-2
Para generar una imagen, los modelos GPT Image anteriores a gpt-image-2 primero producen tokens de imagen especializados. Tanto la latencia como el costo final son proporcionales a la cantidad de tokens necesarios para renderizar la imagen. A mayor tamaño o calidad, mayor cantidad de tokens.
La cantidad de tokens generados depende de las dimensiones y de la calidad de la imagen:
Calidad
Cuadrada (1024×1024)
Vertical (1024×1536)
Horizontal (1536×1024)
Baja
272 tokens
408 tokens
400 tokens
Media
1056 tokens
1584 tokens
1568 tokens
Alta
4160 tokens
6240 tokens
6208 tokens
También debes tener en cuenta los tokens de entrada: los tokens de texto del prompt y, si editas imágenes, los tokens de imagen de las imágenes de entrada.
Como gpt-image-2 siempre procesa las imágenes de entrada con alta fidelidad, las solicitudes de edición que incluyen imágenes de referencia pueden consumir más tokens de entrada.
Consulta la página de precios para conocer las tarifas vigentes de los tokens de texto e imagen. Usa la sección Calcular los costos para estimar el costo de las imágenes de salida.
El costo final es la suma de los costos de:
Los tokens de texto de entrada.
Los tokens de imagen de entrada, si usas el punto de acceso de edición.
Los tokens de imagen de salida.
Costos históricos de las imágenes de salida
gpt-image-2 admite miles de resoluciones válidas. Para facilitar la comparación, la tabla muestra los mismos tamaños que se usaban con los modelos GPT Image anteriores. También incluye las tarifas históricas de salida por imagen de GPT-Image-1.5, GPT-Image-1 y GPT-Image-1 Mini. Al estimar el costo total de una solicitud, recuerda incluir los tokens de texto e imagen de entrada.
gpt-image-1 dejó de estar disponible el 23 de octubre de 2026. Sus precios se conservan en la tabla para facilitar las comparaciones históricas. Consulta el aviso de retirada para conocer los modelos de reemplazo.
Con el mismo nivel de calidad, una resolución mayor de formato no cuadrado a veces produce menos tokens de salida que una resolución menor o de formato cuadrado.