
GPT-Live では、ユーザーが自然な会話のリズムでやり取りできます。相手が話している途中で口を挟んだり、話題を変えたり、話しながらアイデアを膨らませたりできます。文字起こし、言語処理、音声生成をそれぞれ別のモデルに順番に任せるカスケード型の音声システムと異なり、GPT-Live は話しながら同時に聞くことができます。言葉の内容と同じくらい、いつ話すか、どこで割って入るかが大切な場面でも、自然なやり取りが成り立ちます。
本記事では、Juno、Picsart、Treater、Weekend の開発者が、GPT-Live をどう活用し、何を学んだのかを、次のテーマに沿って自らの言葉で紹介します。
- 本番の通話データを活用した会話の改善
- ユーザーが信頼できる声の探し方
- バックグラウンドで動くエージェントとの連携
- 複数の音声エージェントによる会話の進行
各社の製品を形づくるプロンプト、ワークフロー、フィードバックを通じて、開発者が自分のアプリケーションでも試せるアイデアを見ていきます。
スタートアップの開発事例
Juno:患者が自然に話せる GPT-Live 音声アシスタント
執筆:Marshall Gould 氏(共同創業者兼 CEO)、Isaac Tolley 氏(共同創業者兼 CTO)
私たちは、新型コロナ罹患後症状(ロング COVID)、体位性頻脈症候群(POTS)、エーラス・ダンロス症候群(EDS)などの慢性疾患とともに暮らす人のために、個人向けの健康アシスタント Juno を開発しています。
開発の出発点
慢性疾患を抱えて暮らす負担には、当事者になって初めてわかることがあります。つらい症状や疲労、通院、体のどこに問題があるのかわからない不安に加え、日々の細かな管理も重くのしかかります。いつもどおりの生活を送りながら、薬の補充を忘れず、最新の研究に目を通し、症状を記録して、日々変化する何百もの要因と照らし合わせる必要があります。
慢性疾患のある人、特に使える体力が限られている人にとって、こうした記録アプリを使うこと自体が負担です。手入力に疲れ、役に立つとわかっていても使うのをやめてしまう人が少なくありません。
音声は、その状況を大きく変えました。一言話しかけるだけで、Juno がいくつもの項目をまとめて記録できるからです。
音声で今も難しいこと
音声モデルは、初期設定のままでも驚くほどのことができます。声は人にとって最も自然なコミュニケーション手段ですが、それをうまく製品に取り入れる方法は、私たちもまだ模索しています。たとえば、次のような課題があります。
- 会話の流れを途切れさせずに症状を記録したり、必要なコンテキストを取り込んだりすること
- 会話を止めずに、テキストでのやり取りの記憶を音声に引き継ぐこと
- 長い会話を続けること
私は音声モデルをクラゲにたとえています。反応は素早いのですが、自分で進む方向を決めるのは苦手です。ユーザーの直前の発言に流されやすく、たびたび立ち止まって確認を求めます。テキストモデルは、はるかに広いコンテキストを使えて、ユーザーに毎回事情を説明してもらう必要がないため、より先回りして動けます。音声では、開発する側が舵を取る必要があります。
音声エージェントを改善するための工夫
会話の流れを止めない記録とメモリ
多くの音声エージェントは、何かを頼まれるとツールに作業を送り、答えを待ちます。通話では、その待ち時間がそのまま無音になります。GPT-Live も別のエージェントに作業を委任できますが、その方法では答えが戻るまで会話が止まります。最初のバージョンでは、通話の 5 件に 4 件で、少なくとも一度は「少々お待ちください」の後に約 10 秒の沈黙が続きました。
そこで、各ターンの後に小型で高速なモデル(OpenAI の Decisions API)をバックグラウンドで動かし、次の 2 つの問いに答えさせることにしました。
- 記録すべきことはあるか。あるならどの種類か?
- ユーザーの履歴のうち、今の会話に関係するのは何か?
「頭痛を記録して」と言うと、Juno にはすぐに記録済みと通知され、実際の保存はバックグラウンドで進みます。次のターンでその頭痛について尋ねても、その時点ではすでに保存が終わっています。
2 つ目の問いはメモリのためのものです。履歴のうち、今必要な情報だけを次のターンのコンテキストに入れます。音声モデルが扱えるコンテキストはテキストモデルよりもはるかに少ないため、何を入れるかを見極めることが重要です。
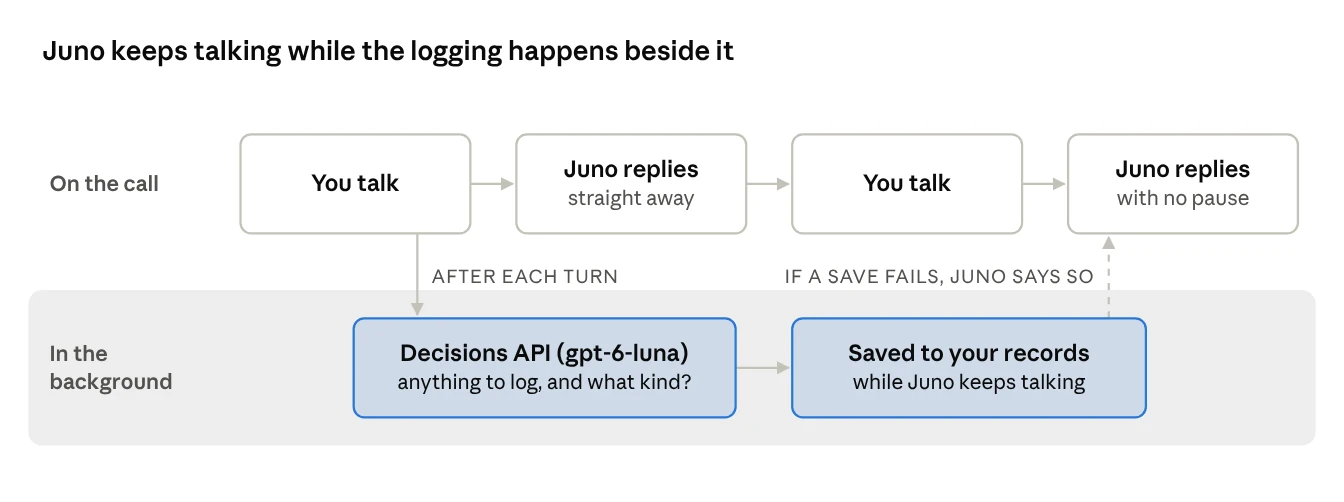
その結果、テキストエージェントへの引き継ぎは 40% 減り、テスト通話で最も長かった沈黙は 9.3 秒から 3.2 秒に短縮されました。気まずい待ち時間が、会話の自然な間に収まったのです。
長い会話
長い会話にも同じような工夫が必要です。先ほどのクラゲのように、モデルは自分で方向を見定めるのが苦手なので、舵を取る役が必要になります。会話の進行を担うエージェントが通話のコンテキストを随時更新することで、Juno は 100 ターン目でも最初のターンの内容を覚えており、話が行き詰まったときに次の話題を出せます。長い会話を支えるには、開発者自身がこの仕組みを用意する必要があります。じっくり話して初めて、自分の体調を理解する手がかりとなるパターンや傾向が見えてくるからです。
ユーザーテストで探る Juno の声
理想の声を作ることも、言うほど簡単ではありません。GPT-Live が標準で提供する声は従来のモデルから大きく進歩しましたが、それでも「AI っぽく聞こえる」という人はいます。10 人中 9 人に合う声を作れるのでしょうか。
慢性疾患のある方々にグループインタビューをしたところ、Juno の声は少しゆっくりすぎて、やや上から目線に聞こえるという意見が出ました。私たちはこの指摘を重く受け止め、改善に向けた調査を行いました。
GPT-Live の prompt-to-voice を使い、短い説明文から新しい声を設計しました。米国で慢性疾患とともに暮らす成人 290 人に、これらの声を現在の声と聞き比べてもらいました。参加者全員が同じ 3 つのセリフを聞き、それぞれの声を採点した後、最も好きな声、最も好みに合わない声、そして疲れ切った日に聞きたい声を選びました。
小規模な比較を 5 回繰り返し、その都度、評価の高い声を残して、それ以外は説明文を書き直しました。最後に、新たに参加した 171 人に、現在の声と、新しい声の上位 2 つを比較してもらいました。
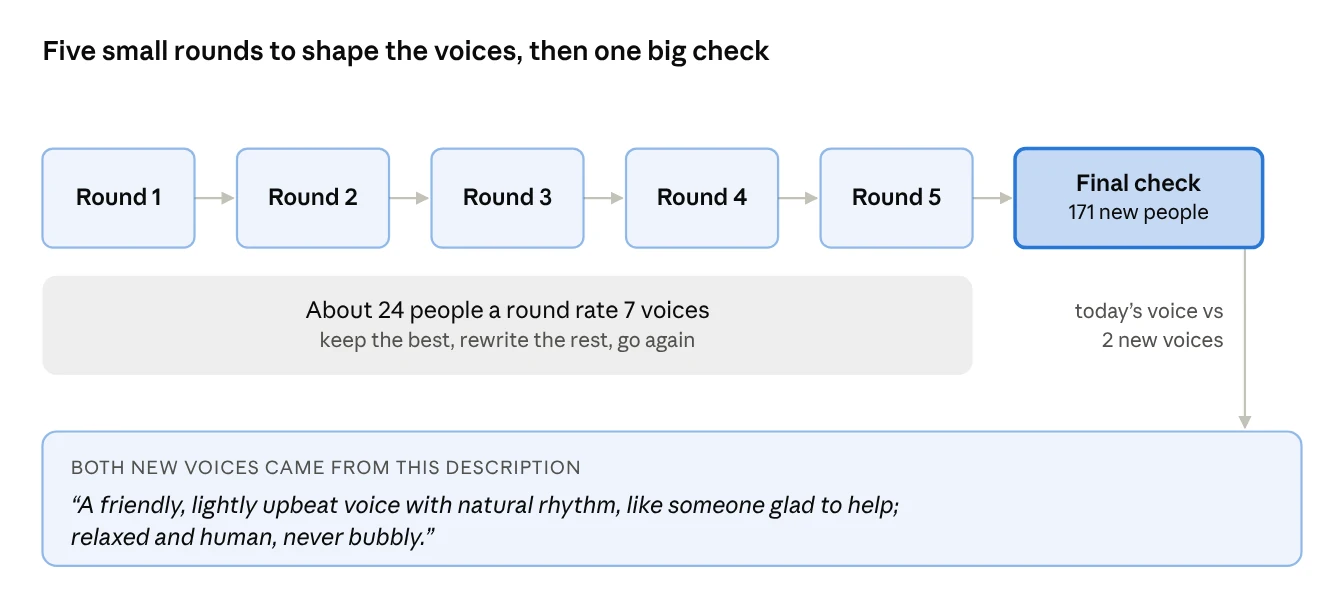
最も評価が高かったのは、上の図の説明文から作った新しい声でした。最終評価では、現在の声に比べて「最も好き」と答えた人が多く、「最も好みに合わない」と答えた人は少なくなりました。「温かみに欠ける」と答えた人は大幅に減りました。
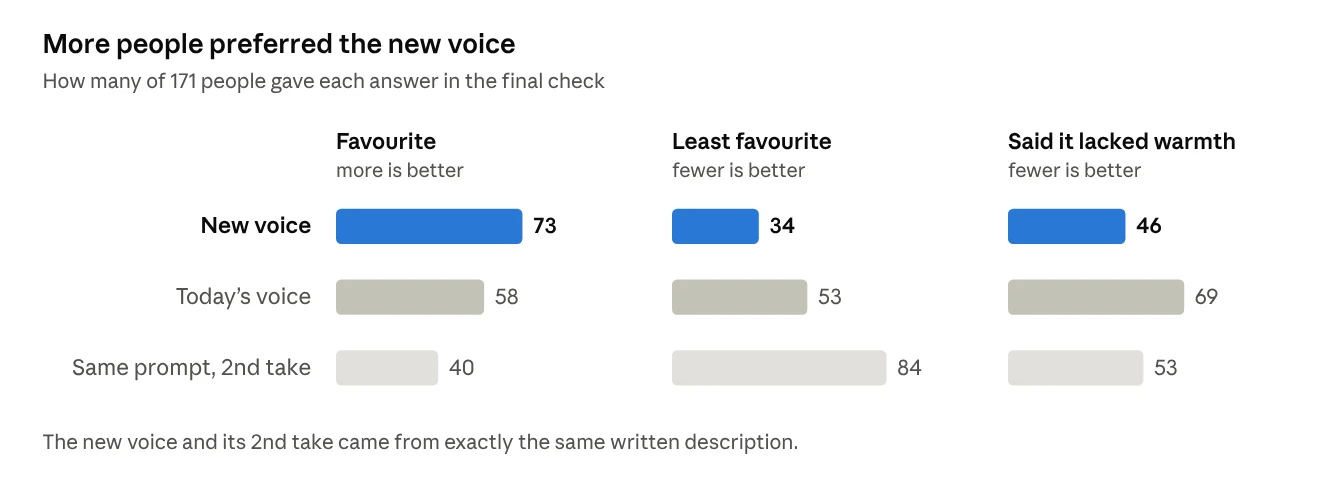
この調査には限界もあります。参加者が聞いたのは 3 つのセリフだけで、点差も小さく、実際に通話したときとは条件が違います。次は、初めて Juno に電話する人との実際の通話で新しい声を試し、翌日も利用する人が増えるかを調べます。
疲れ切った日に聞きたい声
疲れ切った日にはどの声を聞きたいか、という問いでは、現在の声が新しい声をわずかに上回りました。小さな差ですが、そもそもなぜ私たちは、たったひとつの理想の声を見つけることにこだわっているのかと考えるきっかけになりました。

私たち自身の声も一定ではありません。状況に合わせて声の調子、速さ、大きさを変えます。それなら、Juno の声も、相手のその日の調子に合わせて変えられないでしょうか。自分の話す速さや声量に合った声のほうが信頼を得やすいという研究があります(Levitan 氏ら、2016 年)。GPT-Live では、すでに通話の途中でも Juno の話し方を変えられます。次の調査ではその効果を検証します。junocompanion.com/voice-study で、すべての声と調査結果の詳細を公開しています。
音声によって、慢性疾患のある方々にできることが増え、日々の生活がどれほど楽になったかを目の当たりにしてきました。GPT-Live という優れた基盤モデルの上に小さな工夫を重ねることで、使う人が実感できる変化が生まれます。
著者と会社について
Juno 創業者の Marshall Gould です。Isaac Tolley 氏、Sean Lees 氏、Dawid Wraga 氏の 3 人の研究者とともに、Juno の声を開発しました。Juno は、慢性疾患のある方々が病気と付き合いながら暮らせるよう支援することを第一に掲げる AI 企業です。チームの大半が慢性疾患の当事者であることを、私たちは誇りに思っています。現在、数十万人が Juno を利用しています。私たちの取り組みに力を貸していただけるとうれしいです。詳しくは junocompanion.com をご覧ください。
Picsart:音声での会話とエージェントの作業の同期
執筆:Dmitry Ivanov 氏(Picsart シニアスタッフエンジニア)
開発の出発点
制作作業は通話中に終わるとは限りません。タスクの実行中でも Picsart の AI エージェントと自然に話せて、いったん通話を終え、結果ができてから戻ってくることもできるようにしたいと考えました。制作のアイデアは、最初から形が定まっているとは限りません。正確な依頼文を書くより、イメージする雰囲気や大まかな方向性を話しながら考えるほうが簡単なこともあります。
GPT-Live は、この構想を初めて実現可能にした技術でした。リアルタイムで自然に会話できるため、声で指示を伝えるだけでなく、一緒にアイデアを練る感覚が生まれます。それが、Picsart の AI エージェントに同じような会話体験を取り入れる土台になりました。
そこで、音声をエージェントへの独立したインターフェースにしつつ、テキストチャットと同じスレッドを使う設計にしました。リアルタイムの会話には GPT-Live を採用し、推論、ツールの実行、計画、保存済みのコンテキストは自社の処理層に任せています。
会話と作業を切り分ける設計

図のように、アプリは処理層に作業を送り、コンテキストと回答を GPT-Live に返します。作業の送信と進捗・結果の受信には共通の WebSocket を使います。音声とテキストのどちらでも、同じエージェント、タスク処理手順、承認ルールを使用します。
音声ゲートウェイは、選択されたエージェントの指示を使ってセッションを設定します。リアルタイムの音声は、WebRTC を介してブラウザと OpenAI の間で直接やり取りされます。送信済みのタスクは、通話終了後も実行を続けられます。
エージェントへの依頼の送信
GPT-Live がメインエージェントに作業を依頼すると、音声で受けた依頼、直近のメッセージ、添付ファイルに音声モードの印を付け、現在のエージェントとスレッドに送ります。送信時点でコンテキストを保存するため、キューに入った依頼がその後の発言で上書きされることはありません。
メインエージェントには、読み上げを前提に回答を書くよう指示します。短い話し言葉で答える、一度に尋ねるのは 1 問だけにする、音声側ですでに受け付けたことを繰り返さない、といった指示です。作業の内容、費用、承認が必要な事項も明示します。
音声側に知らせる情報と読み上げる情報
音声側には、次の 3 種類の情報を渡します。
| チャネル | 送信する情報と音声側での使い方 |
|---|---|
| instructions | エージェントの役割、エージェントに作業を依頼する条件、会話のルール |
| thinking | 読み上げずに参照するコンテキスト。直近のメッセージ、タスクの状態、選別したツールのデータ、ユーザーの操作 |
| commentary | 読み上げる回答、質問、タスクの重要な進捗情報 |
thinking チャネルで伝えるのはアプリからのコンテキストです。メインエージェントの内部の推論は含まれません。選別したツールの結果を渡す前に、認証情報がよく格納されるフィールドとバイナリデータを取り除き、サイズを制限し、不完全な結果にはその旨を示す印を付けます。
画面上の操作でエージェントに依頼が送られた場合は、thinking チャネルで音声側に知らせます。これにより、音声側は再確認や再送信をせずに、操作を受け付けたと伝えられます。
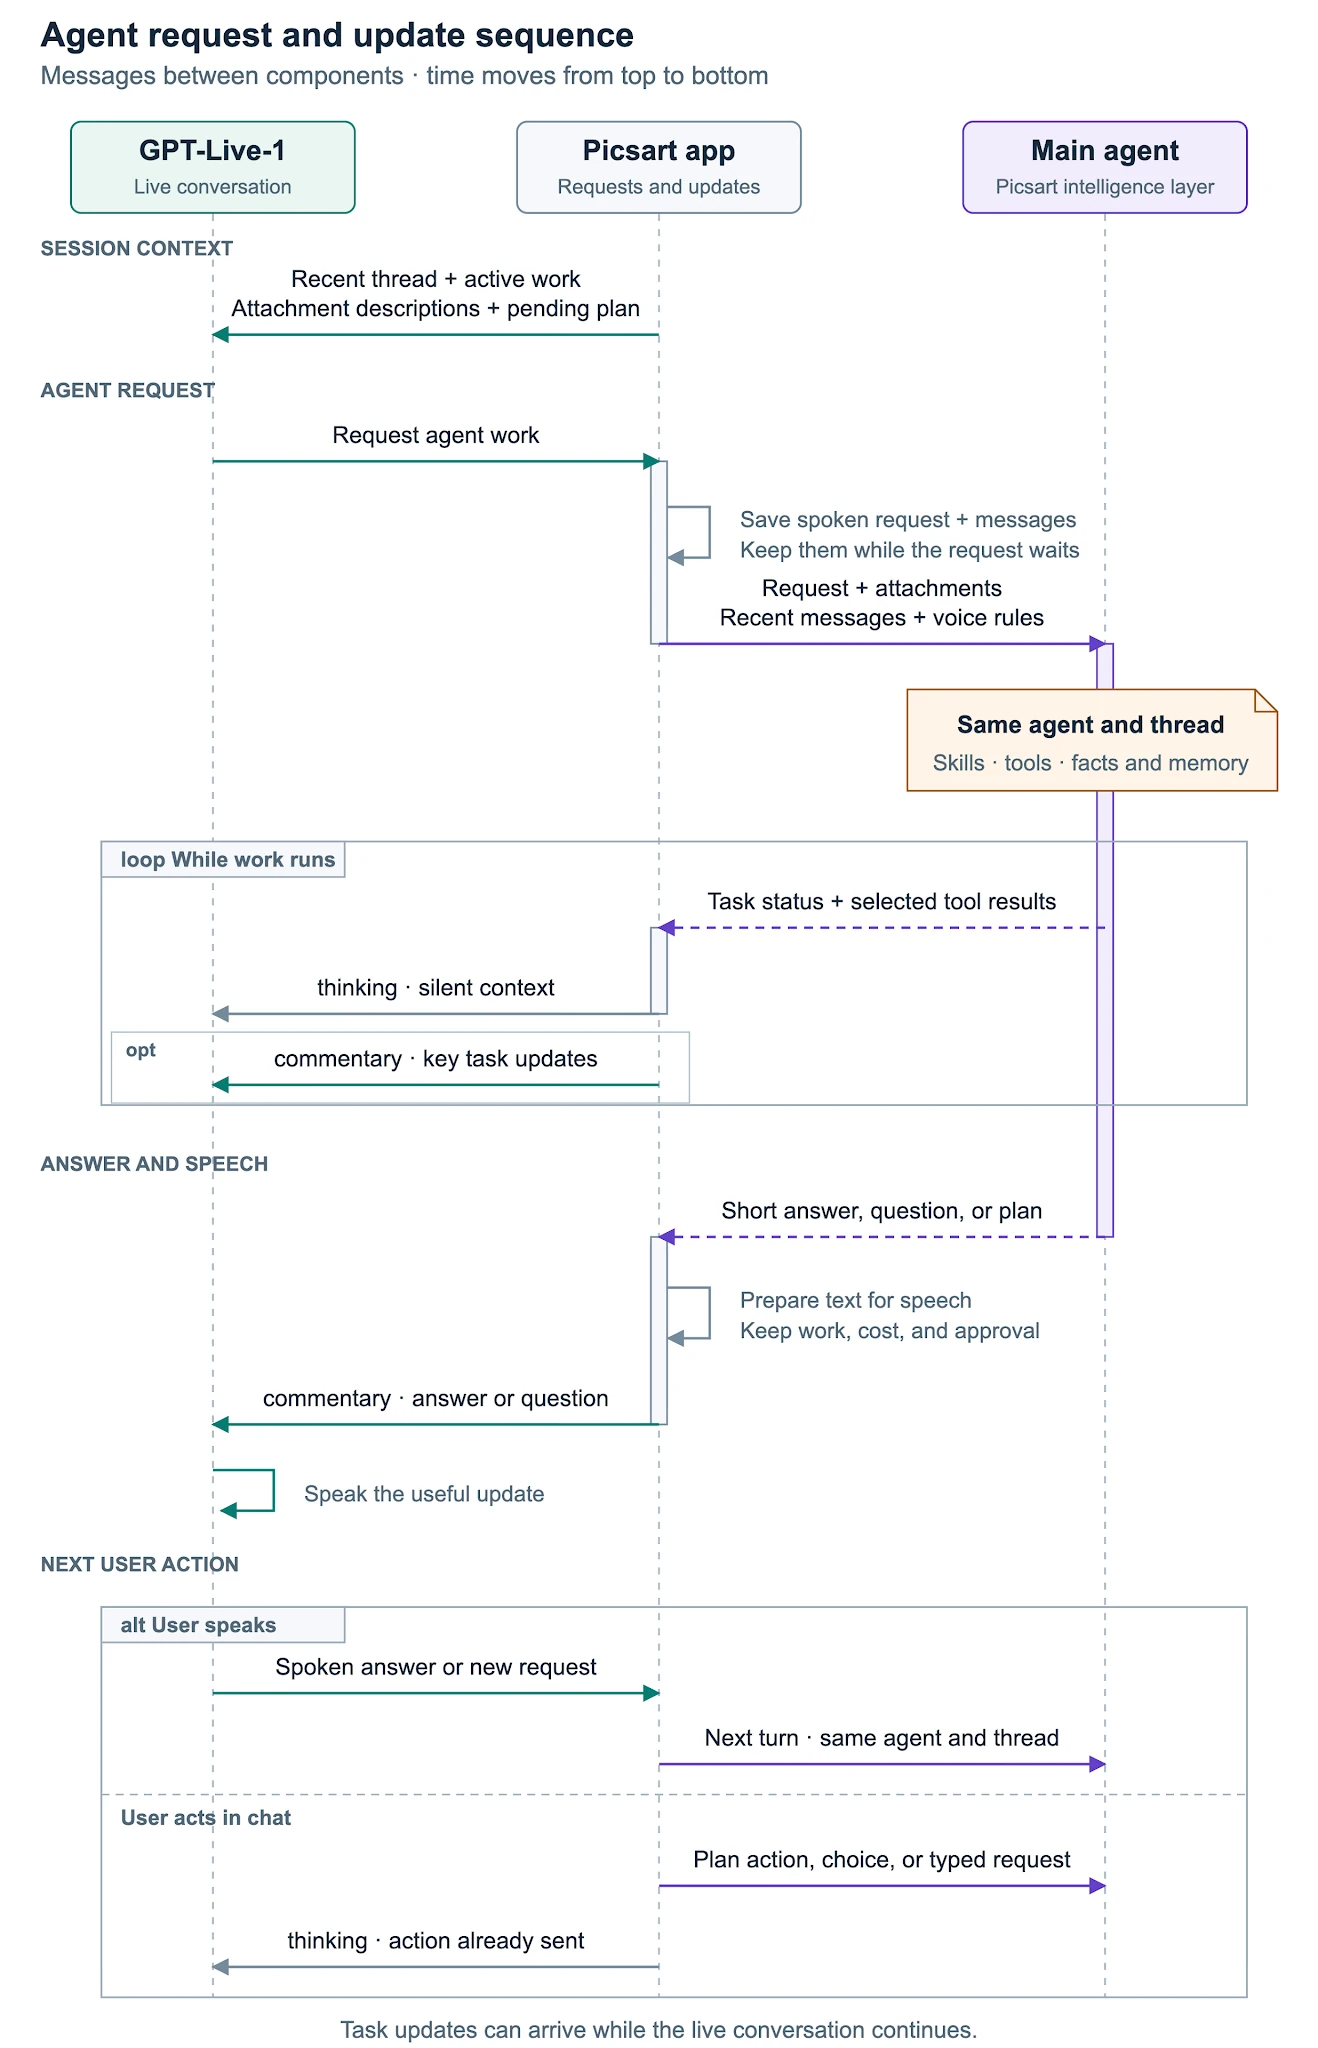
定型的なツール処理の手順は読み上げません。計画の実行開始やタスクの完了は音声で知らせます。ストリーミングで届く回答は文単位にまとめ、会話の切れ目を待って音声側に送ります。最終回答が届いたときは、すでに送った文は繰り返さず、訂正事項や承認を求める質問は確実に伝えます。
通話に引き継ぐ情報と保存する情報
セッションの指示で定めるのはエージェントの役割です。ユーザーについて何を覚えているかは別に管理します。通話開始時に直近のメッセージ、添付ファイルの説明、進行中のタスク、承認待ちの項目を読み込むことで、音声でも前回の続きから話せます。
長期メモリはメインエージェントが管理します。メモリが有効な場合、エージェントはスレッドの履歴や要約、保存済みの事実、ユーザーやプロジェクトごとの設定や好みを利用できます。
ユーザーが「保存しておいたスタイルを使って」と言うと、メインエージェントは該当するスタイルを調べるか、曖昧な点を質問し、回答を音声側に返せます。メモリが利用できない場合も、使えるコンテキストの範囲で通話を続けられます。
スレッドに保存するのは、エージェントへの依頼とそれに添えたメッセージです。音声でのやり取りをすべて記録するわけではありません。雑談の中でユーザーが好みを伝えても、メインエージェントがその情報を受け取って保存した場合にだけ記録に残ります。
作業の開始、継続、停止の条件
計画は、エージェントがその内容を説明してから読み上げます。「作業中です」と伝えるのは、エージェントが開始を確認してからです。提案する作業、その費用、承認を求める質問はまとめて伝えます。コンテキストが追加されても、それだけで作業や支出を増やす許可が与えられたことにはなりません。
進捗通知を取りこぼしたら、既存のタスクの状態を取得し直します。タスクを最初から実行したり、結果や承認の質問をもう一度流したりする必要はありません。
ユーザーが音声を遮ったり、通話を終了したりしても、作業はキャンセルされません。タスクの停止には別の依頼が必要で、すでに進行中の操作は止められない場合があります。新しい依頼は受け付けた時点のコンテキストを保持し、現在のターンが終わるまで待機します。実行中の作業が途中で書き換わることはありません。
開発から学んだこと:音声側には読み上げる以上の情報を
今回の実装から、次のことを学びました。
- メインエージェントで読み上げ用の回答を用意すること
- 依頼ごとに送信時点のコンテキストを保存すること
- 音声、テキスト、画面上の操作でスレッドとルールを共有すること
- 会話とタスクを別々に管理すること
Picsart について
Picsart は、世界中の 1 億を超えるクリエイターや企業がコンテンツを制作し、宣伝し、収益化するための AI メディア制作・配信プラットフォームです。
14 年以上にわたり、次世代の作り手が映像を制作し、その規模を拡大できるよう支援してきました。現在は収益化も支えています。直感的なデザインツール、AI による画像・動画制作、MCP や CLI の機能を組み合わせ、クリエイターが普段使う環境で作業できるようにしています。月間アクティブユーザー数は 1 億を超え、累計ダウンロード数は 25 億回を超えました。Picsart は、作り手が自らの手で創作の規模を広げ、コンテンツを通じて自分らしさを表現し、影響力を高め、事業を立ち上げられる時代を支えています。
Treater:通話の成果を高める音声エージェントの調整
執筆:Britt O’Daly 氏(共同創業者兼 CEO)、Ayaz Hafiz 氏(共同創業者兼 CTO)、Sayd Agzamkhodjaev 氏(ソフトウェア開発者)
成果につながる会話
ある人材紹介会社との通話で、私たちの音声エージェントは、日程調整ソフトを使う採用担当者がどんな問題を抱えているか、経営者に尋ねました。
経営者が以前のソフトではうまくいかなかった理由を説明している間、エージェントは「ええ」「なるほど、なるほど」と何度も口を挟みました。ついに相手は、こう言って話を切り上げました。
とにかく、メールで送ってください。
エージェントは話の内容を理解していましたが、相づちの打ち方で相手に不快な思いをさせてしまいました。営業担当者なら、この経験から学び、次の会話で話し方を変えるでしょう。私たちは、エージェントにも同じことができるようにしたいと考えました。
Treater は、企業が電話、メール、SMS で取引先に連絡し、仕事を進めるのを支援する AI エージェントを開発しています。目指すのは、相手にとって心地よい会話を通じて、お客様の目標を達成することです。そこで、実際の会話を評価し、改善の余地を見つけ、エージェントの新しい設定がどれだけお客様の成果につながるかを検証する学習システムを構築しました。
こちらは、食料品店の欠品を解消するため、エージェントが複数の関係者と連携するデモです。
現場で学ぶエージェント
GPT-Live の導入前は、独自の音声処理システムの構築と保守に多くの時間を使っていました。導入後はそのほとんどを取り払い、シンプルなプロンプトに置き換えたところ、性能も向上しました。お客様の業務では、会話が長く続くほど成果も良い傾向があります。GPT-Live の導入後、会話時間の中央値は 26~30% 延び、90 パーセンタイルでは伸び率が最大 40% に達しました。
お客様が重視する目標の達成率は、平均で 6 ポイント上昇しました。
その分、私たちは「どうすれば自分たちのビールがもっとおいしくなるか」に時間を割けます。この仕事でそれに当たるのは、絶えず変化する環境に適応し、そこから学ぶことです。人が仕事を通じて成長するように、エージェントにも、その現場で何をもって「優れている」とするのかを学んでほしいのです。
エージェントを改善するため、声、プロンプト、話すテンポ、利用可能なツールなど、複数の軸で各エージェントの設定をサンプリングします。すべての会話について、私たちが定めた基準(相手の感情、実行した手順など)と、お客様が定めた基準(希望に沿えたか、目標をどの程度達成できたかなど)の両方で採点します。多腕バンディットを使って、高得点の設定に多くの通話を割り当て、成績の悪い設定は早めに候補から外します。
オフラインでは、レビューシステムが過去の通話記録を読み、新たな設定を提案します。各案を過去の会話で再現し、本番で期待できる報酬を予測して、成果につながりそうにない変更を取り除きます。残った変更はお客様にレビューしていただくか、ご希望に応じて自動でリリースします。
GPT-Live では、こうした設定の多くを簡単に変更できます。声の調子、テンポ、相手のテンションに合わせるかどうか、話し方の丁寧さ、相づちの頻度といった要素は、以前なら音声処理システムの各部を連携させて調整する必要がありました。今では大半がプロンプトの 1 行で設定できるため、変更前後を明確に比較できます。
では、人材紹介会社の経営者との通話から、エージェントは何を学んだのでしょうか。デモで見てみましょう。
このデモは、冒頭で紹介した営業活動を匿名化し、簡略化したものです。ある企業が基本設定のエージェントから始めて、人材紹介会社に製品デモの予約を取り付けます。
- 改善の余地を発見。 オフラインのレビューで報酬の低かった通話を調べたところ、通話の 20% で経営者の発言にエージェントの相づちがかぶるなどの傾向が見つかりました。システムは新しい設定を 4 つ提案しました。
- 改善案を検証。 各案を過去の通話でシミュレーションし、本番と同じ基準で報酬を算出しました。話すペースを落とした案はスコアが低く、すぐに除外されました。残りの案はレビューを経て承認されました。
- 本番で評価。 新しい各バージョンには期待報酬に応じて通話を割り当てます。1 日以内に、通話の大半をバージョン B が受け持つようになります。バージョン C は差を縮められず、3 日目に停止します。2 日目に追加したバージョン D が 3 日目の初めには首位に立ち、最終的には通話の約 90% を担当します。状況の変化に備え、A と B にも少数の通話を引き続き割り当てます。通話 100 件あたりのデモ予約数は 3.0 件から 4.3 件に増えました。
このシステムで重要なのは階層構造です。共通のハーネスを改善すれば、すべてのユースケースに効果が及びます。あるワークフローで学んだことは、似たワークフローの出発点になります。
私たちが大切にしている教訓
- すべては仮説です。特にはっきりした成果が出た例では、お客様は近日開始する販促キャンペーンから話を切り出したいと考えていましたが、実際には、最近その商品の消化率が上がったことから始めた通話のほうが、はるかに良い結果を出しました。
- 改善の手がかりが多く、事業にも実際に影響する成果を報酬の基準にします。新規契約の成立など、結果が出るまで時間がかかる場合は、次回の商談予約のように短時間で測れる報酬を用意し、最終的な成果との関連を検証します。
- エージェントが働く環境を観測し、測定できる仕組みに投資します。シミュレーションやベンチマークが意味を持つには、現場で起きることとその頻度を正確に反映する必要があります。
- GPT-Live では、言動を細かく指定する代わりに、どういう会話を目指すのかを描写する方法も試してみてください。GPT-Live のエージェントは、完全な台本がなくても、状況と大まかな指針に合わせて柔軟に応答できます。
GPT-Live を使い始めてから、会話の質が一段と向上する瞬間を何度も経験してきました。この先さらに十段上ったとき、どんな会話ができるようになるのか楽しみです。
Treater について
Treater は、実際の相手と対話してお客様のビジネス目標の達成を支えます。一件一件を、お客様にとって最大の商機と同じように大切にしています。私たちのプラットフォームでは、数千もの異なるエージェントが数十万件の通話を担っています。過去 1 年間、通話件数は前月比 25% のペースで増えてきました。上場企業から急成長中のスタートアップまで、幅広いお客様にご利用いただいています。詳しくは trytreater.com をご覧ください。
Weekend:Wit’s End の 1 つのシーンを演じる 2 人の GPT-Live キャラクター
執筆:Kevin Shen 氏(シニアソフトウェアエンジニア)、James Wilsterman 氏(Weekend 共同創業者兼 CTO)
開発の出発点
私たちが開発している Wit’s End は、音声で遊ぶファンタジーのテーブルトップゲームです。AI ゲームマスターのサー・バートが物語を語り、ルールに沿ってゲームを進めます。プレイヤーは話すだけです。GPT-Live の全二重音声によって、実際にテーブルを囲んでいるような感覚が生まれました。プレイヤーが口を挟んだり、冗談を言ったり、言い合ったりすると、サー・バートはその話が終わる前から反応します。
弱点は登場人物の演じ分けでした。1 つの GPT-Live セッションで使える声は 1 つなので、町の門を守る無骨な隊長も、酒場でおびえる老婦人も、語り手と同じ声でした。プレイヤーが何を言っても物語は結末にたどり着く。ゲームを成り立たせているこの仕組みを保ちながら、各シーンの中心人物には、それぞれの声と個性で話してほしいと考えました。
現在のゲームでは、こんなふうにシーンが進みます。一行がティンバーフォールの門に着くと、サー・バートが情景を描いて言葉を切ります。「表情を変えずに見張りに立つ衛兵たち。その隊長が剣に手をかけたまま歩み出て、君たちをじろりと見渡す」。続けて、ドミトリ隊長が低くしゃがれた声で話し始めます。彼が追っているのはジェイドという名の裏切り者で、一行はその共犯者の人相書きに似ています。プレイヤーの一人が反論すると、ドミトリも言い返します。別の一人が隊長にそっと金貨を握らせます。そこでサー・バートが割って入り、ダイスを振ることを告げ、賄賂が効いたかどうかを語ります。再び出番が回ってきたドミトリが、その結果を受けて反応します。
2 つの声を切り替える 1 つのディレクター
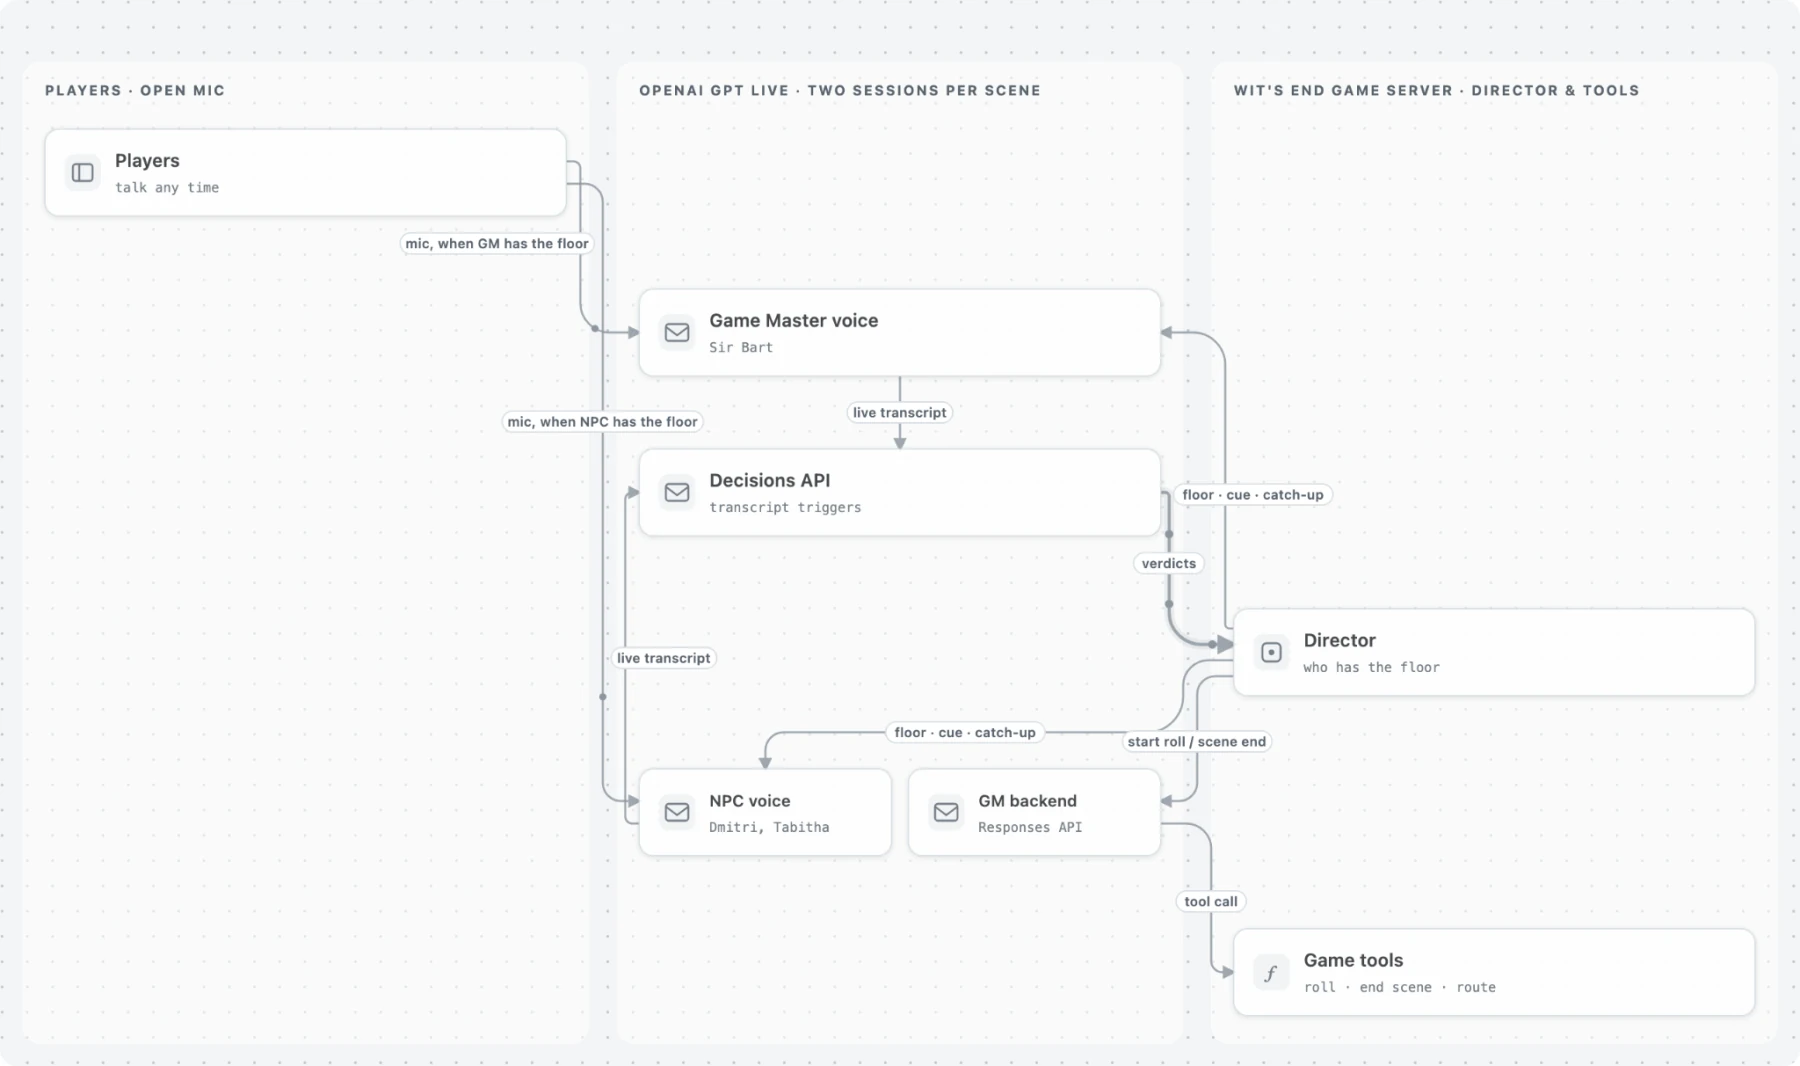
発言権の切り替え。ディレクターは両セッションの文字起こしに対する Decisions API の判定から、次に誰が話すかを決めます。2 つの声の間で発言権を移し、ゲームマスターのバックエンドでダイスロールやシーンの終了処理を開始します。
各シーンでは、サー・バート用と、その場に登場するキャラクター用(門ではドミトリ、酒場ではタビサ)の 2 つの GPT-Live セッションを並行して動かします。それぞれが専用のプロンプトとカスタム音声を持ちます。ゲームサーバー上のディレクターがどちらに発言権があるかを決め、発言権を持つ側だけにプレイヤーの声が届きます。両方のセッションで Decisions API の文字起こしに設定したトリガーが、会話の状況をディレクターに知らせます。ダイスロール、シーンの終了、ルート選択などのゲームツールを呼び出せるのは、Responses モデルを使うゲームマスターのバックエンドだけです。
2 つの個性で進める 1 つの物語
キャラクターの設定は、その人物に固有の部分と、ほかの登場人物と共有する部分に分けます。
性格は各キャラクター専用のプロンプトに記述します。
各プロンプトには声の特徴も記述します。そこには、その声を設計したときと同じ言葉を使います。
シーンを共有する例
シーンの設定は共通です。サー・バートと登場人物に、同じ対立の構図、その解決方法、物語の要点を渡し、要点ごとに誰がそれを口にするかを指定します。ドミトリは名を名乗り、誰を追っているかを話します。タビサは、ジェイドが一行と落ち合う場所を教えます。すべての要点をそれぞれ担当する人物が口にするまで、ゲームはそのシーンを終えません。
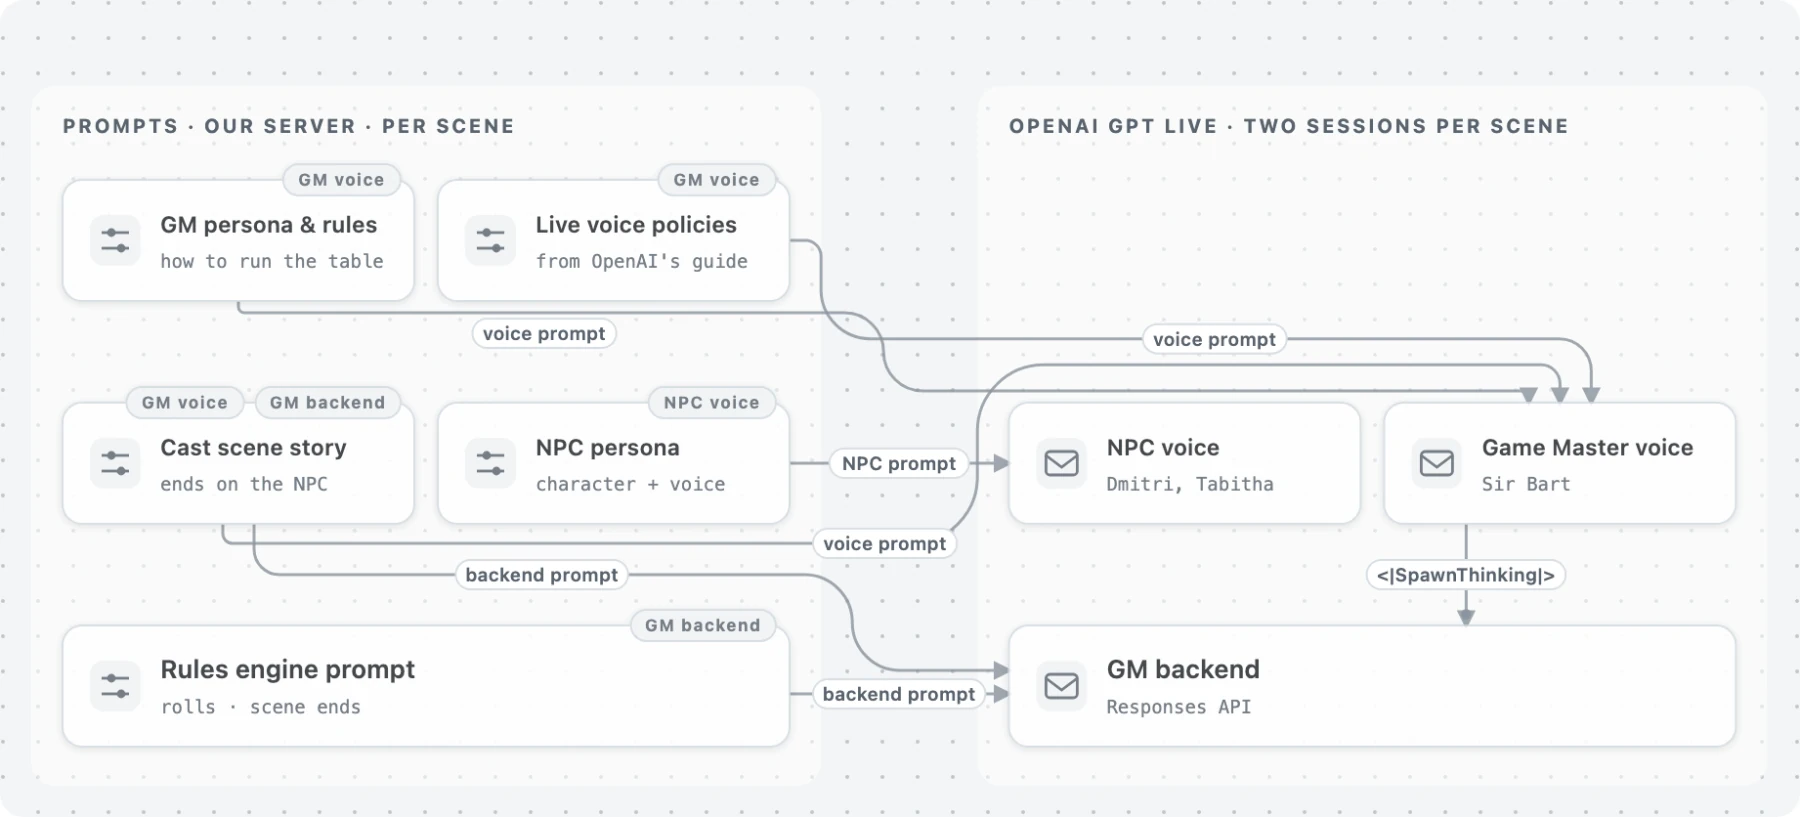
プロンプトの構成。サー・バートの音声セッションとバックエンドは、そのシーンの物語を共有します。登場人物には、その人物像を定めた専用のプロンプトを渡します。
キャラクターのプロンプトから抜粋
あなたは、声で繰り広げられるライブシーンの登場人物の一人です。
世界の描写は語り手が担当します。あなたが声に出して話すときは、必ず自分自身の言葉で、一人称で話してください。
- ナレーションをしたり、自分の動作や声を描写したりしないでください。旅人たちや語り手に代わって話すことも禁止です。
- 危険を伴う試みが成功したかどうかは、決して自分で決めないでください。短い一言で反応し、そこで止めてください。結果は語り手が決めます。
- 旅人から話しかけられたときか、発言権を渡されたときだけ話してください。
ディレクターによる次の話者の判定
ディレクター自体は音声を生成しません。順次届く文字起こしの断片に対する Decisions API の判定を使い、プレイヤーが誰に話しかけているか、その行動にダイスロールが必要か、ナレーションやキャラクターの最後のセリフが話者交代の合図になっているかを見極めます。

判定はプレイヤーが話すにつれて変化します。誰に話しかけたかはターン終了時の確定判定を待ちますが、リスクを伴う行動は認識した時点でゲームマスターに送ります。
場面ごとの次の話者
| 条件 | 次の話者 |
|---|---|
| サー・バートのナレーションが終わり、交代の合図を示すスコアが 0.6 以上の場合、またはセリフの末尾が発話を表す動詞で終わる場合(例:「Tabitha calls after you」) | キャラクター |
| サー・バートに発言権がある間に、プレイヤーがキャラクターに話しかけた場合 | キャラクター。返答すべき発言も一緒に渡します。 |
| プレイヤーが賄賂、うそ、こっそり通り抜けること、戦闘など、リスクのある行動を試みた場合 | 必要なら発話の途中でも、すぐにサー・バートに切り替えます。ディレクターがサー・バートのバックエンドでダイスロールを開始し、サー・バートが結果を語って発言権を戻します。 |
| プレイヤーが語り手に質問した場合、または自分のキャラクターの行動を説明した場合 | サー・バート |
| プレイヤー同士で話している場合 | 誰も応答しません。発言権を持つ側に、今回は口を挟まないよう指示を送ります。 |
| キャラクターが自分の出番を終えるセリフを言った場合(例:「さあ、行け。目立つんじゃないぞ」) | キャラクターが言い終わったらサー・バートに切り替えます。ディレクターがサー・バートのバックエンドでシーンの終了処理を開始します。 |
| 発言権を渡された側が 2.5 秒間沈黙した場合 | 同じ話者にもう一度発言を促します。 |
話者を切り替える手順
話者を切り替えるときは、次の 4 つの処理を行います。
- 発言権を手放すセッションをミュートし、発話の停止を指示して、キュー内の音声をすべて破棄します。
- 新たに発言権を持つセッションに、聞いていなかった間のやり取りを
session.thinking.appendで読み上げないコンテキストとして渡します。そのセッションの Decisions のコンテキストにも同じ発言を渡し、トリガーが同じ履歴を基に判定できるようにします。 - 新しい話者のミュートを解除し、発言の合図を出します。
- 話者交代にプレイヤーの声がかぶらないよう、新しい話者が最初の一文を言い終わるまで、最大 8 秒間、プレイヤーのマイク入力を保留します。
キャラクターのセッションはすでに起動しているので、話者の切り替えから最初の音声が届くまで平均 0.84 秒です。新しくセッションを起動する場合は 1.54 秒かかります。
物語を結末まで進める仕組み
各話者は即興で演じます。いつ何を起こすかはアプリが決めます。
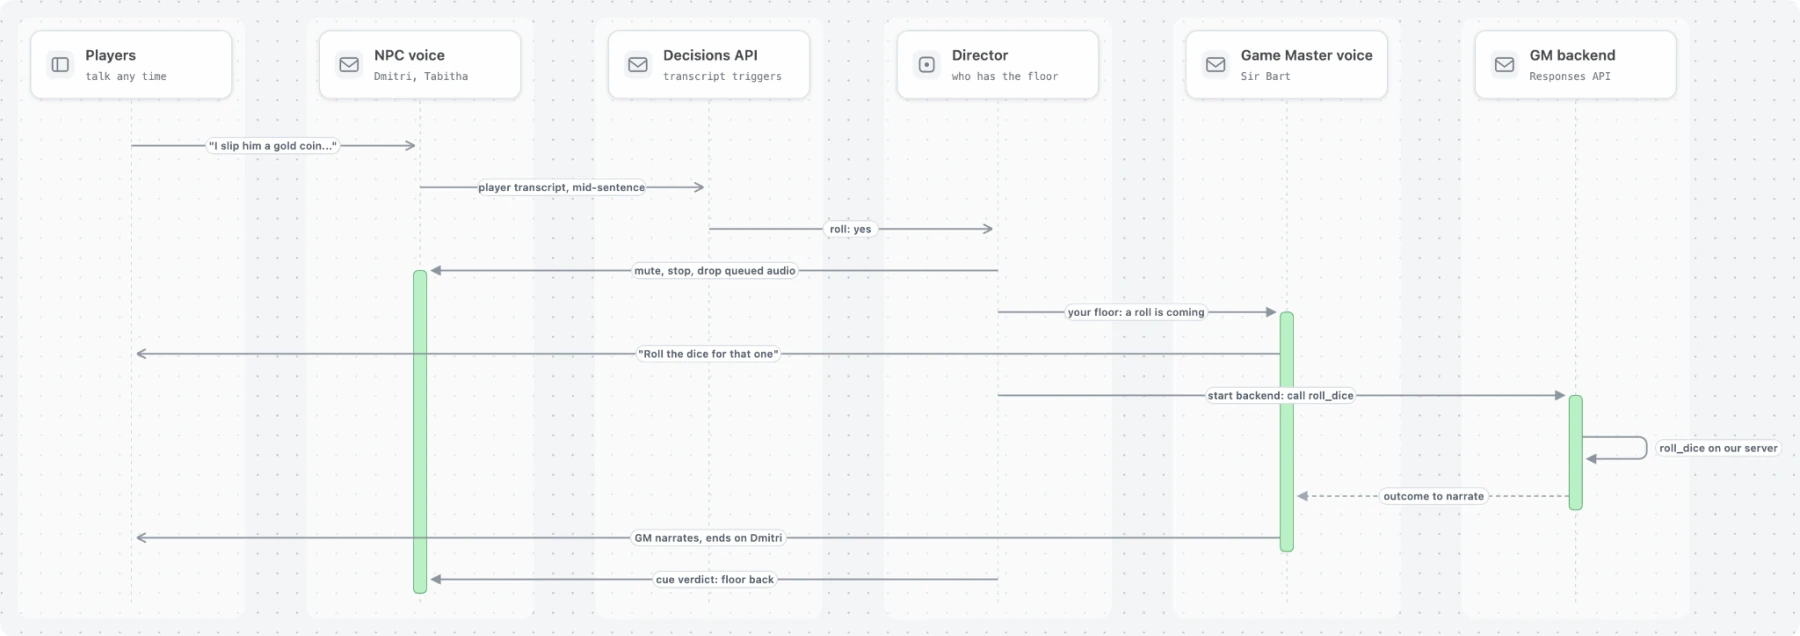
ドミトリに発言権があるときに賄賂を渡す例。プレイヤーが話し終わる前にダイスロールが必要との判定が届くと、ディレクターはサー・バートに発言権を渡し、そのバックエンドでダイスロールを開始します。サー・バートが結果を語り終えると、交代の合図を検知して発言権がドミトリに戻ります。
- ダイスロールやシーンの終了処理はディレクター自身が開始します。 あるプレイテストで、サー・バートは「それにはダイスを振ってもらわないとな」と言いながら、バックエンドに処理を渡しませんでした。ダイスは振られず、サー・バートが結果を作り上げてしまったのです。現在はディレクターがサー・バートのバックエンドで直接レスポンスを開始します。処理中は音声側が短い一言を挟み、処理が終わると結果を語ります。
- 各シーンの決着はダイスがつけます。 シーン 1 はダイスロールが成功すると終了します。一度もダイスを振らないうちにドミトリが折れた場合、ディレクターはシーンを終えず、プレイヤーの試みをダイスで判定します。
- キャラクターは自分の出番を終えられます。シーンを締めくくるのはゲームマスターです。 タビサが一行に、ジェイドとは精霊の祭壇で落ち合えると告げると、ディレクターはサー・バートに発言権を渡します。サー・バートのバックエンドがシーンを完了として記録し、サー・バートが先へ進む 2 つの道を示します。
開発から学んだこと
- プレイヤーの声を聞くのは 1 つのセッションだけにします。 両方に音声を届けていたときは、テストのセリフを言うたびに両方が答え、しばしば矛盾が生じました。ドミトリが賄賂を突き返す一方で、ゲームマスターは彼が金貨を懐に入れたと語ったのです。
- ミュートだけではセッションの発話は止まりません。 停止を指示し、キュー内の音声も破棄します。発言権を戻すときは「黙っていて」という指示を明示的に解除します。これを解除し忘れたゲームマスターは、シーンが終わるまで誰にも答えませんでした。
- 使う声はすべて、すぐに話せる状態にしておきます。 音声はセッションの起動時に決まるため、声ごとに専用のセッションが必要です。シーンの開始と同時にキャラクターのセッションを起動すれば、交代のたびに約 0.7 秒短縮できます。この差で、気まずい沈黙を挟まずに話者を切り替えられます。
- 判定は用途に合ったタイミングで使います。 プレイヤーが話している間にも判定は届き、最後の判定が届くのは、話し終わってから中央値で 0.19 秒後です。リスクのある行動は、認識したらすぐにゲームマスターに送ります。誰に向けた発言かは、ターンの終了時に判定が確定してから決めます。
- はい・いいえで答える問いは真偽判定にし、実際のセリフでしきい値を決め、補助用の単純なルールも残します。 「Should Dmitri speak next?」は、真偽判定にすると 12 件中 11 件、二者択一では 12 件中 8 件が正解でした。しきい値が 0.4 のときは、「You’re going to have to roll the dice for that one」が交代の合図と判定され、ダイスロールの途中でドミトリに発言権が移ってしまいました。本物の合図のスコアは 0.94 以上だったので、しきい値には 0.6 を使っています。一方、「Tabitha calls after you」のスコアは 0.04 でした。そこで、ナレーションがキャラクターのセリフの直前で終わるケースを拾うため、末尾に発話を表す動詞があるかもチェックします。
- 結果ごとに、それを決める役割を 1 か所に定めます。 ツールを呼び出せるのはゲームマスターのバックエンドだけで、ダイスロールやシーンの終了処理を開始するのは音声側ではなくアプリです。この役割分担によって、ゲームのルールを守りながら、各キャラクターが自由に即興で演じられます。
著者と会社について
Weekend のチームは、ブラウザやテレビで声を使って遊ぶファンタジーのテーブルトップゲーム Wit’s End を開発しています。AI ゲームマスターが物語を進めるので、プレイヤーは話すだけで参加できます。witsend.ai でプレイできます。
Weekend(旧 Volley)は、家族がテレビを見て過ごす時間を、一緒に声を出して遊ぶ時間に変えられるよう、音声で操作するテレビ向けゲームを開発しています。Jeopardy!、Wheel of Fortune、Song Quiz、Wit’s End など 25 本以上のゲームが Roku、Fire TV、Samsung および LG のテレビで動作し、これまでに 3,000 万を超える家庭で遊ばれています。Weekend は Microsoft の M12、Lightspeed Venture Partners、Y Combinator から出資を受けています。
音声エージェントのこれから
音声の次のステップは、会話をさらに自然にすることだけではありません。作業を進めながら人の話を聞き続け、インターフェースをまたいでコンテキストを引き継ぎ、話の筋を見失わずに複数の声を連携させるソフトウェアが見えてきました。聞くことと話すことを同時にできる GPT-Live は、人が発言の順番を待たずに、会話本来のリズムでやり取りできる体験を作るための基盤になります。
4 社の事例は、その実現にどんな工夫が必要かを示しています。Juno は実際に使う人と一緒に声を評価し、Picsart は会話とバックグラウンドの作業を同期させ、Treater は実際の通話から学んでいます。Weekend はゲームの進行を制御しながら、一人ひとりのキャラクターに固有の声を与えています。
GPT-Live によって、ソフトウェアを直感的に使う方法が増え、エージェントにできることも広がります。話しながら制作のアイデアを形にしたり、進行中の作業に方向を示したり、物語の中に入ってその先の展開を変えたりできます。会話がソフトウェアの仕組みの一部になれば、開発者は何を作れるのか。ここで紹介した事例は、その始まりにすぎません。
独自の体験を開発するには、GPT-Live 入門ガイドと作業の委任とツールのドキュメントをご覧ください。