
GPT-5 を公開した今、アプリケーションに GPT-5 を組み込む最適な方法である Responses API について、設計の背景をお伝えします。なぜ Responses はリーズニングモデルに適しているのか、そしてエージェントが活躍するこれからの時代をどう見据えているのかを紹介します。
OpenAI がどの世代の API を設計するときも、出発点は同じ問いでした。開発者がモデルとやり取りするには、どんな方法が最もシンプルで、モデルの力を最も引き出せるでしょうか。
私たちは一貫して、モデルそのものの動作に合わせて API を設計してきました。最初のエンドポイント /v1/completions はシンプルでしたが、できることは限られていました。プロンプトを渡すと、モデルはその続きを書くだけでした。開発者はフューショットプロンプティングなどの手法を使って、JSON を出力したり質問に答えたりするようモデルを誘導しようとしましたが、当時のモデルの能力は、今では当たり前になった水準に遠く及びませんでした。
やがて RLHF と ChatGPT が登場し、事後学習の時代が始まりました。モデルは書きかけの文章を完成させるだけでなく、会話の相手として応答するようになりました。この変化に合わせて開発したのが /v1/chat/completions です(ひとつの週末だけで開発したのは有名な話です)。system、user、assistant といったロールを用意し、開発者が独自の指示やコンテキストを組み込んだチャットインターフェースをすぐに構築できるようにしました。
モデルは進化を続け、やがて画像を見たり、音声を聞き取ったり、話したりできるようになりました。2023 年後半に登場した Function Calling は、特に好評な機能のひとつになりました。同じ頃、Assistants API のベータ版を公開しました。Code Interpreter やファイル検索などのホスト型ツールを備え、エージェントが一連の作業を自律的に進められるインターフェースを目指した、私たちにとって初めての試みでした。一部の開発者には好評でしたが、Chat Completions に比べて API 設計上の制約が多く、導入も難しかったため、広く普及するには至りませんでした。
2024 年後半には、両者の長所をひとつにまとめる必要があることが明らかになりました。Chat Completions と同じくらい手軽に使え、Assistants と同じくらい高機能で、しかもマルチモーダルモデルとリーズニングモデルに合わせて設計した API が必要でした。こうして生まれたのが /v1/responses です。
/v1/responses によるエージェントの推論と行動のループ
Chat Completions は、交互に発言するシンプルなチャットインターフェースを提供します。一方、Responses は、推論と行動を繰り返すための構造を提供します。探偵に調査を依頼する場面を想像してみてください。証拠を渡すと、探偵は調査を進め、必要に応じて専門家(ツール)に相談し、最後に結果を報告します。探偵は自分用のメモ(推論状態)を次の調査ステップに持ち越しますが、そのメモを依頼人に渡すことはありません。
ここでリーズニングモデルの力が発揮されます。Responses はターンをまたいでモデルの推論状態を保持します。Chat Completions では呼び出しのたびに、それまでの推論が失われます。探偵が部屋を出るたびに手がかりを忘れてしまうようなものです。Responses ならノートを開いたまま、それまでの思考の過程を次のターンに引き継げます。その効果はベンチマークのスコア(TAUBench で 5% 向上)に表れているほか、キャッシュ利用効率の向上やレイテンシの低減にもつながっています。
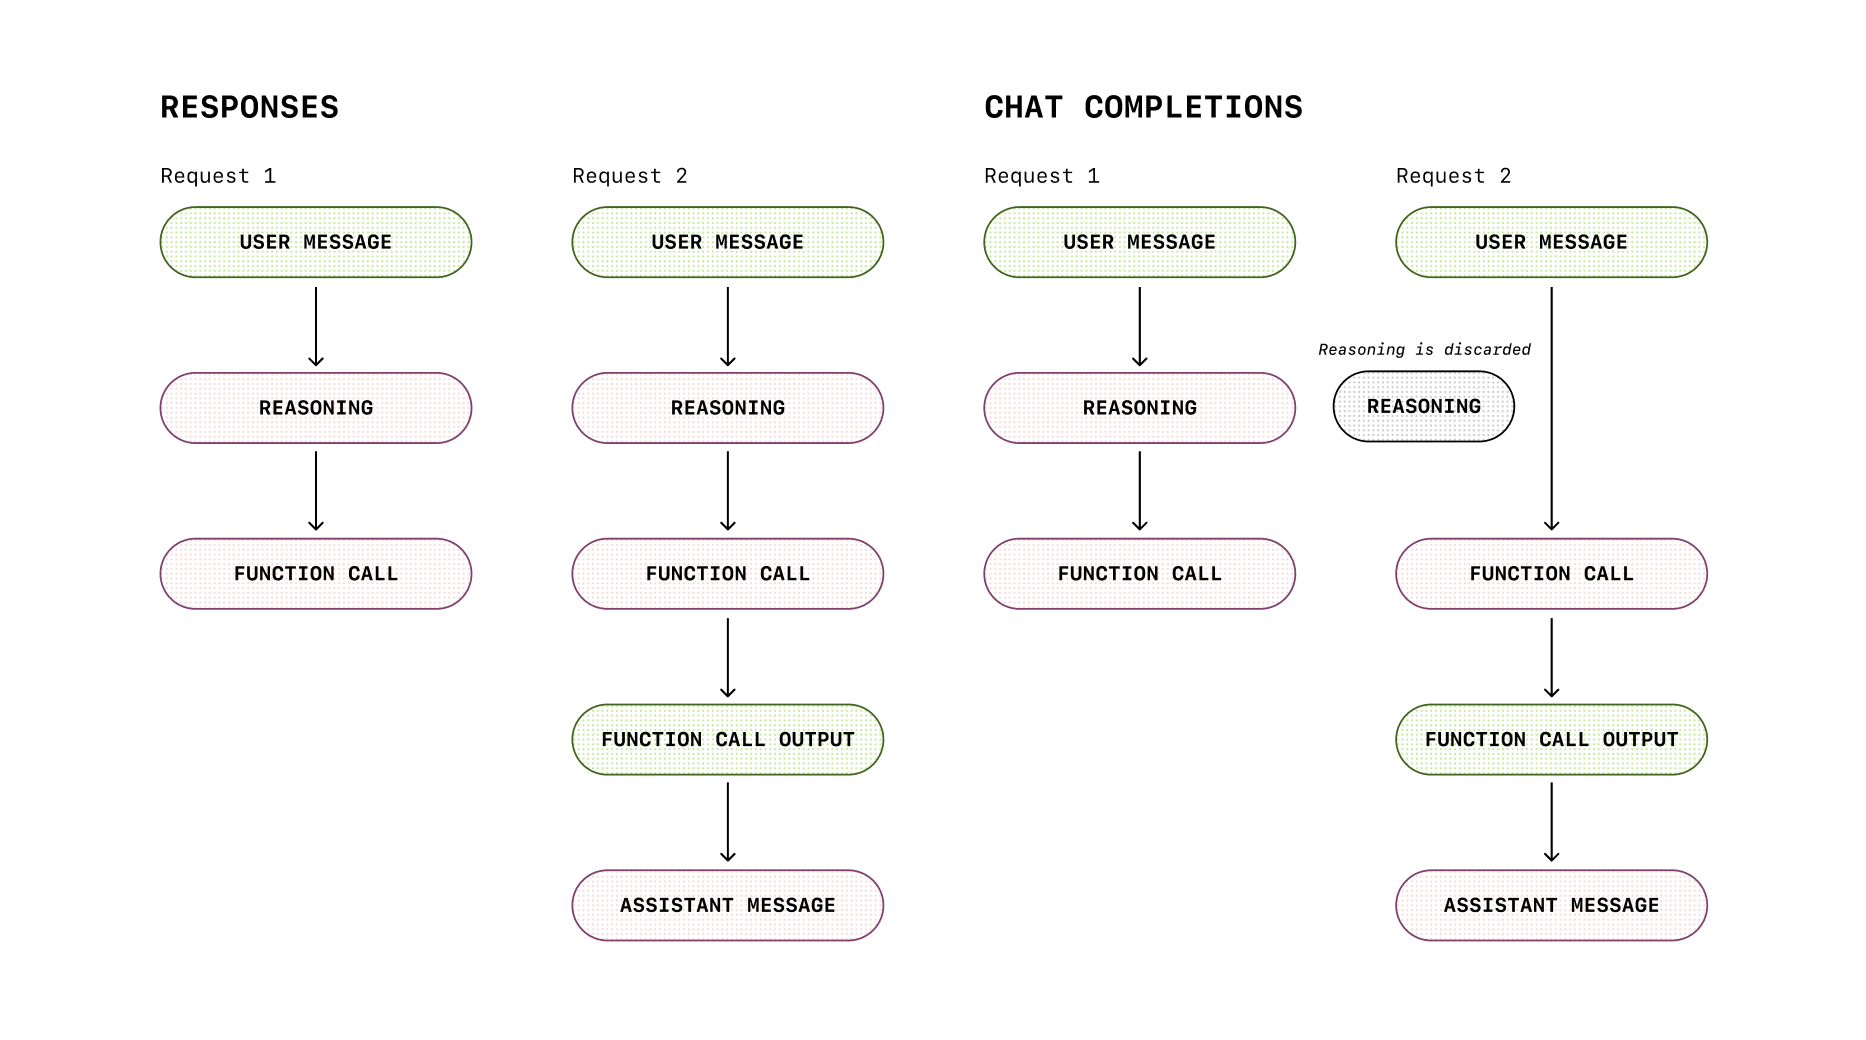
Responses は複数の項目を出力できるので、モデルが何を言ったかだけでなく、何をしたかもわかります。ツール呼び出し、構造化出力、途中のステップが記録として手元に残ります。完成した答案と、そこに至るまでの計算メモを一緒に受け取るようなものです。こうした記録は、デバッグや監査、より多くの情報を伝える UI の構築に役立ちます。
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},ホスト型ツールによる実装負担の軽減
Function Calling の登場当初、開発者の使い方にひとつの傾向が見えてきました。モデルに API を呼び出させるだけでなく、文書ストアを検索させて外部のデータを取り込んでいたのです。後者は現在、RAG と呼ばれています。ただ、これから始める開発者にとって、検索パイプラインを一から構築するのは難しく、コストもかかります。そこで Assistants では、初のホスト型ツールとして file_search と code_interpreter を導入しました。これにより、モデルは RAG を利用したり、コードを書いたりして、依頼された問題を解決できるようになりました。Responses ではさらに、ウェブ検索、画像生成、MCP を追加しました。Code Interpreter や MCP などのホスト型ツールはサーバー側で実行されるため、呼び出しのたびに開発者自身のバックエンドを経由する必要がなく、レイテンシと往復通信のコストを抑えられます。
推論を安全に保持する仕組み
なぜ、そこまで手をかけてモデルの生の思考の連鎖(CoT)を隠すのでしょうか。CoT をそのまま公開し、クライアントが他のモデル出力と同じように扱えるようにした方が簡単ではないでしょうか。端的に言えば、生の CoT の公開にはいくつものリスクが伴います。ハルシネーションや、最終的な回答には現れない有害な内容が含まれる可能性があり、OpenAI にとっては競争上のリスクも生じます。
昨年後半に o1-preview を公開した際、OpenAI のチーフサイエンティスト Jakub Pachocki はブログにこう記しました。
私たちは、非公開の思考の連鎖が、モデルの挙動を監視するうえで他にはない機会をもたらすと考えています。思考の連鎖が実際の推論を忠実に反映し、人間にも読み解けるなら、それを通じてモデルの「心を読む」ように思考の過程を理解できます。たとえば将来、思考の連鎖を監視して、モデルがユーザーを意図的に操ろうとしている兆候を捉えたいと考えるかもしれません。ただし、そのためには、モデルが自分の考えをありのままに表現できる必要があります。したがって、思考の連鎖そのものがポリシーに従ったり、ユーザーの好みに合ったりするようにモデルを訓練することはできません。また、人間の意図に沿うよう調整されていない思考の連鎖を、ユーザーに直接見せたいとも考えていません。
Responses では、次のように対応しています。
- 推論状態を暗号化して内部に保持し、クライアントからは見えないようにしています。
previous_response_idまたは推論項目を使うことで、生の CoT を公開せずに推論を安全に続けられます。
/v1/responses が開発に最適な理由
Responses の設計では、状態の保持、マルチモーダル対応、効率性を重視しました。
- エージェントによるツールの活用。 Responses API では、ファイル検索、画像生成、Code Interpreter、MCP などのツールを簡単に組み込めるため、エージェントがワークフローで実行できる作業の幅が広がります。
- デフォルトで状態を保持。 会話とツールの状態が自動的に追跡されるため、推論や複数ターンにわたるワークフローを格段に扱いやすくなります。Responses 経由で GPT-5 を利用すると、保持された推論状態を活用するだけで、TAUBench のスコアが Chat Completions 経由の場合より 5% 向上します。
- 設計段階からのマルチモーダル対応。 テキスト、画像、音声、関数呼び出しをすべて同等に扱います。テキスト用の API に他のモダリティを後付けしたわけではありません。家にたとえるなら、最初から必要な数の部屋を用意して設計しました。
- コストの削減とパフォーマンスの向上。 社内ベンチマークでは、Chat Completions と比べてキャッシュ利用効率が 40~80% 向上しました。これにより、レイテンシとコストの両方を抑えられます。
- 使いやすさを高める設計。 Chat Completions API と Assistants API の両方から学んだことを活かし、Responses API と SDK に、開発者の手間を減らす細かな改善を加えました。たとえば、次のようなものがあります。
- 何が起きたかをイベントの種類で識別できるストリーミング
- データ内部のタグで型を識別するポリモーフィズム
- SDK の
output_textヘルパー(choices.[0].message.contentへのアクセスが不要に) - マルチモーダル処理と推論に関するパラメータの整理
Chat Completions の今後
Chat Completions は今後も利用できます。用途に合っていれば、そのままお使いください。一方、推論を次のターンに引き継ぎたい、複数のモダリティを自然に組み合わせてやり取りしたい、あるいは個々の処理を自力でつなぎ合わせずにエージェントのループを構築したい場合は、Responses が適しています。
今後の展望
Chat Completions が Completions に取って代わったように、今後は Responses が、開発者にとって OpenAI のモデルを使った開発の標準になると考えています。シンプルな用途には手軽に使え、高度な機能が必要なときにはその力を引き出せます。これからどのような新しい手法が登場しても対応できる柔軟性も備えています。
私たちは今後も、この API を基盤に開発を進めていきます。