
AI の音声機能により、これまでにないユーザー体験が可能になります。今年は、開発者がこうした体験を実現できるよう、gpt-realtime をはじめとする複数の音声モデルと API の新機能をリリースしました。
先週、信頼性の高い音声エージェントを構築する際によく直面する課題に対応するため、音声モデルの新しいスナップショットをリリースしました。文字起こしや音声合成から、ネイティブの音声変換でリアルタイムに応答するエージェントまで、本番環境での音声処理の信頼性と品質を高めています。
今回リリースしたスナップショットは次のとおりです。
gpt-4o-mini-transcribe-2025-12-15:文字起こし API または Realtime API を使った音声のテキスト化gpt-4o-mini-tts-2025-12-15:Speech API を使ったテキストからの音声合成gpt-realtime-mini-2025-12-15:Realtime API を使ったリアルタイムのネイティブ音声変換gpt-audio-mini-2025-12-15:Chat Completions API を使ったネイティブ音声変換
新しいスナップショットに共通する改善点は次のとおりです。
音声入力
- 実環境で収録した音声や雑音を含む音声での単語誤り率の低下
- 無音時や背景雑音がある場合のハルシネーションの減少
音声出力
- より自然で安定した出力音声(Custom Voices を使う場合も含む)
料金は従来のスナップショットと同じです。同じ料金でより高い性能を利用できるため、新しいスナップショットへの切り替えをおすすめします。
音声エージェントやカスタマーサポートシステム、ブランド独自の音声体験を開発している方は、今回の更新によって本番環境での動作をより安定させることができます。ここからは、具体的な変更点と、実際の音声処理でどのような改善が見られるかを紹介します。
音声変換
ツール呼び出しと指示への追従性能を高めた新しい Realtime mini モデルと Audio mini モデルの提供を開始します。mini モデルとフルサイズモデルの性能差が縮まり、用途によっては mini モデルに切り替えてコストを抑えられます。
gpt-realtime-mini-2025-12-15
gpt-realtime-mini は、低レイテンシでネイティブのマルチモーダル対話を実現する Realtime API 向けのモデルです。音声のストリーミング入出力や、ユーザーが話に割り込んだときの処理に対応し、必要に応じて音声区間検出も利用できます。また、モデルが話し続けている間にバックグラウンドで Function Calling を実行できます。
新しい Realtime mini のスナップショットでは、指示への追従とツール呼び出しの精度が明らかに向上し、リアルタイムエージェントにより適したモデルになりました。音声変換の社内評価では、前のスナップショットに比べて、指示に正しく従えた割合が 18.6 ポイント、ツールを正しく呼び出せた割合が 12.9 ポイント上昇しました。Big Bench Audio ベンチマークでも性能が向上しています。
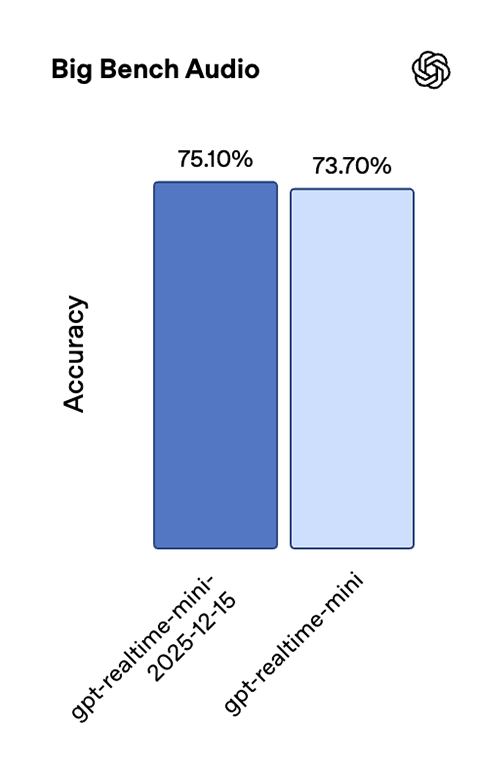
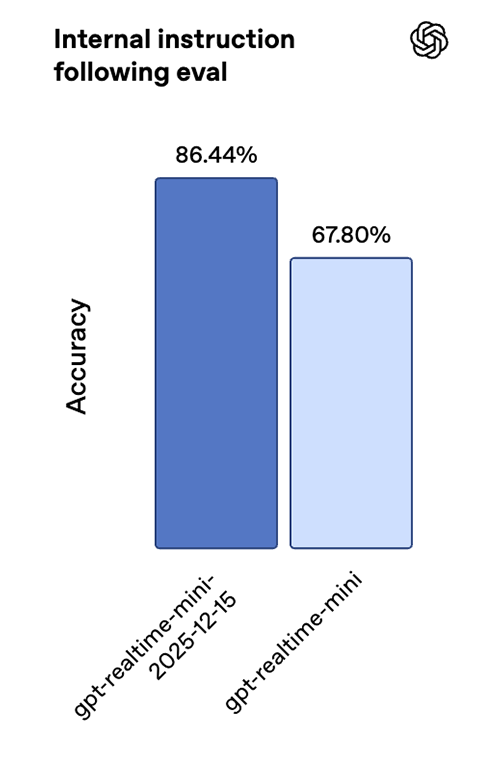
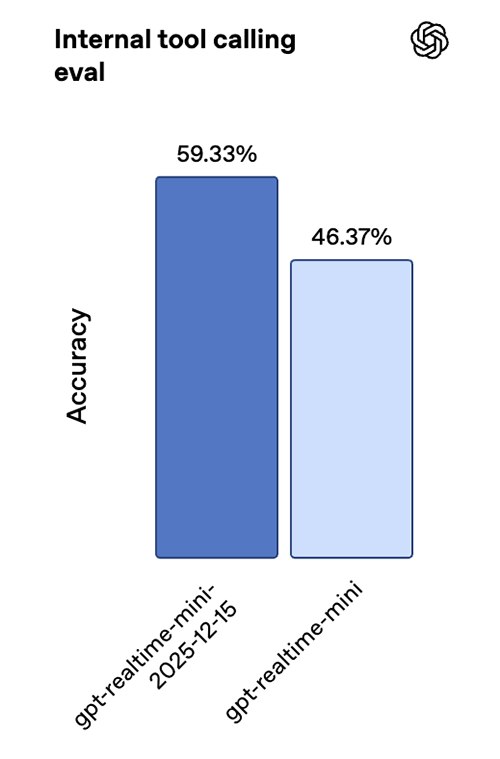
これらの改善により、低レイテンシが求められるリアルタイムの対話でも、複数の手順をより確実に進められ、関数の実行も安定します。
コストをかけてもエージェントの精度を優先したい用途では、引き続き gpt-realtime が最も高い性能を発揮します。一方、コストとレイテンシを最優先する場合は、実際の利用場面でも高い性能を発揮する gpt-realtime-mini が有力な選択肢です。
たとえば、Genspark は、2 言語間の翻訳と、ユーザーの意図に応じて処理を振り分けるタスクで、このモデルのストレステストを実施しました。音声品質が向上したほか、応答はほぼ瞬時で、テンポの速いやり取りでも一貫してユーザーの意図を正確に把握できたと報告しています。
gpt-audio-mini-2025-12-15
gpt-audio-mini は、リアルタイムの対話を必要としない音声変換に、Chat Completions API と組み合わせて利用できます。
どちらの新しいスナップショットも、デコーダーの改良により、さらに自然な声を生成できるようになりました。Custom Voices を使う場合も、声の一貫性が向上しています。
音声合成
最新の音声合成モデル gpt-4o-mini-tts-2025-12-15 では精度が大幅に向上し、標準的な音声ベンチマーク全般で、前世代のモデルよりも単語誤り率が大きく低下しました。Common Voice と FLEURS では単語誤り率(WER)が約 35% 低下し、Multilingual LibriSpeech でも一貫して改善が見られました。
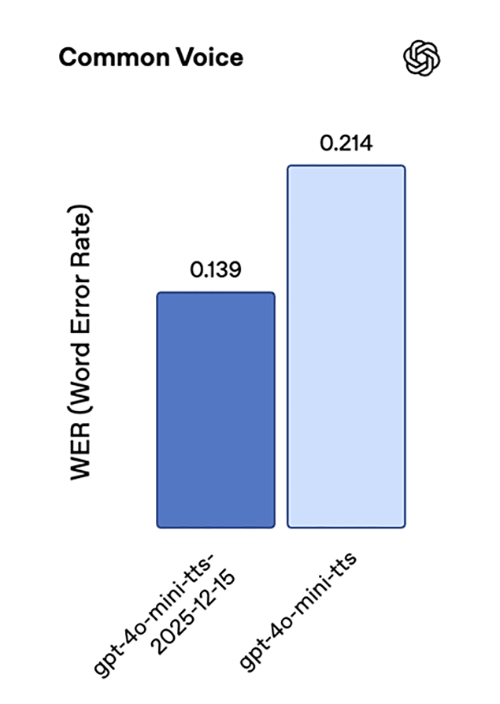
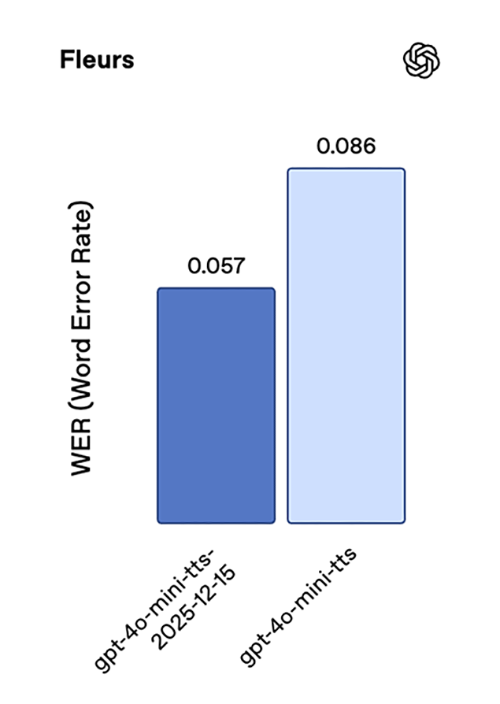
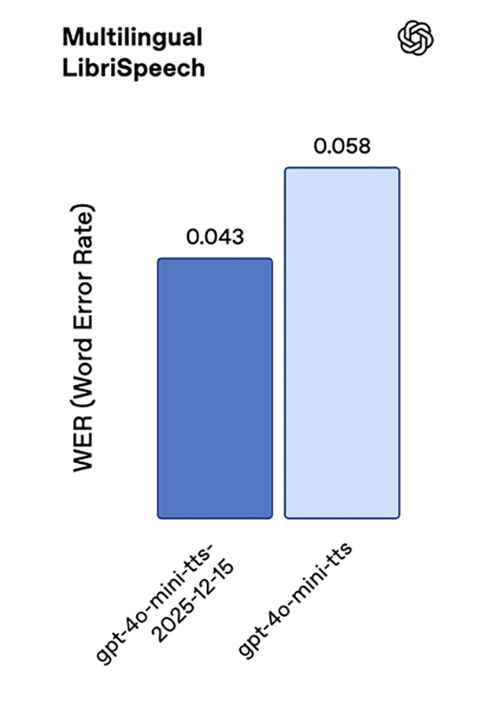
これらの結果は、幅広い言語で発音の精度と安定性が向上したことを示しています。
gpt-realtime-mini の新しいスナップショットと同様に、このモデルでも声が格段に自然になり、Custom Voices を使う場合の性能も向上しました。
音声のテキスト化
最新の文字起こしモデル gpt-4o-mini-transcribe-2025-12-15 では、精度と信頼性がともに大きく向上しました。Common Voice や FLEURS などの標準的な自動音声認識ベンチマークでは、言語を事前に指定しない条件で、従来モデルよりも低い単語誤り率を記録しました。ユーザーの発話が短い場合や周囲が騒がしい場合など、実際の会話環境での動作を重視して最適化しています。社内では、雑音下のハルシネーションを評価するため、実環境の背景雑音を収録したクリップと、無音区間を含むさまざまな発話間隔の音声を再生しました。ハルシネーションの発生件数は、Whisper v2 と比べて約 90%、従来の GPT-4o-transcribe モデルと比べて約 70% 減少しました。
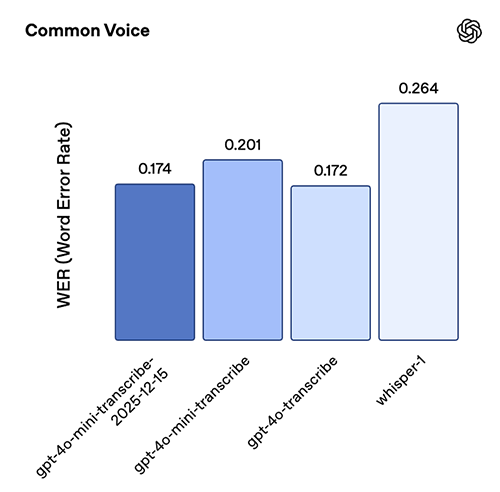
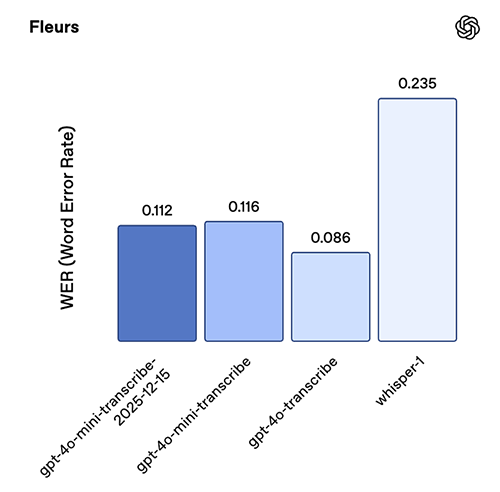
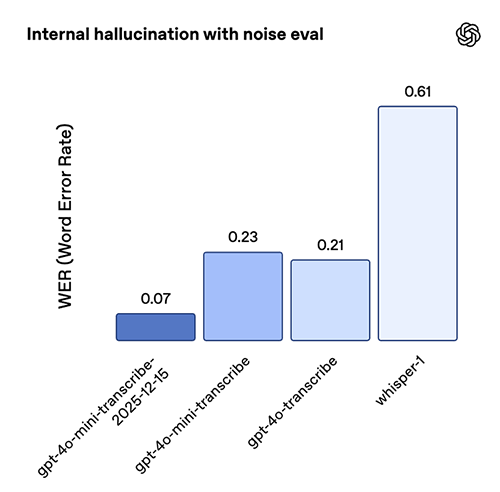
このスナップショットは、中国語(標準中国語)、ヒンディー語、ベンガル語、日本語、インドネシア語、イタリア語で特に高い性能を発揮します。
Custom Voices
Custom Voices を使うと、企業はブランド独自の声で顧客とやり取りできます。カスタマーサポート用のエージェントにも、ブランドのアバターにも、OpenAI のカスタム音声技術を使えば、個性のあるリアルな声を簡単に作成できます。
新しい音声変換モデルと音声合成モデルでは、カスタム音声の声色がより自然になり、元の音声サンプルの特徴をより忠実に再現できるようになりました。さまざまな方言での精度も向上しています。
この技術を安全に利用していただくため、Custom Voices の提供は利用条件を満たすお客様に限定しています。詳しくは、貴社のアカウント担当者または営業チームにお問い合わせください。
プロトタイプから本番運用へ
音声アプリでは、会話が長く続くときや無音などの例外的な状況に加え、音声エージェントがツールを正確に操作する必要がある場面で問題が起きやすくなります。今回の更新ではこうした場面を重点的に改善し、誤り率とハルシネーションの発生件数を減らしました。ツールの使用も安定し、指示により正確に従えるようになりました。さらに、出力音声の安定性も高めたことで、ユーザーにとってより自然に聞こえる音声を提供できます。
現在、音声機能を提供している場合は、新しい 2025-12-15 スナップショットに切り替え、本番環境向けの主要なテストケースを再実行することをおすすめします。
先行テストでは、モデルへの指示を変更せず、新しいスナップショットに切り替えるだけで明らかな改善が確認されています。実際に利用する場面に合わせてテストし、必要に応じてプロンプトを調整してください。